
 语音小管家
大家好,欢迎来到「AudioCC交我学」专栏!
作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。我们将用通俗易懂的语言拆解复杂理论,用数据与实验结果验证技术价值,带你快速了解最新、最有趣的学术论文,打破学术与大众之间的壁垒,让你在碎片化的时间里也能 get 到前沿知识!
在当今快速发展的工业4.0时代,异常检测技术正在工业、交通、矿业等关键领域扮演着越来越重要的角色。以制造业为例,全球每年因设备故障导致的直接经济损失高达数千亿美元,而有效的异常检测系统能够提前预警潜在故障,大幅降低维护成本。其中,时间序列的异常检测由于其部署成本低,适应性强等原因受到了广泛关注。声音异常检测和时间序列异常检测作为其中的两大分支,近年来在算法和应用层面取得了显著突破。本文将聚焦近期ICASSP,ICLR等顶会的最新研究成果,带您一览领域内的前沿进展与技术亮点。
一、声音异常检测——如何让机器“听”出问题?
1. 声音异常检测的挑战
在现实场景中,机器“听”声音并判断是否异常并不容易,主要面临三大难题:1.数据稀缺:异常声音样本少,比如工厂设备故障的声音可能几个月才出现一次。2.数据质量差:背景噪声大(如车间环境)、采样率不一致,甚至很多数据没有标注。3.异常多样性:不同设备、不同故障类型的声音差异很大,难以用统一规则检测。
2. 最新解决方案
通用表征学习:让模型适应不同场景
发表在ICASSP 2025的Deep Generic Representations for Domain-Generalized Anomalous Sound Detection中,作者提出了一种跨领域异常检测方法,核心思路是:
1.使用预训练模型(BEATs):先让模型在大量正常声音数据上学习通用特征,通过大量的不同场景音频数据提高模型的泛化性能。
2.域适应技术:在预训练模型的基础上,作者还提出了三个方法来解决域适应性的问题:MemMixup:把目标数据(新场景的声音)和已知数据混合,增强泛化能力;域归一化:对不同设备采集的数据做标准化,减少分布差异的影响;时间池化:对长时间录音做压缩,提取关键特征,降低计算量。
结果:在声音异常检测具有代表性的DCASE2023数据集上,作者取得了平均AUC分数73.79的结果,超越了当时的其他参赛队伍。
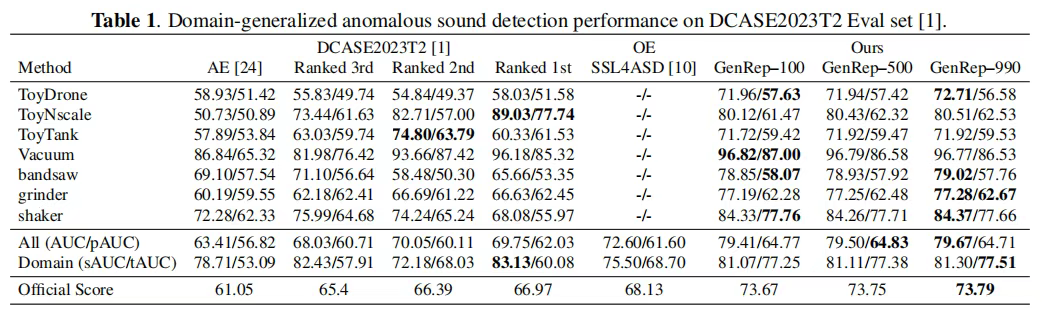
图 1 实验结果
多分辨率频谱+三元组学习:提升特征判别力
同样发表在ICASSP2025的论文Improvements of Discriminative Feature Space Training for Anomalous Sound Detection中,作者采用多分辨率频谱图(STFT尺寸256/1024/4096)和子空间损失(Subspace Loss),替代传统复杂模型。此外,引入外部预训练模型(如PANNs)和三元组学习(Triplet Learning),显著提升了单设备类型的检测精度。
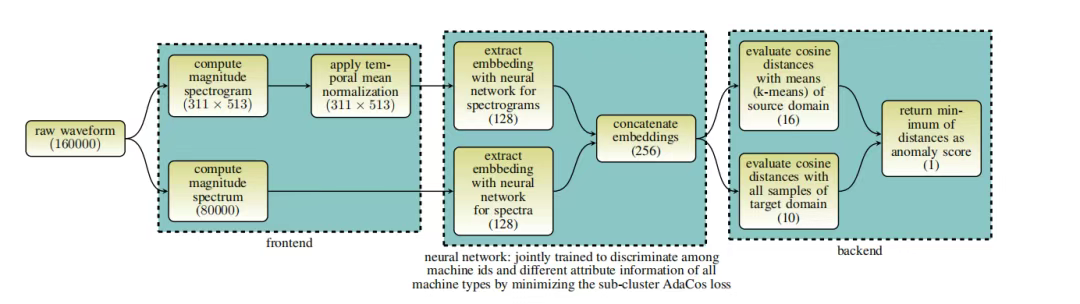
图 2 作者使用的骨干网络
三元组学习(Triplet Learning):通过人为构造异常,让模型学会区分“正常声音”,“轻微异常”和“严重异常”,提高对相似声音的辨别能力。
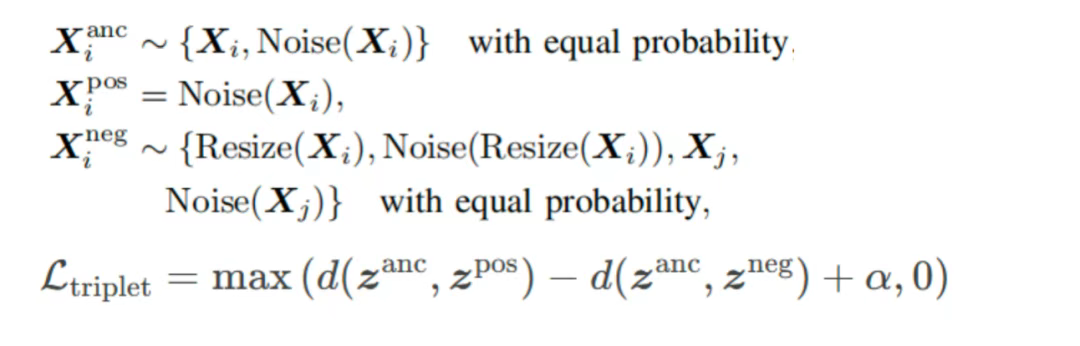
图 3 三元组学习计算方法
实验结果:作者在DCASE2023和2024数据集上对比的多个预训练模型,实验表明,作者的方法大幅提高了性能,并且具有一定的鲁棒性。
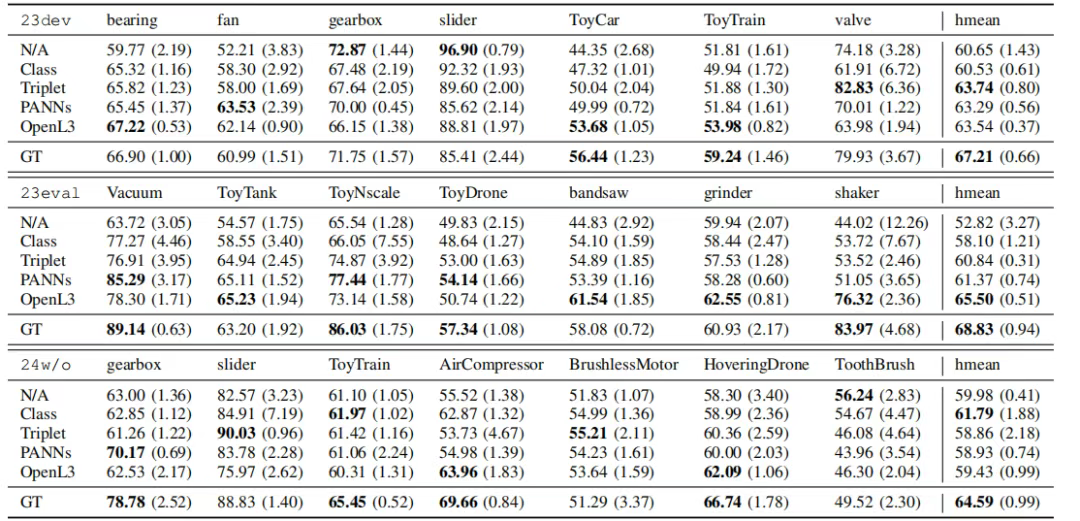
图 4 实验结果
二、时间序列异常检测——如何从数据流中发现异常?
1. 时间序列数据的特殊性
时间序列数据(如传感器读数、服务器流量)的特点是:前后关联性强:当前值受历史值影响(比如温度缓慢上升可能是故障征兆);异常模式多样:可能是突发的峰值(如网络攻击)、缓慢漂移(如设备老化),甚至是周期性变化(如服务器负载异常)。
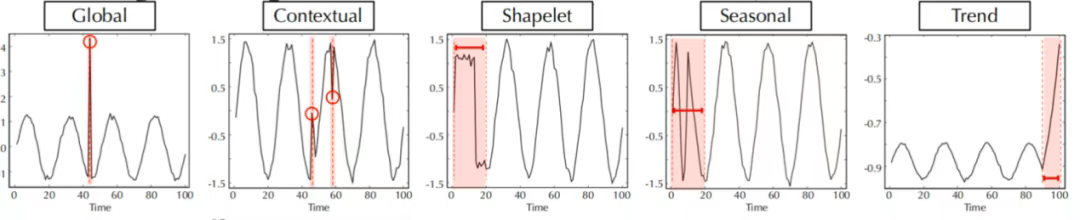
图 5 不同时序异常类型
2. 前沿工作介绍
Anomaly Transformer(ICLR 2022)
传统时序建模方法在处理复杂系统动态特性时存在显著局限。Anomaly Transformer通过建立双路径注意力机制,实现了对时间序列多尺度特征的精准建模:
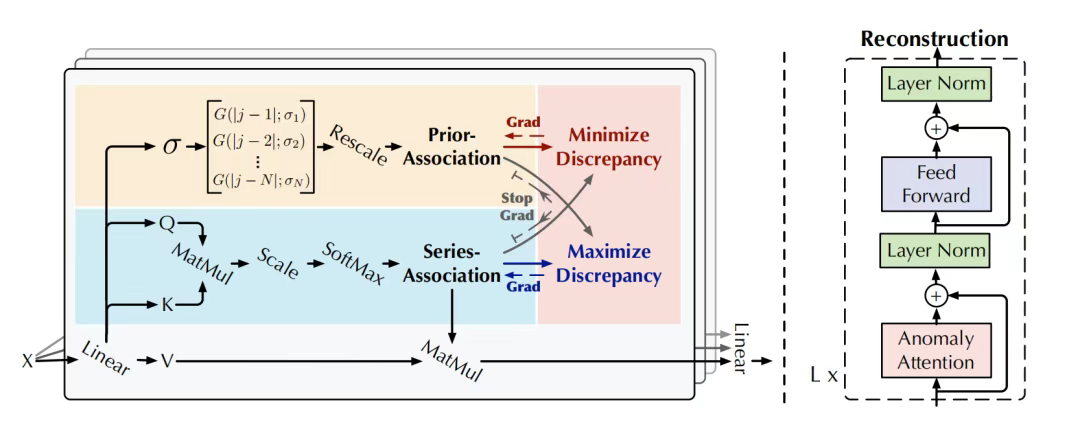
图 6 Anomaly Transformer架构
核心创新点:关联差异机制(Association Discrepancy):前向关联:建立局部时序依赖模型;反向关联:捕获全局上下文特征。
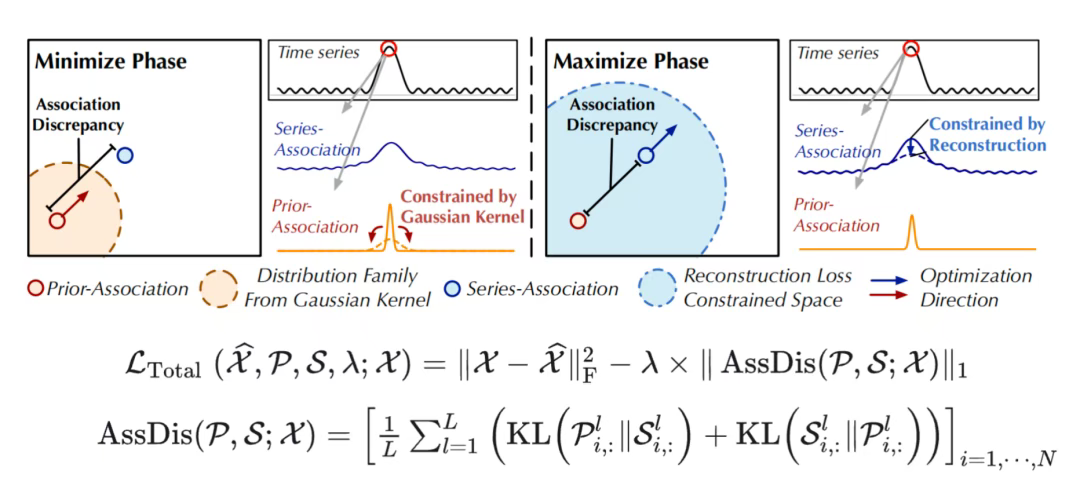
图 7 前后向关联示意图
实验结果:根据作者的实验,该架构在UCR基准测试中取得了0.923的F1值,对渐进式异常的检测灵敏度较LSTM-AE提升42%,在1000点序列长度下保持25ms的推理时延。在保证检测效果的同时依然能够保证极小的检测时延。
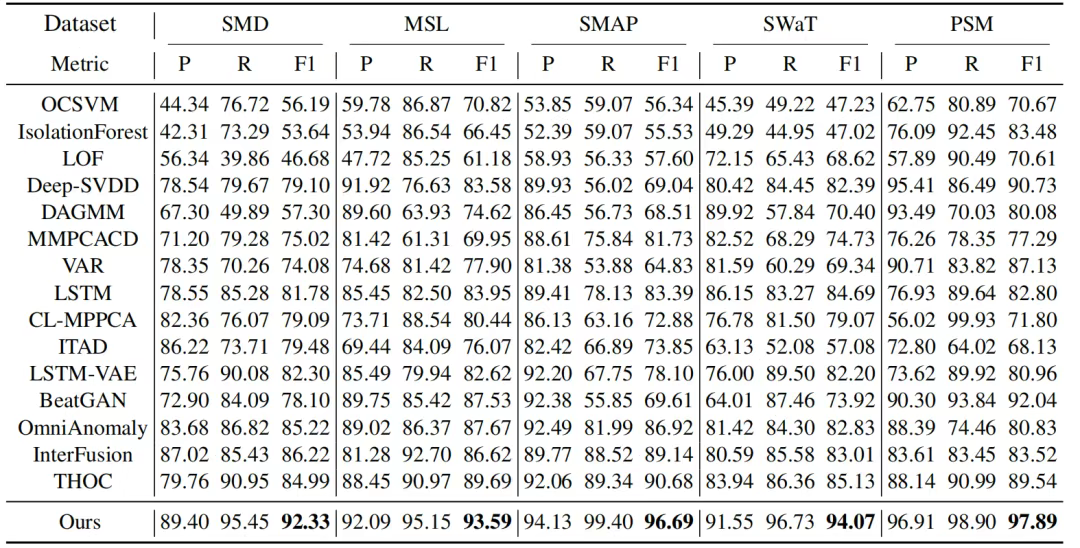
图 8 Anomaly Transformer实验结果
DADA(ICLR 2025):动态自适应异常检测架构
在数字化转型的浪潮下,能够适应不同场景的通用型异常检测技术需求日益迫切。传统的异常检测模型并不能很好的处理不同采样率的数据。DADA架构正是针对这一需求而设计,其创新之处主要体现在两个方面:自适应瓶颈层和对抗训练范式。
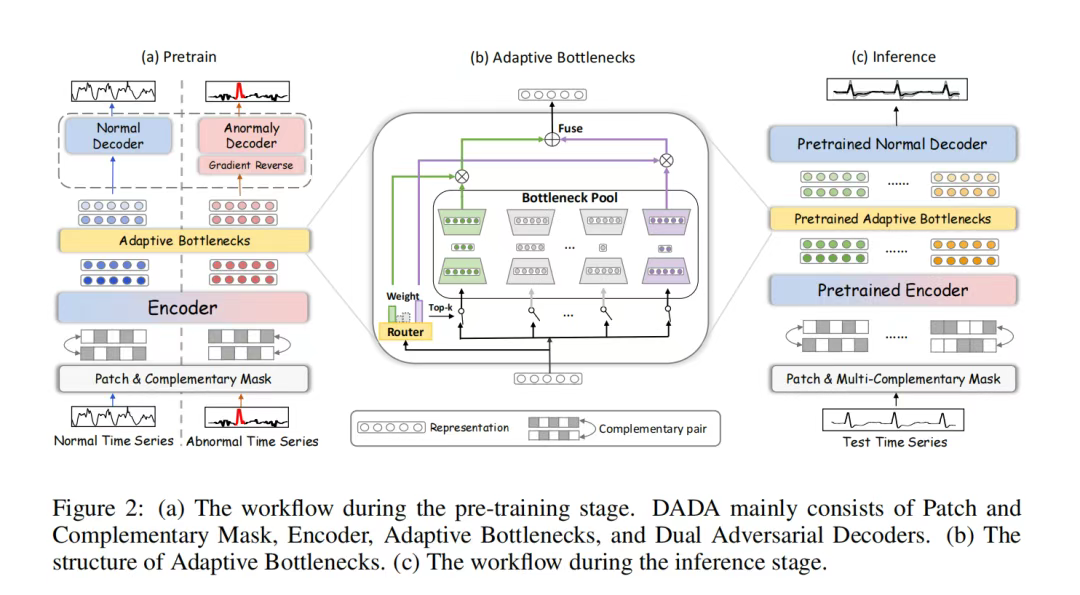
图 9 DADA模型结构
1. 自适应瓶颈层(AdaBN):自适应瓶颈层的设计借鉴了混合专家系统的思想,但进行了重要改进。通过softmax计算的路由权重,能够根据输入数据的特性自动选择最合适的处理路径。这种机制使得单个模型可以同时处理采样率从1Hz到1kHz不等的各类传感器数据。
2. 对抗训练范式:对抗训练范式的设计包含两部分:正常解码器以最小化L1重构误差为目标,异常解码器则通过梯度反转层追求最大化差异,二者通过min-max优化目标达成平衡。
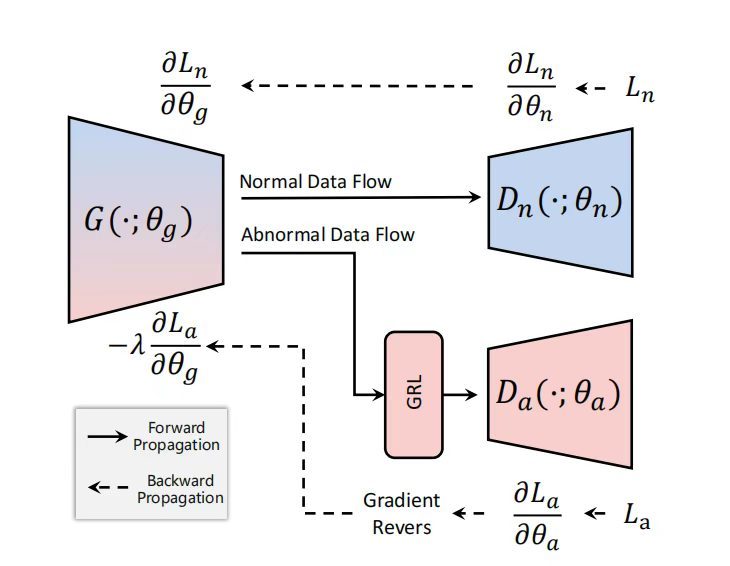
图 10 对抗训练示意图
实验结果:作者实验表明,在多个异常检测数据集上都取得了新的最佳结果,在SWaT、WADI和NASA Turbofan数据集上分别取得0.952、0.931和0.968的AUROC值,误报率控制在2.1%以内。同时该模型还支持动态批处理。
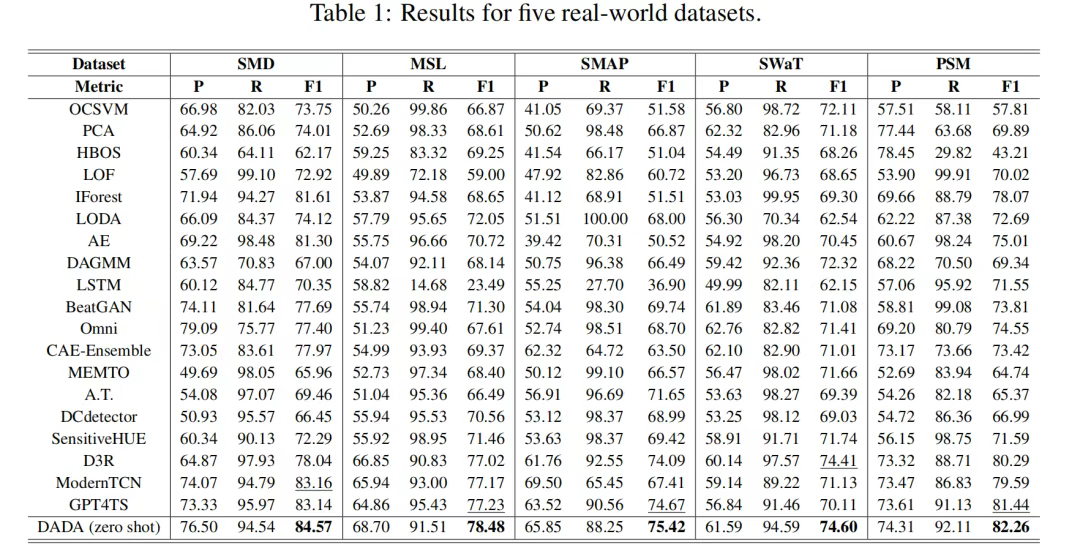
图 11 DADA实验结果
三、总结与展望
近年来,声音异常检测和时间序列异常检测领域取得了显著进展,核心突破集中在两大方向:一是通过预训练、域适应和记忆机制等技术提升模型的跨场景适应能力,让算法在数据稀缺或噪声干扰下仍能稳定工作;二是利用多分辨率分析、对比学习和动态调整策略,实现对细微异常的精准捕捉。这些创新为工业运维、医疗监测、网络安全等领域提供了更智能的解决方案。
展望未来,随着自监督学习和边缘计算的发展,异常检测技术将朝着更自动化、更轻量化的方向演进:无监督学习有望减少对标注数据的依赖,而轻量级模型部署将推动实时检测在终端设备的普及。我们期待这些技术能进一步降低运维成本,让异常检测成为各行各业智能化升级的“安全卫士”。
四、思考与讨论
你在工作中是否遇到过异常检测的挑战?无论是机器异响、数据波动还是系统故障,欢迎分享你的经历和需求
