
 语音小管家
近年来,以 Whisper 为代表的语音基础模型显著提升了多语种自动语音识别(Automatic Speech Recognition, ASR)的泛化能力,使同一模型能够覆盖多种语言、口音和语音场景。然而,当模型需要继续适配低资源语言、儿童语音、方言或特定录音环境时,传统全参数微调仍面临三个突出问题:一是训练和存储成本高;二是在数据有限时容易过拟合;三是新语言或新域的梯度可能破坏原有的多语种知识,造成语言间干扰和灾难性遗忘。
低秩适配(Low-Rank Adaptation, LoRA)为这一问题提供了参数高效的解决思路。它冻结预训练权重,只训练一个低秩增量,使模型能够以较少参数完成任务适配[1]。但对于多语种 ASR 而言,“较少训练参数”并不等于“有效使用参数”。同样的秩分配到所有层,可能导致关键层容量不足、非关键层预算浪费;不同语言共用同一更新空间,可能引入相互干扰;将适配器放在所有候选位置,又可能在低资源条件下放大噪声。因此,LoRA 只是一个低秩接口,真正决定适配效果的是有限自由度应当分配到哪里、以什么子空间开始、由哪些语言或层共享,以及如何针对声学域偏移施加结构约束。
本文按照“通用领域参数高效微调方法——多语种低资源 ASR 专用适配方法”的路线展开。经典工作如AdaLoRA 关注秩预算如何动态分配,PiSSA 关注低秩更新应从何种奇异子空间开始;LoRA-Whisper 将语言差异组织为可扩展的独立模块,DAMA 从结构先验驱动的深度分配出发,SSVD 则将声学域偏移建模为奇异空间中的旋转和缩放,SSVD-O则在此基础上进一步引入输出侧的受约束外变换,将单侧的输入奇异空间适配扩展为输入—输出奇异子空间的协同变换,以在增强目标域适应能力的同时尽量保持原模型的语义知识,并缓解灾难性遗忘。这些工作展现了一条清晰的技术演进主线:参数高效微调正在从“统一、固定的 LoRA设计”走向“面向下游任务的结构化 LoRA”。
一、LoRA 基础:从全参数更新到低维空间适配
1. 原始 LoRA 做了什么
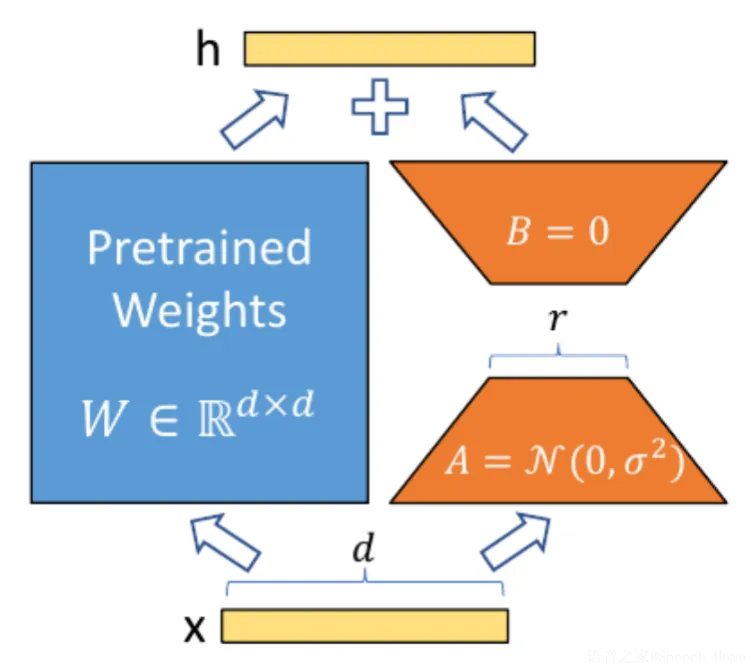
图1 LoRA 的基本参数化: 冻结 W,仅学习低秩增量 BA
如图 1 所示,对于预训练权重矩阵 W,LoRA 将适配后的权重写为:
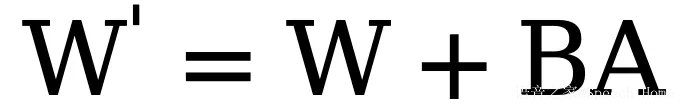
其中 A 和 B 是可训练的小矩阵,中间维度 r 即低秩适配的秩。由于 r 远小于 W 的输入和输出维度,训练参数量显著降低。训练过程中原始权重 W 保持冻结,推理时则可以将 BA 合并回 W,因此通常不需要引入额外的复杂推理路径。如表 1 所示,论文中从可训练参数量和下游任务性能两方面展示了 LoRA 的参数效率,表明 LoRA 在多种任务上能够以极少的可训练参数达到与全参数微调相当甚至更优的性能。
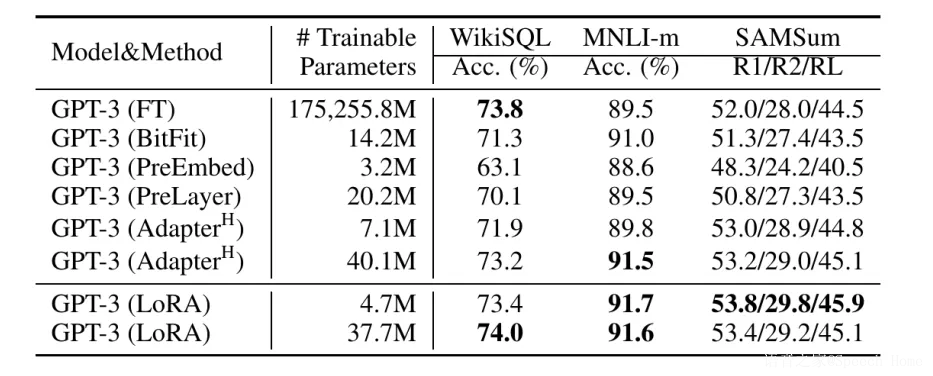
表1 LoRA 的实验结果:在较少可训练参数下接近全参数微调效果
秩的大小决定了适配器能够表达的独立更新方向数量。秩过小可能使模型无法充分适配新语言或新域;秩过大则会增加参数与计算量,并在少量标注数据上提高过拟合风险。LoRA 通常被插入 Transformer 的注意力投影或前馈网络线性层。在 Whisper 这类编码器—解码器模型中,插入位置还具有明确的功能差异:编码器侧更接近声学特征和语音表征,解码器侧则更多涉及语言建模与文本生成[7]。
因此,原始 LoRA 仍留下五类关键问题:
- 不同层是否应使用相同的秩;
- 适配器应随机初始化还是利用预训练权重结构;
- 不同语言应共享还是隔离适配参数;
- 哪些层和投影位置最值得更新;
- 面对声学域偏移时,增量更新应遵循什么几何结构。
后续方法正是围绕这些问题逐步为 LoRA 加入结构先验。
2. 低资源 ASR 的三个结构性难点
把 LoRA 放进多语种 ASR 后,会出现下面三个结构性问题:
- 参数预算放错层不同层、不同投影对目标任务的贡献并不相同,统一秩可能让关键层不够用,也可能把预算浪费在非关键层。
- 语言更新既要共享又要隔离共享骨干有利于复用跨语言知识,但让所有语言共用同一个增量空间,又容易产生梯度干扰和灾难性遗忘。
- 声学变了,语义不一定改变儿童语音、方言或设备变化主要改变输入声学分布;如果更新没有区分输入侧和输出侧,模型可能为了适配声音而破坏原有文本语义。
下面的几项工作,分别从预算、初始化、语言路由、层级先验以及输入—输出几何五个角度回答这些问题。
二、通用LoRA变体
AdaLoRA:将固定秩改写为全局预算分配
1. 问题与动机
普通 LoRA 往往为所有适配矩阵设置相同的秩,这相当于假设所有层、所有投影和所有任务位置同等重要。AdaLoRA(Zhang et al., 2023)把问题改写成一个更直接的问法:如果总预算固定,哪些秩单元值得留下?重要矩阵如果秩不足会缺少表达能力,不重要矩阵如果分到太多秩又会占用预算并引入噪声[2]。
2. 机制:先探索,再裁剪
如图 2 所示,在参数化方面,AdaLoRA 将低秩增量组织为类似奇异值分解的 PΛQ 形式,使每个奇异值及其对应的左右方向构成一个可独立评估和裁剪的“秩单元”。模型利用敏感度和不确定性共同估计秩单元的重要性,并通过移动平均减小单步梯度波动造成的误判;同时对左右方向施加正交约束,减少不同秩通道学习重复信息。训练早期,预算调度器保留较大的候选秩空间用于探索;训练中期逐步裁剪低重要性单元;训练后期固定最终预算并在保留结构上继续优化。最终,不同层和矩阵获得非均匀的秩分布。
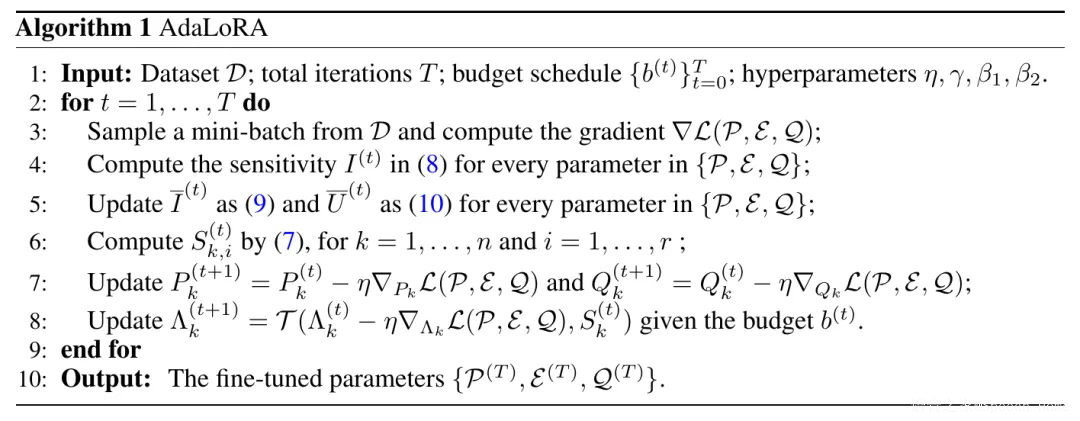
图2 AdaLoRA 的核心机制: 对秩通道评分并裁剪低重要性单元
3. 实验与结果
如表 2 所示,实验主要在 DeBERTaV3-base、GLUE 和 SQuAD 等文本任务上进行。在相近甚至更低的可训练参数预算下,AdaLoRA 整体上优于普通 LoRA 和多种适配器基线。该结果说明,自适应分配比平均分配更能提高参数的有效容量。不过,AdaLoRA 的重要性评分依赖训练数据和梯度统计,在极低资源或高噪声条件下可能不够稳定,这也为后续采用显式深度先验的方法留下了空间。
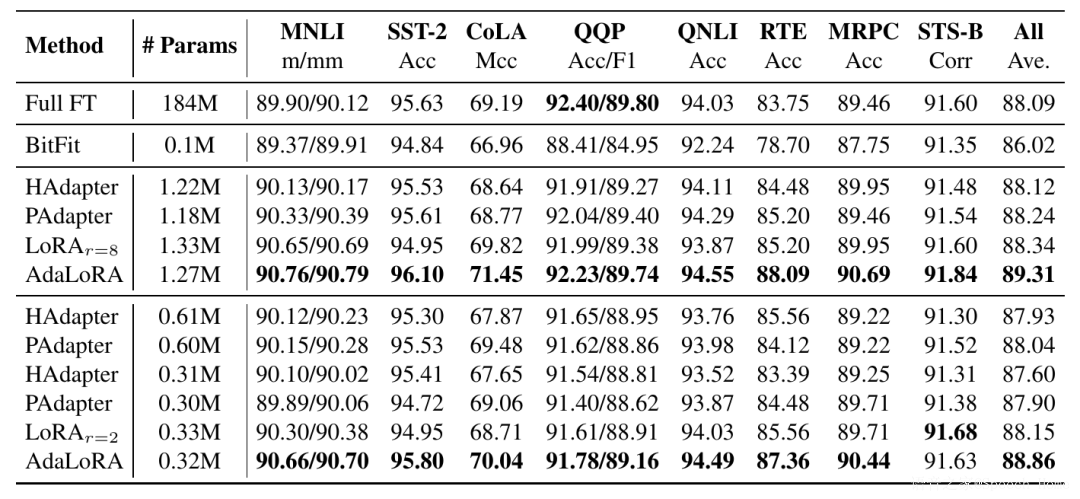
表2 AdaLoRA 的实验观察: 最终秩分布非均匀,预算随任务重新分配
4. 不足
AdaLoRA 的重要性评分依赖训练数据和梯度统计。在极低资源或高噪声条件下,统计量本身可能不稳定;而且它主要在文本任务中验证,不能直接推出它在多语种 ASR 上必然占优。它对本文主线的价值更像是一个问题重述:秩不是固定超参数,而是需要被分配的预算。
PiSSA:从预训练权重的主奇异子空间开始
1. 问题与动机
PiSSA(Meng et al., 2024)关注另一个问题:低秩更新应从哪里开始[3]。普通 LoRA 通常随机初始化一个矩阵、将另一个矩阵初始化为零,以保证训练开始时不改变原模型输出。该策略虽然安全,却没有利用预训练权重已经形成的结构。
2. 机制:把预训练权重的主成分变成优化起点
如图 3 所示,PiSSA 对权重矩阵 W 进行奇异值分解,将较大的奇异值及其左右奇异向量视为主成分,并用这些主奇异成分初始化可训练的低秩参数;其余残差成分则作为冻结基座保留。这样,初始组合权重仍与原模型一致,但适配器从更有信息量的主子空间出发,而不是在随机方向中重新搜索。
该设计带来两方面优势。首先,主奇异方向通常承载预训练模型较强的线性映射能力,因此优化起点更好、前期收敛更快。其次,在量化微调中,移除主成分后的残差矩阵数值分布更集中,对残差部分进行低比特量化能够减小初始量化误差。为控制初始化成本,PiSSA 采用快速或迭代式 SVD 近似提取前 r 个方向,并可与 4-bit 量化形成 QPiSSA。
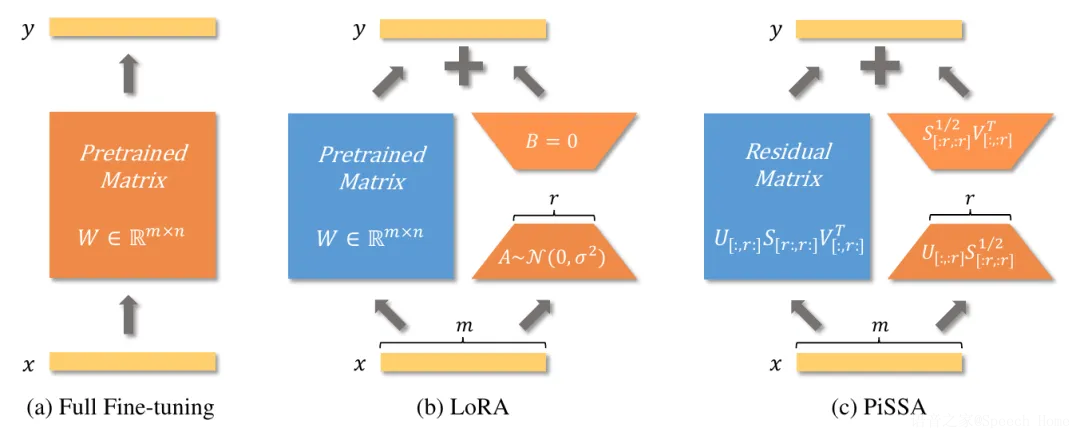
图3 PiSSA 模型:从权重 SVD 的主奇异子空间初始化可训练部分
3. 实验与结果
如表 3 所示,PiSSA 在 LLaMA 2、Mistral、Gemma 等模型的数学推理、代码生成、对话评价任务,以及 DeBERTa-v3-base 的 GLUE 任务上进行了验证。PiSSA 在 8 个自然语言理解任务中的 7 个上超过普通 LoRA,平均提升约 1.21%。但这些结果主要来自文本模型,不能直接推出 PiSSA 在 ASR 任务上必然占优。它对本文主线更重要的意义是提出了一个可迁移原则:低秩适配不仅需要控制参数数量,还应考虑预训练权重的奇异子空间与几何起点。
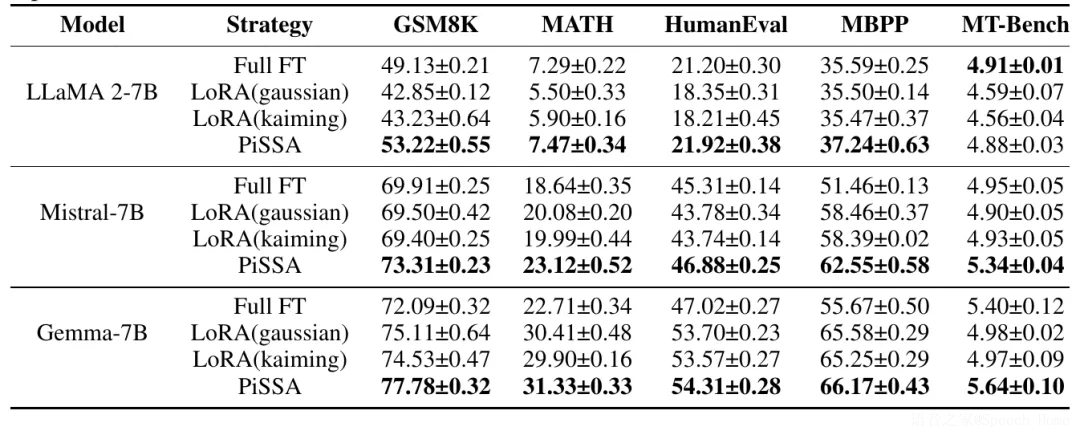
表3 PiSSA 实验结果:更快优化、更好的子空间对齐与更低量化误差
4. 不足
这些结果主要来自文本模型,不能直接推出 PiSSA 在 ASR 任务上必然占优。更稳妥的迁移结论是:低秩适配不只是控制参数数量,还要考虑预训练权重的奇异子空间与几何起点。到了语音任务,哪些奇异方向真正对应声学变化,仍需要目标域实验回答。
三、面向多语种、低资源场景 ASR 的结构化适配
LoRA-Whisper: 共享骨干与语言专属模块
1. 问题与动机
LoRA-Whisper(Song et al., 2024)面对的是多语种 ASR 持续扩展的实际场景[4]。如果把多种语言混合进行全参数微调,不同语言的梯度会共同修改同一组参数,语言间干扰随之出现;如果为每种语言单独保存完整模型,训练和部署成本又难以接受。这里的关键问题不是“要不要共享”,而是共享哪些知识、隔离哪些更新。
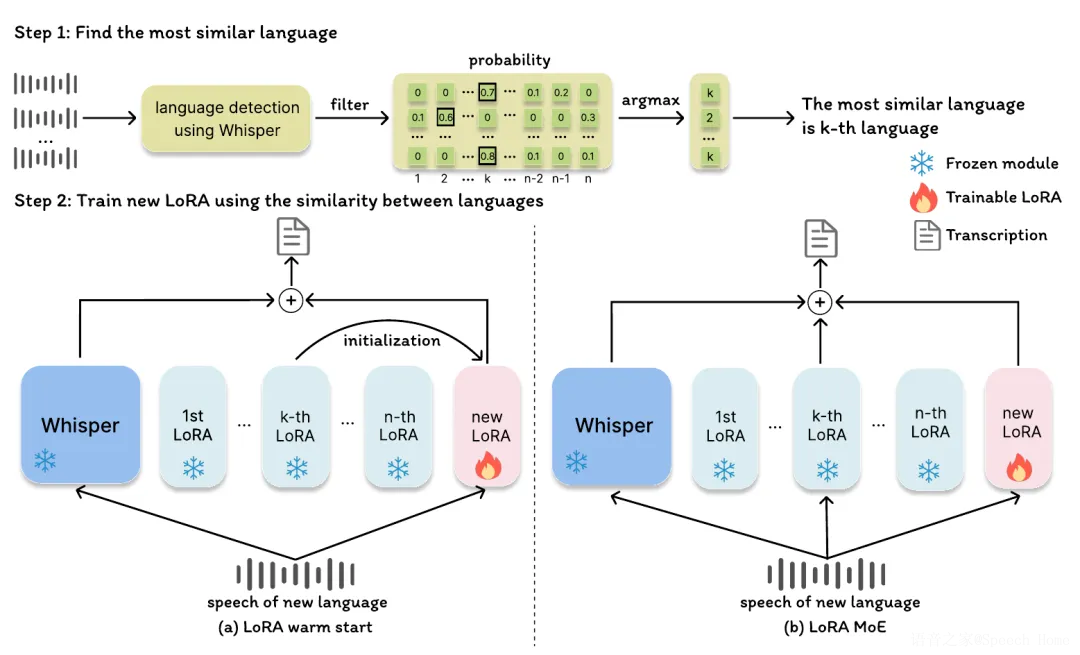
图4 LoRA-Whisper 架构:共享 Whisper 与可插拔语言专属 LoRA
2. 机制: 共享骨干,语言专属适配器
如图 4 所示,该方法冻结共享的 Whisper 编码器—解码器骨干,为每种语言配置一组独立 LoRA 模块。训练某种语言时,仅更新对应适配器,其他语言模块和骨干保持不变。LoRA 模块同时作用于编码器和解码器中的注意力及全连接投影,覆盖声学表征与语言建模两类差异。
系统加入新语言时,还可以利用 Whisper 的语言检测概率估计相似性:一种策略是使用最相似语言的 LoRA 参数热启动;另一种策略是把适配器组织成类似混合专家的模块库,组合多个相关语言模块。语言相似性由此从“混合全部训练数据”变成了可控的初始化或路由机制。
3. 实验与结果
如表 4 所示,在 Whisper-small、MLS 和 FLEURS 上的实验中,四种基础语言的原始模型平均错误率约为 13.60%,多语种全参数微调为 11.68;LoRA-Whisper 仅训练约 13M×4 的语言适配参数,平均错误率达到 9.52%,接近每种语言分别训练约 240M 参数的单语言模型。在新语言扩展实验中,直接全参数微调虽然能改善新语言,却使基础语言平均错误率恶化至 32.29%;语言专属 LoRA 则将基础语言保持在 9.52%,并通过热启动或混合专家将新语言平均错误率进一步降至约 21.8%。其优势因此不只是省参数,更在于将新增语言与旧语言能力解耦。局限在于语言数量增加时适配器库会持续扩张,并且系统依赖可靠的语言识别、相似性估计和路由策略。
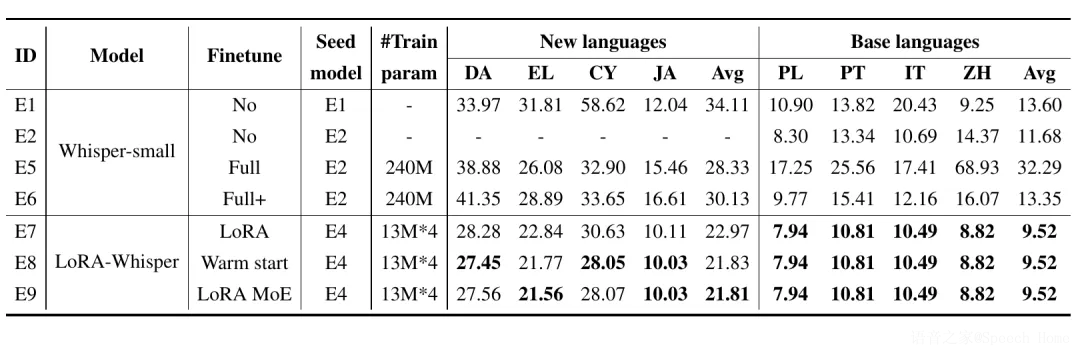
表4 LoRA-Whisper 实验:基础语言适配、新语言扩展及参数量对比
4. 不足
适配器库会随着语言数量持续扩张,系统还依赖可靠的语言识别、相似性估计和路由策略。语言专属模块解决了“谁更新”的问题,却没有自动解决“模块应该放在哪一层、秩该多大”的问题。
DAMA:利用解码器深度先验保护共享语义层
1. 问题与动机
DAMA(Xiao et al., 2026)进一步追问:多语种 ASR 解码器的不同深度是否具有稳定的适配规律[5]。逐层探测结果显示,解码器的可塑性呈 U 形分布:早期层和晚期层更容易体现语言相关变化,中间层相对稳定,形成承载跨语言共享信息的“语义谷”。如果在所有层使用统一秩,或者完全依靠极少数据动态估计重要性,中间层可能被过度修改,从而损害预训练模型的共享语义表示。
2. 机制:利用解码器深度先验保护共享语义层
DAMA 设计了三项相互配合的机制。如图 5 所示,第一,采用高—低—高的深度感知秩调度,为早期和晚期层分配较高秩,为中间层分配较低秩,使语言敏感区域具有足够可塑性,同时限制共享语义区域的更新幅度。第二,在中间层采用基于 SVD 的初始化,减小随机低秩方向引入的几何噪声。第三,引入 Basis-Protected Projection,在中间层冻结 LoRA 的输入投影基,仅更新另一侧映射,使模型能够在受保护的低维空间内微调,而不轻易改变共享表示的基础坐标。
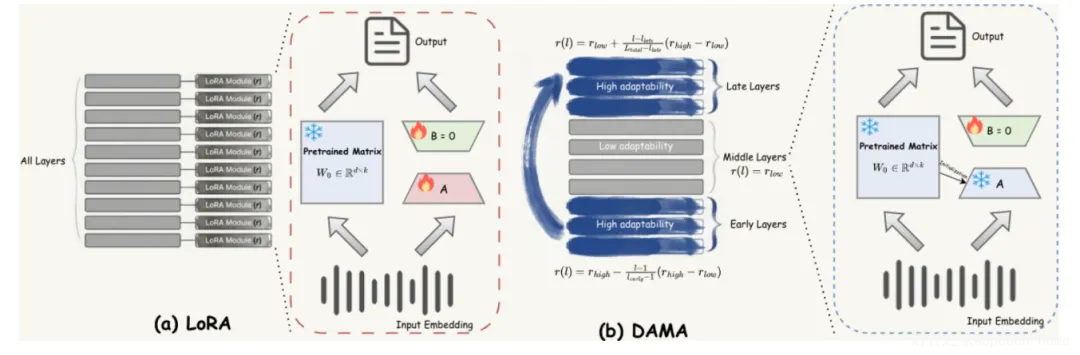
图5 DAMA 完整框架:深度感知秩、SVD 初始化与基底保护
3. 实验结果
如表5所示,在 Common Voice、FLEURS 和 Whisper large-v2 上,DAMA 以约 14.9M 可训练参数取得 39.73% 的平均 WER,与普通 LoRA 使用 68.2M 参数得到的 39.71% 基本相当;其额外计算量从 LoRA 的 102.2G MACs 降至 22.3G。在 Common Voice 仅 0.5 小时数据时,DAMA 的平均 WER 为 64.11%,优于普通 LoRA 的 64.84 和全参数微调的 68.11%。该方法说明,极低资源条件下可解释的深度先验可以比不稳定的全数据驱动分配更可靠。与此同时,U 形规律能否迁移到不同模型架构、编码器层或更复杂的语言组合,仍需进一步验证。
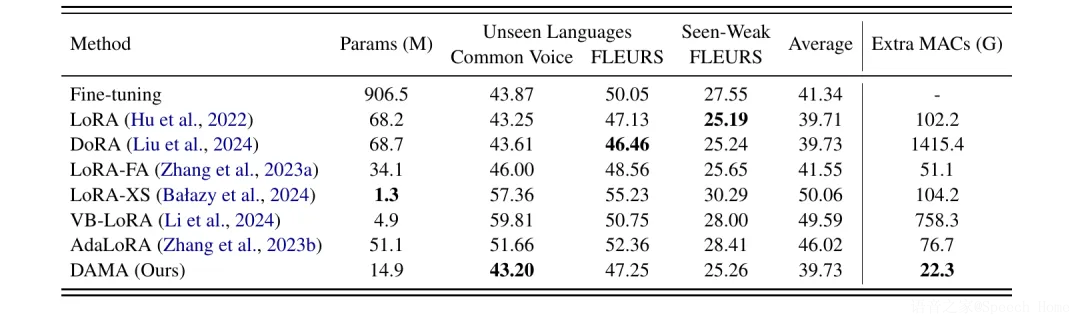
表5 DAMA 实验结果:在 Common Voice/FLEURS 上的 WER、参数量与计算量比较
4. 不足
DAMA 的结果说明,极低资源条件下可解释的深度先验可能比不稳定的全数据驱动分配更可靠。但 U 形规律能否迁移到不同模型架构、编码器层或更复杂的语言组合,仍需进一步验证;它也主要回答“哪些层更值得更新”,没有直接处理声学域偏移的输入—输出几何问题。
SSVD:用输入侧旋转和缩放建模声学域偏移
1. 问题与动机
SSVD(Wang et al., 2025)针对儿童语音、方言语音等声学域偏移场景[6]。同一句话由成人与儿童朗读时,输出文字和语义目标并未改变,但共振峰、语速和发音方式等输入声学分布会发生变化。普通 LoRA 学习自由的低秩增量,却没有区分输入侧变化与输出侧语义。SSVD 因此提出一个更强的假设:域偏移主要需要重新对齐输入侧几何,而输出侧表示应尽量保留。
2. 机制:旋转与缩放输入奇异空间
具体而言,如图 6 所示,SSVD 固定与输出空间相关的左奇异方向,学习右奇异空间中的结构化旋转以及奇异值方向上的缩放。正交旋转负责改变输入坐标系而不过度扭曲其几何结构,奇异值增量则控制各方向的重要性。参数 p 表示参与旋转的右奇异成分比例,可在表达能力和参数量之间进行调节。训练完成后,结构化更新仍可合并回原权重,因此保留了参数高效方法便于部署的特点。
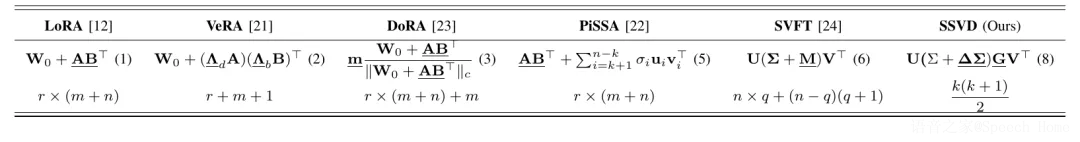
图6 SSVD 模型:保持输出语义侧,结构化旋转和缩放输入奇异空间
3. 实验结果
如图 7 所示,实验覆盖 MyST 儿童语音、CGN 方言/口语数据,以及 OWSM-0.1B、OWSM-1B 和 OWLS-2B 等模型。以 MyST 上的 OWSM-1B 为例,SSVD 在 p = 40% 时使用约 32M 参数取得 13.8% 的 WER,接近全参数微调的 12.4%,并优于参数更多的部分低秩基线;在 OWLS-2B 上,它以约 21.6M 参数取得 14.7% 的 WER。在CGN 上的结果证明,SSVD 以约 31.86M 参数得到 15.4% 的 WER,而普通 LoRA 以约 42.26M 参数得到 15.1%。由此可见,SSVD 并非在所有域上无条件优于 LoRA,其主要价值是在声学变化符合“输入空间旋转与缩放”假设时,以更少参数获得接近或更好的效果;当域变化需要更自由的更新时,LoRA 仍可能具有优势。
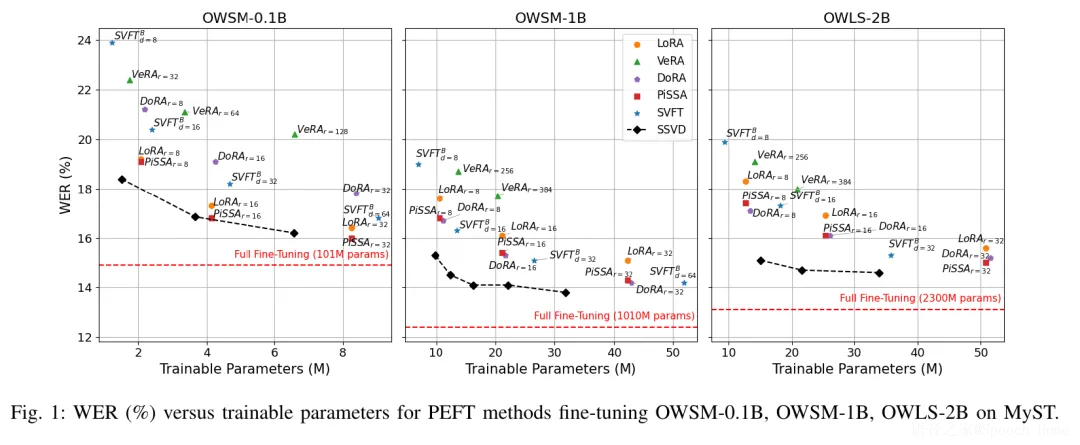
图7 SSVD 实验结果:不同模型规模下的 WER—参数量权衡
4. 不足
SSVD 并非在所有域上无条件优于 LoRA。它的主要价值是在声学变化符合“输入空间旋转与缩放”假设时,以更少参数获得接近或更好的效果;当域变化需要更自由的更新时,普通 LoRA 仍可能具有优势。这里的证据主要属于特定领域ASR,不应直接等同于所有低资源语言扩展任务。
SSVD-O:输入侧 + 输出侧子空间协同适配
1. 问题与动机
SSVD-O(Wang et al., 2026)是 SSVD 的扩展[8]。SSVD 主要更新输入声学侧,但在更复杂的适配任务中,输出空间也可能需要有限的可塑性:儿童语音和区域口音主要改变声学实现,适配过程却可能连带改变原模型已经学到的语义映射。于是问题变成:输入空间和输出空间,哪一侧更值得分配预算?
2. 机制:inner transformation 与 outer transformation
设预训练权重
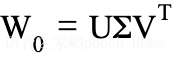
SSVD 在右奇异空间中引入正交旋转 G,并通过

对各奇异方向缩放,得到
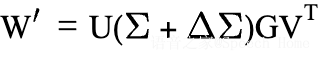
只调整前 k 个奇异分量时,可训练参数量约为 k(k+1) / 2。SSVD-O 进一步利用预训练权重的左奇异向量补空间,引入外变换 Q,将更新写为
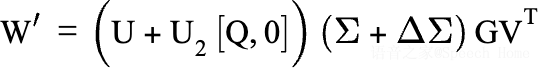
这里可以把两类更新理解成两个方向:与输入声学特征相关的内变化负责重新对齐输入几何;与输出语义特征相关的输出转化提供受约束的输出侧可塑性。Q 通过 Cholesky 参数化约束其列空间近似正交,在增加表达能力的同时尽量不破坏原有语义坐标系。
3. 实验与结果
实验在 ESPnet 中实现,比较 LoRA、DoRA、PiSSA、SSVD 与 SSVD-O,并在 OWSM-0.1B、OWSM-1B 和 OWLS-2B 的全部前馈层上微调。数据包括 MyST 儿童语音(清洗后约 179 小时)和 CGN 荷兰语/弗拉芒语语音(约 341 小时);作者通过改变输入侧适配比例 p 和输出侧秩 l,考察不同预算下的 WER,同时在 LibriSpeech 和 MLS 上测试遗忘程度。
图 8 – 图 11 分析了 SSVD-O 中 inner transformation 与 outer transformation 的参数预算分配效果。实验结果表明,在较小参数预算下,增加输入侧 inner transformation 通常比增加输出侧 outer transformation 更有效,说明输入关联的奇异子空间对儿童语音和区域口音等声学域偏移更为敏感。随着模型规模和可训练参数量增加,outer transformation 的作用逐渐增强,并能够在充分 inner 适配的基础上进一步降低目标域 WER。因此,SSVD-O 更适合采用“低预算优先适配 inner transformation,高预算进一步引入 outer transformation”的参数分配策略。
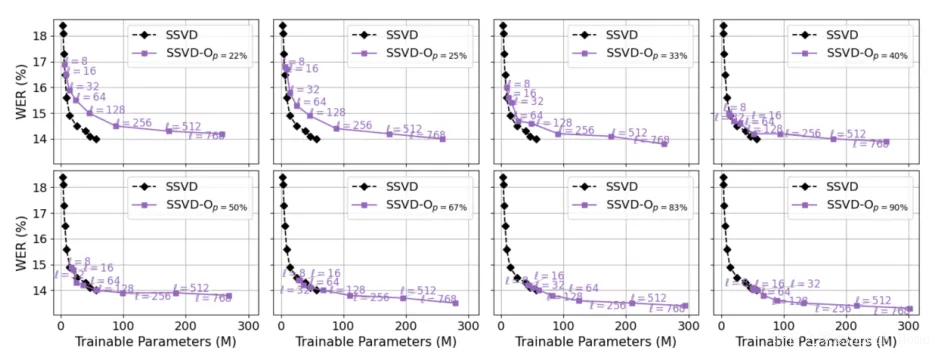
图8 SSVD 与 SSVD-O 在 OWSM-1B 上适配 MyST 数据集时的 WER 与可训练参数量关系
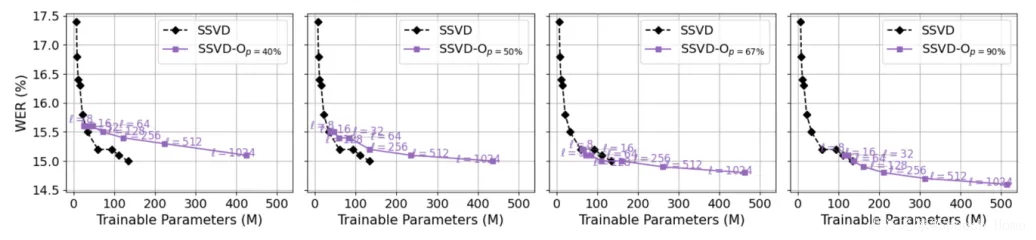
图9 SSVD 与 SSVD-O 在 OWLS-2B 上适配 MyST 数据集时的 WER 与可训练参数量关系
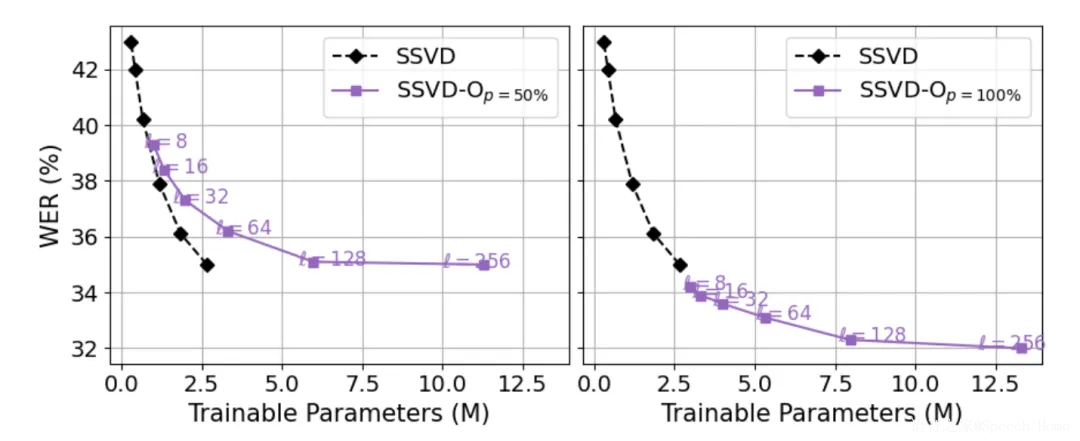
图10 SSVD 与 SSVD-O 在 OWSM-0.1B 上适配 CGN 数据集时的 WER 与可训练参数量关系
4. 不足
SSVD-O 引入输出侧变换后,预算和训练稳定性的分析也更加复杂;outer transformation 的收益依赖模型规模和预算范围,不能概括为对所有任务都优于普通 LoRA。更稳妥的理解是:它为输入声学空间与输出语义空间的协同适配提供了结构化框架,但其对低资源语言扩展的有效性仍需在目标语言、数据规模和语言间遗忘控制条件下直接验证。
四、综合讨论与展望
综合比较这六项工作,可以归纳出以下几条趋势:
- 结构先验不断深入。 相关研究已从“统一的低秩增量”逐步拓展至参数预算分配、奇异子空间初始化、语言路由、深度先验以及输入—输出几何约束。
- 评价维度不应局限于目标域 WER。 在低资源多语种场景下,还应同时报告既有语言的性能保持与遗忘、可训练参数量、MACs、路由与存储开销,以及模型在罕见音素和长尾说话人上的表现。
- 方法选择应与任务变化类型相匹配。 对于语言差异,可以考虑引入语言专属模块;对于层级差异,需要利用深度先验;对于声学域偏移,则应首先检验输入侧结构假设是否成立。
- 统一且可比的基准仍然缺失。 不同工作采用的骨干模型、目标语言、数据规模和评价指标并不一致,因此仅凭单篇论文报告的平均结果,难以可靠判断不同方法的相对优劣。
客观而言,结构化 LoRA 的核心贡献并不在于继续堆叠更多适配器变体,而是进行更加细粒度的适配分析:应更新哪些层、哪些奇异方向,如何建模语言间关系,以及输入侧还是输出侧更值得分配参数。下一步需要解决的关键问题是:在给定语言、数据规模和声学偏移特征的条件下,能否通过可解释的规则预先确定这些预算分配,并同时量化其性能收益、遗忘风险和额外开销。
因此,未来的重点不应只是“用更少的参数达到更低的 WER”,还应进一步回答三个问题:为什么将参数分配到这些位置,在哪些条件下这种分配有效,以及它以何种代价换取性能收益。 这也正是从固定 LoRA 走向结构化低秩适配的关键转折。
五、参考文献
[1] Hu E J, Shen Y, Wallis P, et al. LoRA: Low-Rank Adaptation of Large Language Models[C]. International Conference on Learning Representations, 2022. arXiv:2106.09685.
[2] Zhang Q, Chen M, Bukharin A, et al. AdaLoRA: Adaptive Budget Allocation for Parameter-Efficient Fine-Tuning[C]. International Conference on Learning Representations, 2023. arXiv:2303.10512.
[3] Meng F X, Wang Z, Zhang M. PiSSA: Principal Singular Values and Singular Vectors Adaptation of Large Language Models[C]//Advances in Neural Information Processing Systems 37. 2024: 121038-121072. DOI:10.52202/079017-3846.
[4] Song Z, Zhuo J, Yang Y, et al. LoRA-Whisper: Parameter-Efficient and Extensible Multilingual ASR[C]//Interspeech 2024. 2024: 3934-3938. DOI:10.21437/Interspeech.2024-892.
[5] Xiao Y, Holden E J, Dang T. Adapting Where It Matters: Depth-Aware Adaptation for Efficient Multilingual Speech Recognition in Low-Resource Languages[C]//Findings of the Association for Computational Linguistics: ACL 2026. 2026: 16776-16788. DOI:10.18653/v1/2026.findings-acl.827.
[6] Wang P, Watanabe S, Van Hamme H. SSVD: Structured SVD for Parameter-Efficient Fine-Tuning and Benchmarking under Domain Shift in ASR[C]//2025 IEEE Automatic Speech Recognition and Understanding Workshop (ASRU). 2025: 1-7. DOI:10.1109/ASRU65441.2025.11434624.
[7] Radford A, Kim J W, Xu T, et al. Robust Speech Recognition via Large-Scale Weak Supervision[C]//Proceedings of the 40th International Conference on Machine Learning. 2023: 28492-28518. arXiv:2212.04356.
[8] Wang P, Watanabe S, Van Hamme H. SSVD-O: Parameter-Efficient Fine-Tuning with Structured SVD for Speech Recognition[C]//ICASSP 2026-2026 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2026: 16632-16636.
供稿:侯振宇,编辑:刘怡涵,审核:张王优
