
 语音小管家
本来来源:AudioCC交我学
过去几年,语音增强(Speech Enhancement,SE)正在从传统的降噪、去混响和信号映射,走向扩散模型(diffusion model)、流匹配(flow matching)和语言模型(Language Model,LM)驱动的生成式增强。新模型能让语音听起来更自然、更干净,但也带来了一个新的可靠性问题:增强结果可能“好听但不忠实”。
这里的幻觉(hallucination)不是指模型随意胡说,而是指增强输出中出现了输入语音没有充分声学依据的内容或属性变化。它可能表现为错词、插词、删词,也可能表现为说话人漂移、音色变化、无依据的呼吸声或嘶嘶声。更值得警惕的是,听感指标提升并不总能暴露这些错误,高自然度和低词错误率(Word Error Rate,WER)必须分开评价。
本文围绕“语音增强中的幻觉”这一主题,按照“问题定义—机制分析—低幻觉建模路线—检测与评估—研究启发”的逻辑,梳理 ArtiFree[1]、Phonologically Anchored Speech Enhancer(PASE)[2]、面向录音室级质量的 StuPASE[3]、面向通用语音增强的 UniPASE[4]、Lowering Linguistic Hallucination in LM-Based Speech Enhancement(L3-SE)[5]、Attention Maps(面向 Speech Large Language Model,SpeechLLM)[6] 与 HalluAudio[7] 等代表性工作,并讨论可靠语音增强需要哪些约束。
关键词:语音增强、生成式语音增强、幻觉、WavLM、PASE、L3-SE、音频语言大模型、内容忠实性
一、背景:当语音增强从“滤波”走向“生成”
传统语音增强的核心目标相对清晰:抑制噪声、提升可懂度和感知质量。在经典判别式系统中,模型通常学习从退化语音到干净语音的频谱映射,或者估计时频掩码。它们的常见问题是残留噪声、过抑制、语音失真,整体上偏“保守”。
生成式语音增强把问题推进了一步。扩散模型、流模型和 LM-based SE 不再只是做局部滤波,而是在强语音先验的帮助下生成更像干净语音的输出。问题也随之发生变化:当输入证据不足,模型可能补出“听起来合理但并不来自原始输入”的内容。
样例参考句为“dear me ejaculated the old gentleman in the utmost amazement and such a time as i have had to get her here too”,原始noisy音频的WER为60.9%,而 LLaSE-G1 的 ASR 转写与原句大幅偏离(WER 95.7%)。增强结果仍呈现连贯语音,却补出了大量原始输入没有充分依据的词,直观展示了“听起来合理但并不来自原始输入”的语言幻觉。
因此,今天讨论 SE 时不能只问“噪声有没有降下去”,还要问“增强后的内容是否仍然来自输入语音”。在会议转写、电话通信、助听器、语音识别(Automatic Speech Recognition,ASR)前端、说话人验证(Speaker Verification,SV)以及音频语言大模型(Large Audio-Language Model,LALM)系统中,这一问题会直接影响语义、身份与决策可靠性。
二、先定义问题:语音增强中的幻觉到底是什么
在语音增强场景中,可以把幻觉定义为:增强输出中出现了输入语音没有充分声学依据的内容或属性变化。这个定义有两个关键点:第一,它不要求输出一定“难听”;第二,它强调输出与输入证据之间的关系。一个结果即使自然度很高,只要内容被改写或属性被无依据改变,仍然可能是幻觉。
从表现形式看,SE 幻觉大致可以分成三类。第一类是语言幻觉(linguistic hallucination),包括错词、插词、删词、音素替换,直接影响 ASR 或指令内容。第二类是声学幻觉(acoustic hallucination),包括说话人漂移、音色变化、虚假呼吸声、嘶嘶声、机械音调等,直接影响身份保持和自然度。第三类是结构幻觉(structural hallucination),更多出现在音频理解或 LALM 场景中,例如顺序、计数、事件共存关系被错误回答。
这一定义把 SE 评价从“信号质量”扩展到“内容忠实性”。过去我们常用感知语音质量评估(Perceptual Evaluation of Speech Quality,PESQ)、短时客观可懂度(Short-Time Objective Intelligibility,STOI)、深度降噪平均意见分(Deep Noise Suppression Mean Opinion Score,DNSMOS)和无参考 MOS 预测指标 UTMOS 衡量增强效果,但这些指标并不总能捕捉语言内容偏移。生成式 SE 时代,内容一致性、说话人音色一致性、错误率和下游任务表现必须进入核心评价体系。
三、为什么生成式增强容易产生幻觉
从概率建模角度看,生成式 SE 学习的是条件分布 p(x_clean | x_degraded)。当退化语音 x_degraded 仍然包含充分证据时,模型可以比较稳定地恢复干净语音;但当低信噪比(Signal-to-Noise Ratio,SNR)、强混响、丢包、带宽受限或编码失真让条件变弱时,后验分布会变宽,多个“看似合理”的干净语音候选都可能被模型认为可行。
这时,强生成先验就会变成双刃剑。扩散模型可能在随机采样过程中补出音素级伪影;流匹配模型可能在追求高质量听感时偏离真实内容;LM-based SE 可能因为 noisy conditioning 不可靠而让语言先验主导输出。换句话说,问题不在于模型“太会生成”,而在于生成过程缺少可信的输入证据锚定。
这也解释了一个常见的指标陷阱:主观平均意见分(Mean Opinion Score,MOS)很高,不代表 WER、差分词错误率(dWER)、Levenshtein 音素相似度(Levenshtein Phoneme Similarity,LPS)、SpeechBERTScore(SBS)和说话人相似度(Speaker Similarity,SpkSim)也一定好。听起来干净,不等于内容一定正确;听起来像目标说话人,也不等于每个词都来自原始输入。
论文速览:语音增强幻觉问题的技术地图
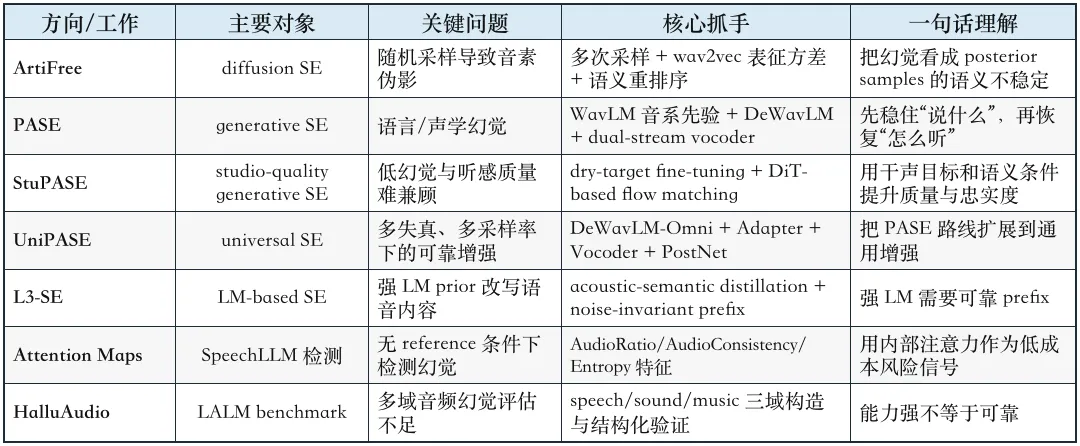
图 1 论文速览技术地图
这张技术地图可以帮助我们把几类工作放在同一坐标系中理解:ArtiFree 主要做推理时检测与重排序,PASE 系列强调表征锚定(representation anchor),L3-SE 强调可靠前缀,Attention Maps 和 HalluAudio 则分别服务于检测与系统性评估。
四、路线一:推理时控制幻觉——ArtiFree
ArtiFree 面向 diffusion-based SE 的生成伪影问题。扩散式增强的优点是自然度和泛化能力强,但输出来自随机采样:同一个噪声样本多次推理,可能有些样本转写接近正确,有些样本出现插词、替换或无依据发声。低 SNR 下,这种不确定性会进一步放大[1]。
ArtiFree 的核心观察很直接:伪影易发区往往对应更高的 embedding 方差。方法上,它对同一噪声输入生成多个增强后的样本,提取每个样本的embedding,再计算跨样本方差,并通过阈值判断是否存在高风险区域。直觉上,如果多个候选在语义表征空间中分叉严重,说明模型对该位置的内容并不确定。
检测之后,ArtiFree 不是简单平均多个波形,而是在候选中选择语义最一致的一个。reference-free 版本选择与其他候选 embedding 最“中心”的样本,oracle 版本则选择与 clean reference 最相关的样本。这个思路相当于用语义先验对扩散后验做重排序,让低幻觉控制可以发生在推理时,而不只依赖训练阶段。
它的启发在于:生成式 SE 的幻觉可以被看成样本不确定性的外显形式。多采样虽然增加推理成本,但也提供了一个可观测窗口,使模型不确定性、候选一致性和输出可信度可以被显式利用。
五、路线二:表征锚定——PASE、StuPASE 与 UniPASE
PASE 系列的共同假设是:很多幻觉首先来自语义/音系条件不稳定。生成模块本身并不是原罪,关键在于生成前是否已经有可信的语音内容锚点。WavLM 等自监督学习(Self-Supervised Learning,SSL)模型在预训练中学习到较强的音系先验,因此可以作为生成式增强的内容锚点[2]。
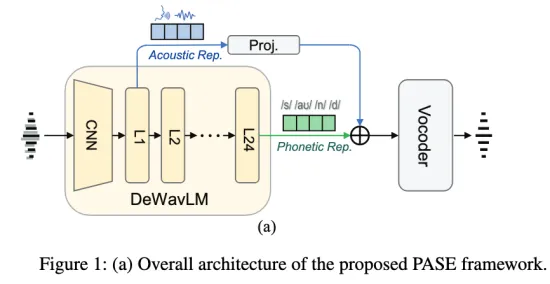
图 2 PASE 架构(来源:[2])
如图 2 所示,PASE 的设计可以概括为两步。第一步,DeWavLM 从退化波形预测干净的语音表征,在 表征领域先做增强。第二步,双路 vocoder 同时利用高层语音表征和低层声学表征,前者负责内容和音系结构,后者补充说话人、音色和韵律。这样既抑制语言幻觉,也尽量减少声学幻觉。
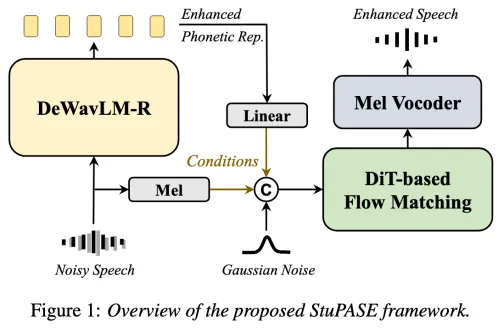
图 3 StuPASE 架构(来源:[3])
PASE 的短板在于:低幻觉结构成立,但在带混响场景下听感和自然度不足。如图 3 所示,StuPASE 针对这个问题做了两项改造:一是 dry-target 微调,避免带早期反射的训练目标污染生成分布;二是引入基于扩散 Transformer(Diffusion Transformer,DiT)的 flow-matching 模块和 Mel vocoder,在可信语义条件下生成更高质量的音频。消融结果表明,真正决定低幻觉的是干净的语义条件:使用噪声语义或去掉语义引导都会显著恶化 dWER[3]。
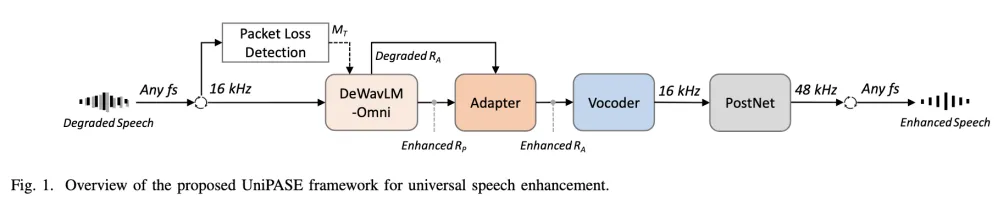
图 4 UniPASE 架构(来源:[4])
如图 4 所示,UniPASE 把 PASE 的低幻觉思想扩展到通用语音增强。真实场景中的失真不只有噪声和混响,还包括 clipping、bandwidth limitation、codec artifacts、packet loss、wind noise 和多采样率输入/输出。UniPASE 使用 DeWavLM-Omni、Adapter、Vocoder 和 PostNet 分阶段处理:先增强语音表征,再恢复 声学表征,最后做高频补偿和灵活采样率输出。消融显示,去掉音韵先验后字符错误率(Character Error Rate,CER)会明显恶化,说明“内容锚点”仍是通用增强中的核心[4]。
PASE 系列留下的设计原则很清楚:可靠生成式 SE 的核心不是生成能力不足,而是把生成约束在可信语音内容上。换句话说,先稳住“说什么”,再优化“怎么听”。
六、路线三:基于 LM 的语音增强需要可靠前缀——L3-SE
LM-based SE 的优势在于 decoder-only 大型语言模型可以建模长程依赖,acoustic tokens 可以生成自然语音,因此很适合复杂语音修复。但它的风险也最直接:如果噪声条件不可靠,强 LM 先验可能主导生成,输出自然却改写词内容。
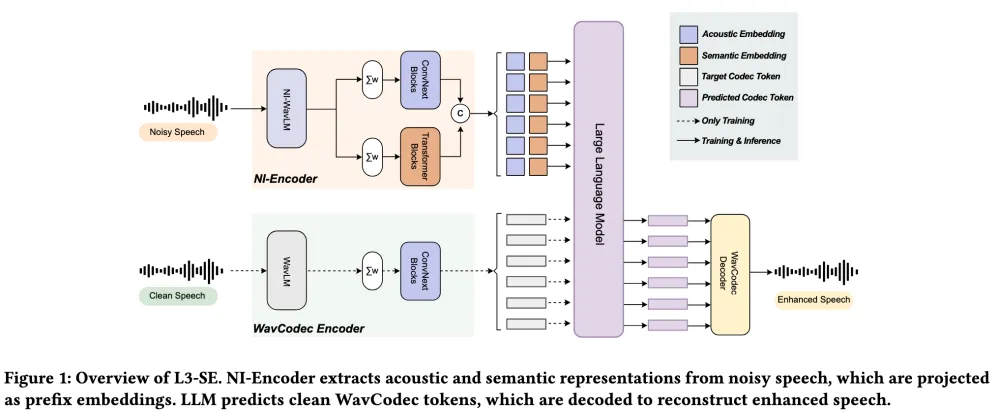
图 5 L3-SE 架构(来源:[5])
L3-SE 将问题归因于输入证据约束不足,并在 encoder和前缀部分进行修改来避免幻觉现象。如图 5 所示,它从同一个 WavLM backbone 构造两个 teacher:WavCodec teacher 侧重声学重建,WavS2T teacher 侧重 speech-to-transcript。学生端噪声不变编码器从噪声输入出发,同时匹配干净的声学目标与干净的语义目标,从而学习噪声不变的声学语义前缀[5]。
实验消融显示,联合声学-语义蒸馏主要降低 WER:从无蒸馏到单 acoustic teacher,再到 acoustic + semantic teacher,WER 持续下降;同时使用声学-语义前缀可以进一步提升内容忠实性。在 LibriSpeech low-SNR 场景中,L3-SE 并不追求最高 UTMOS,却取得了更优 WER,这正好说明“好听”和“忠实”必须分开优化。
L3-SE 给我们的启发是:强 LM 不是问题本身,弱上下文+ 强先验才是语言幻觉的根源。只要前缀足够可靠,LM 的生成能力可以服务于增强;如果前缀不可靠,LM 就可能把语音恢复变成语义补全。
DNS Challenge 2020 测试集(DNS1)对比:混响放大了“听感—忠实性”矛盾
为把 PASE、StuPASE、UniPASE 和 L3-SE 放在同一视角下比较,图 6 选取四类工作共同报告的 DNSMOS、UTMOS 和 dWER:前两者越高代表感知质量越好,dWER 越低代表增强前后词内容越一致。其中,BSRNN 为 Band-Split Recurrent Neural Network。
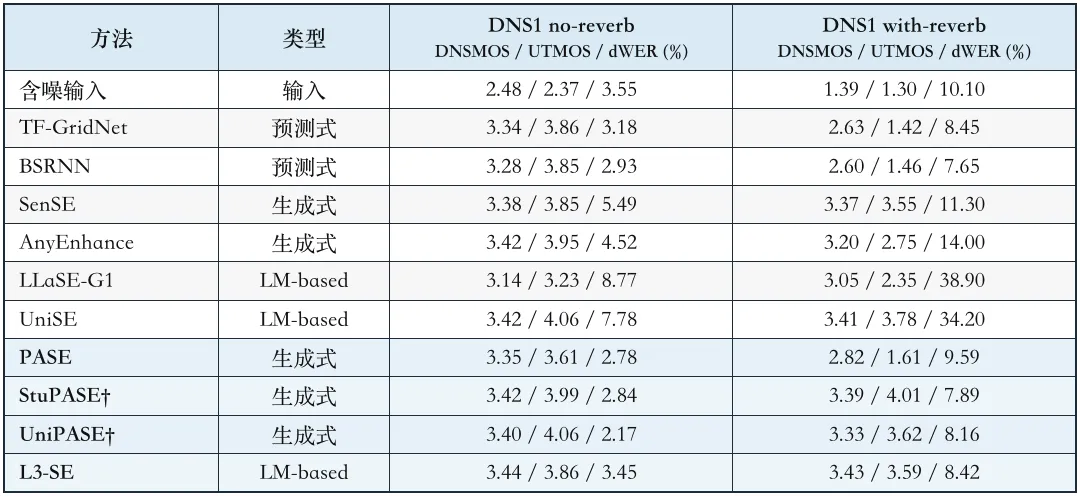
图 6 DNS1 no-reverb/with-reverb 性能对比(数值顺序:DNSMOS ↑ / UTMOS ↑ / dWER (%) ↓)
注:除带 † 的 StuPASE 和 UniPASE 行分别取自其原论文[3]、[4]外,其余数据取自 L3-SE 的同一评测表[5]。由于不同论文使用的 checkpoint 与评价实现略有差异,跨论文数值宜用于判断大趋势,不宜将 0.01–0.1 的小差异解读为显著优势。
两类场景呈现出清晰分化。在 no-reverb 下,预测式基线 TF-GridNet 和 BSRNN 已有较低 dWER,四种重点方法的优势主要体现为在保持内容的同时提高感知质量;其中 UniPASE 报告的 dWER 为 2.17%,PASE 和 StuPASE 也分别保持在 2.78% 和 2.84%。到了 with-reverb,PASE 的 UTMOS 下降到 1.61,而 StuPASE 和 UniPASE 通过 dry-target 微调、更强生成模块与后续恢复,分别提高到 4.01 和 3.62,同时将 dWER 控制在 7.89% 和 8.16%。
混响场景也最能暴露“好听但不忠实”的问题:LLaSE-G1 和 UniSE 的 with-reverb dWER 分别升至 38.90% 和 34.20%,远高于含噪输入的 10.10%。相比之下,L3-SE 在同一评测中取得 3.43 DNSMOS、3.59 UTMOS 和 8.42% dWER,其 dWER 仅次于预测式 BSRNN,但感知质量明显更高。整体来看,PASE 系列通过音系表征锚定内容,L3-SE 通过噪声不变的声学语义先验稳定 LM;两条路线都说明,可靠的先验比单纯加强生成先验更关键。
七、检测与评估:没有干净参考语音怎么办
低幻觉建模之外,还需要低成本、可在线使用的检测机制。语音大语言模型场景尤其困难:干净参考音频通常不可用,纯文本LLM检测器不能直接适配音频输入,音频帧很长,token 与帧的对齐也更复杂。
Attention Maps[6] 的思路是直接利用模型内部注意力图。它设计了四类 audio attention features:AudioRatio 衡量输出 token 对音频输入的注意力占比,用来判断模型是否脱离音频证据;AudioConsistency 衡量连续 token 的音频注意力分布相似度,用来捕捉注意力回退或对齐崩溃;AudioEntropy 表示音频锚定的不确定性;TextEntropy 则表示文本侧不确定性。最后,用轻量 logistic regression 做幻觉分类。
HalluAudio[7] 则提供了面向 LALM 的系统性 hallucination benchmark。它覆盖 speech、sound、music 三个音频域,不只看 accuracy,还关注是/否偏差、虚假拒绝和领域依赖错误。数据构造包括有效问题、无证据问题和扰动样本,并通过结构化答案检查模型是否在“没有依据”的情况下给出肯定回答。
这两条路线对 SE 社区都有启发:一方面,增强模型本身可以利用内部不确定性、注意力坍塌、ASR 偏差或 SSL方差 做风险提示;另一方面,评估不应停留在单一增强指标,而要把下游 ASR、SV、LALM 任务纳入端到端忠实度基准。
八、对研究和工程落地的启发
第一,条件先于生成。生成式 SE 应先保证条件表示是干净且忠实的,再让 decoder、vocoder、flow 或 LM 负责高质量合成。没有可靠条件,生成能力越强,偏离真实输入的风险越高。
第二,感知质量与内容忠实性要分开优化。MOS、DNSMOS、UTMOS 主要告诉我们“听起来怎么样”,WER、dWER、CER、LPS、SBS、SpkSim 才能进一步回答“内容、音素、说话人是否保持”。一个可靠系统必须同时报告这些维度,而不是用单一听感分数覆盖所有问题。
第三,推理时要监控不确定性。多采样嵌入方差、语义一致性、注意力坍塌、ASR 偏差、说话人漂移 都可以转化为在线风险分数。低幻觉不只是一种训练目标,也可以是一套部署时的风险控制机制。
第四,必须承认不可恢复边界。在极低 SNR、长丢包、严重带宽缺失等场景下,输入证据本身可能不足。此时系统应该更保守,而不是强行补出一个最像语音、但没有证据支撑的结果。
进一步看,可以围绕 SE 幻觉构造压力测试,将 ASR 偏差 与 SSL 方差 做成在线风险分数,在训练时引入内容忠实性对比损失,并针对丢包隐藏、带宽扩展等任务设计 abstention-aware 评估。对实验室研究而言,更有价值的问题是:能否把 SE 与 ASR、SV、LALM 串成闭环,形成端到端的内容忠实性基准。
九、结语:可靠 SE 不是“生成得更多”,而是“生成得更有证据”
语音增强的下一阶段,不只是追求更高 DNSMOS、更高 UTMOS 或更强主观听感,而是要同时追求 干净、自然、忠实 和 可感知风险。输出听起来干净,不代表内容一定来自输入;生成越自然,越需要内容锚点;系统越接近大模型能力,越需要不确定性监控与多维评估。
因此,低幻觉语音增强的核心并不是压制生成能力,而是把生成约束在可信证据之内。先稳住“说什么”,再优化“怎么听”。这条原则不仅适用于 SE,也适用于未来所有音频生成、音频理解和音频智能体系统。
观察和判断
1. 生成式 SE 的核心风险不是“生成”,而是弱条件下的强先验主导。
2. WavLM/SSL表征 正在从辅助特征变成内容锚点,是低幻觉增强的重要基础设施。
3. 推理时风险控制会变得越来越重要,attention、ASR 偏差 和 说话人漂移都可以成为部署侧信号。
4. 评价体系需要从单一听感分数转向多维可靠性,包括内容忠实、说话人保持、任务收益和不可恢复边界。
参考文献
[1] B. Chhaglani et al., “ArtiFree: Detecting and Reducing Generative Artifacts in Diffusion-Based Speech Enhancement,” Proc. IEEE Int. Conf. Acoust., Speech Signal Process. (ICASSP 2026), pp. 19757–19761, 2026. DOI
[2] X. Rong et al., “PASE: Leveraging the Phonological Prior of WavLM for Low-Hallucination Generative Speech Enhancement,” Proc. AAAI Conf. Artif. Intell., vol. 40, no. 39, pp. 32826–32834, 2026. DOI
[3] X. Rong et al., “StuPASE: Towards Low-Hallucination Studio-Quality Generative Speech Enhancement,” arXiv preprint arXiv:2603.09234v2, 2026.
[4] X. Rong et al., “UniPASE: A Generative Model for Universal Speech Enhancement with High Fidelity and Low Hallucinations,” arXiv preprint arXiv:2604.14606v2, 2026.
[5] Z. Wang et al., “Reducing Linguistic Hallucination in LM-Based Speech Enhancement via Noise-Invariant Acoustic-Semantic Distillation,” arXiv preprint arXiv:2605.08608, 2026.
[6] J. Waldendorf, B. A. S. Hasan, and E. Tsymbalov, “Detecting Hallucinations in SpeechLLMs at Inference Time Using Attention Maps,” Findings of ACL 2026, pp. 43276–43289, 2026. DOI
[7] F. Zhao et al., “HalluAudio: A Comprehensive Benchmark for Hallucination Detection in Large Audio-Language Models,” Proc. 64th Annu. Meeting Assoc. Comput. Linguistics (ACL 2026), vol. 1, pp. 38797–38816, 2026. DOI
供稿:李闯,编辑:刘丫,审核:张王优
