
 语音小管家
AudioCC交我学
这一期我们想聊的不是某一个具体模型,而是一个最近越来越绕不开的问题:当语音大模型、音频大模型和 omni 模型都开始变强之后,模型到底有没有真的“听懂”声音?
过去几年,大家更熟悉的是 ASR、audio captioning、speech chat 这些能力。模型能把语音转成文字,能说出“这段音频里有人说话、背景有车声”,也能用语音和用户对话。但这些能力离真正的“理解”还有一步。很多时候,我们真正关心的不是声音里出现了什么,而是这些声音意味着什么。举个很日常的例子:厨房里先传来一声闷响,随后是玻璃碎裂声,接着有人停顿了一下,压低声音说“没事”。一个事件识别系统可能会给出“撞击声”“玻璃破碎声”“人声”这样的标签。可如果是一个真正有用的助手,它还需要进一步判断:声音发生的顺序是什么,语气是否自然,是否可能存在受伤或需要帮助的情况。这中间多出来的部分,就是音频推理想解决的问题,从听见到听懂。
近期,香港中文大学等团队发布了综述论文A Survey of Audio Reasoning in Multimodal Foundation Models,系统梳理了多模态基础模型中的音频推理研究。文章把 Audio Reasoning 作为一个独立问题来讨论,并围绕目前音频中的四种范式:Audio-to-Text Reasoning、Audio-to-Speech Reasoning、Audio-Visual Reasoning 和 Agentic Audio Reasoning,讨论了音频推理面临的问题和相关的工作。
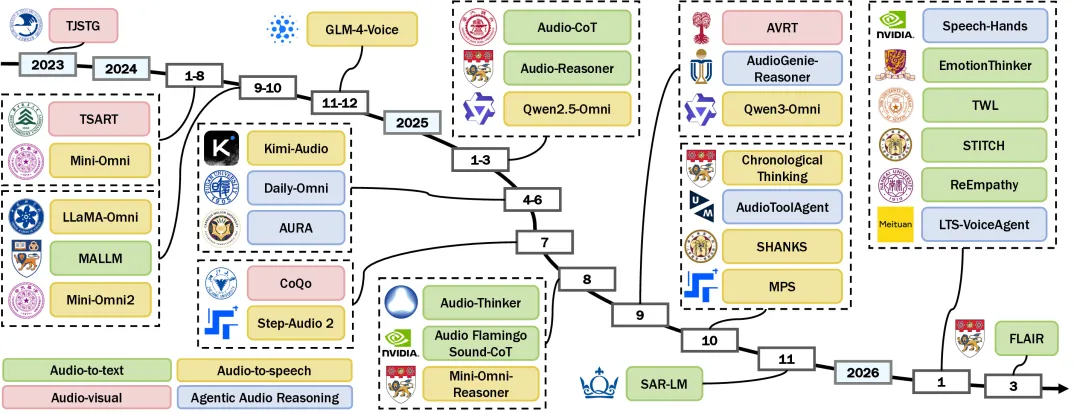
图1:音频推理相关工作的时间线
一、什么是 Audio Reasoning?
Audio Reasoning 这个词听起来很直观,但它很容易和几个相近任务混在一起。ASR关心的是把语音转成文字,例如把一句“我今天有点累”转写出来。Audio Captioning关心的是描述音频里发生了什么,例如“背景中有人说话,同时有车辆经过”。Audio Question Answering会进一步根据音频回答问题,比如“说话人听起来开心还是生气?”而Audio Reasoning更在意的是:模型能不能把听到的声音线索组织起来,形成一个有依据的判断。
所以,Audio Reasoning 的关键不只是答案,而是答案背后的证据链。
一段音频里可能同时包含很多东西:说话内容、语调、停顿、情绪、背景声、事件顺序、说话人状态,甚至还有“某个声音没有出现”这样的负证据。真正困难的地方在于,模型不能只把这些线索列出来,还要知道哪些线索和当前问题有关。
这也是为什么综述反复强调:音频推理不是 ASR + LLM 的简单拼接。
如果系统只是先转写,再把文字丢给大语言模型,很多声音里的信息会在第一步就丢掉。讽刺语气、犹豫停顿、多人重叠说话、背景声变化,这些东西未必会出现在 transcript 里,但它们往往正是判断所需要的证据。下面我们按综述里的四种范式来看。这里的“范式”不是四个递进阶段,而是指不同输入、输出和交互方式下,音频推理会面临不同的问题。
二、范式一:Audio-to-Text Reasoning
Audio-to-Text Reasoning 是现在最容易理解的一类:输入是音频和文本问题,输出是文本答案,有时还会输出一段文本推理链。
它看起来和传统 AQA 很像,但关注点不太一样。传统 AQA 更关心答没答对,Audio-to-Text Reasoning 还会追问:模型为什么这么答?它的解释是不是来自音频?如果把音频换掉,答案会不会变?
1. 从 Audio-CoT 到 SAR-LM:先把“听到什么”说清楚
Audio-CoT 是比较早把 Chain-of-Thought 引入大音频语言模型的工作。它的想法并不复杂:模型不要一上来就回答,而是先描述音频,再根据描述一步步推理。论文比较了 Manual-CoT、Zero-shot-CoT 和 Description-CoT 等方式,发现 CoT 对简单和中等难度任务确实有帮助,但到了复杂任务上,效果就没有那么稳定。这个结果其实挺有提醒意义。对音频任务来说,让模型多写几句理由,不等于它真的在做推理。推理链写得顺,不代表证据就来自声音。
SAR-LM 走的是另一种更“显式”的做法:先把音频转成可读的符号表示,比如 ASR 结果、声音事件标签、音乐属性,再交给 LLM 推理。这样做的好处是证据来源清楚,解释也更容易检查。问题也在这里:一旦前端符号化过程漏掉了语气、时间顺序或细粒度声学信息,后端 LLM 再强也很难补回来。
2. Audio-Reasoner:把推理链做成训练数据
如果 prompt 激发思维链不够稳定,一个自然的想法是:能不能直接把音频推理过程做进训练数据里?
Audio-Reasoner 的贡献就在这里。它构造了 CoTA 数据集,把推理过程拆成 planning、captioning、reasoning 和 summarizing 四个阶段。模型先规划应该听什么,再描述音频,再基于描述推理,最后给出答案。
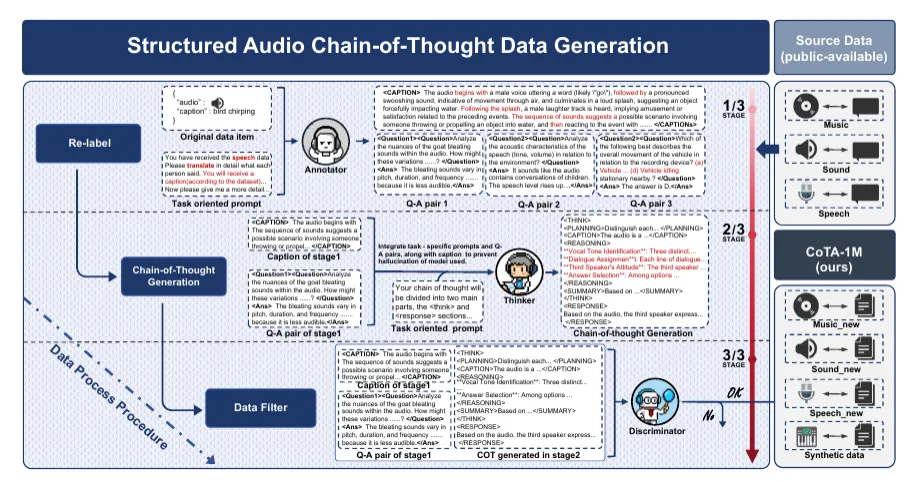
图2:Audio-Reasoner 的 多阶段数据生成管线
这个设计很有代表性。它承认一个事实:音频推理数据不应该只有“问题-答案”,还应该有“从哪些声音证据走到答案”的过程。但这里也埋着一个问题。很多 reasoning chain 是由强 LLM 合成出来的,它们读起来很合理,却不一定忠实于音频。模型最后学到的是 audio reasoning,还是学到一种“很会写解释”的文本风格,这件事不能只看表面分数。
3. Sound-CoT:别让文本模型一个人编链
Audio Flamingo Sound-CoT 对这个问题的处理更谨慎。它指出,如果只让文本模型基于音频描述生成思维链,音频推理很容易退化成文本推理。于是它让LLM和ALM一起参与:LLM 负责拆问题、组织链条,ALM 负责回答和音频相关的子问题。
这类方法的价值在于,它把“听音频”这件事重新放回了思维链生成管线。也就是说,推理链不是由文本模型凭音频描述想象出来的,而是尽量让音频模型在中间步骤里提供证据。
4. RL-based Audio Reasoning:奖励该给谁?
文本推理模型中,RLVR / GRPO 这条线很火。到了音频领域,大家自然也会问:能不能用类似方式训练音频推理?R1-AQA 在 Qwen2-Audio 上使用 GRPO,发现 RL 可以提升 AQA 表现。但它也观察到一个不太符合直觉的现象:显式 CoT tokens 在 GRPO 中并没有稳定带来收益。这说明音频推理里的 CoT 不能直接照搬文本推理的经验。
Step-Audio-R1 则进一步强调声学grounding。训练模型时,不只是奖励答案正确,还要鼓励模型利用可感知的声学特征,例如音高、语速、停顿、情绪和声音事件。
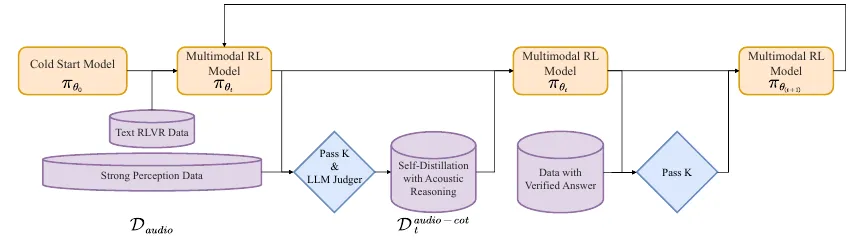
图 3:Step-Audio-R1 的训练流程
这一组工作给人的感觉很明确:Audio-to-Text 推理的重点不是把思维链写长,而是让思维链真的落回音频证据。
三、范式二:Audio-to-Speech Reasoning
如果模型最后不是打字回答,而是直接开口说话,问题会立刻变复杂。在这种情况下,推理更关注的是时延,这会直接影响到交互的体验。因此,Audio-to-Speech Reasoning 关心的是另一件事:模型能不能在听完,甚至还没完全听完的时候,形成内部推理状态,并用语音自然地回应。这时目标就不只是“答对”了,还包括几个更实际的问题:什么时候开始说?说话的时候还能不能继续想?如果后续上下文推翻了前面的判断,能不能修正?推理深度、响应延迟和语音自然度怎么平衡?
1. Thinking while Listening:用户还没说完,模型先想起来
实时语音交互里,最宝贵的其实是用户说话的那段时间。模型能不能一边听,一边提前形成判断?
SHANKS 就是在做这件事。它让模型在 streaming audio chunks 到达时持续更新 hidden thoughts,把用户说话时间转化成模型推理时间。
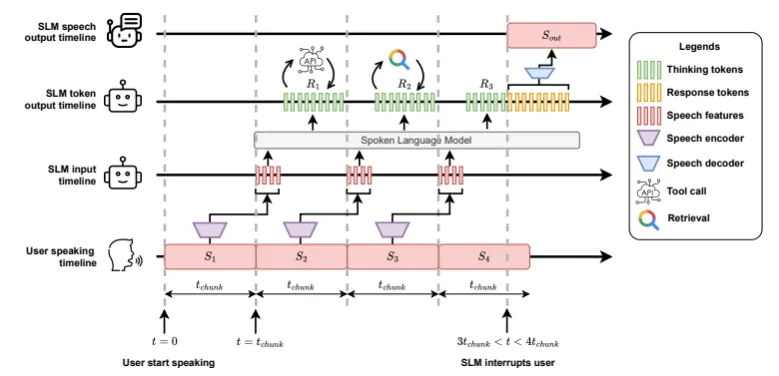
图 4:SHANKS 边听边想示意图
这样做可以降低响应延迟,但也带来风险:模型太早形成的判断,可能会被后续上下文推翻。所以实时推理系统不能只追求“想得早”,还要能不断修正。
FLAIR 提出的 latent reasoning 也很有意思。它不要求模型把所有思考都显式说出来,而是在内部维护 silent thought。这样可以减少延迟,也让对话更自然。不过代价是,隐式思考更难解释,也更难监督。
2. Thinking while Speaking:模型说话的时候继续想
另一类工作把推理计算藏在模型自己说话的时间里。STITCH 将长推理切成多个 chunks。模型播放前一个语音 chunk 的时候,后台继续生成下一个 reasoning chunk 和 speech chunk。这样,speech buffer 也变成了 reasoning buffer。
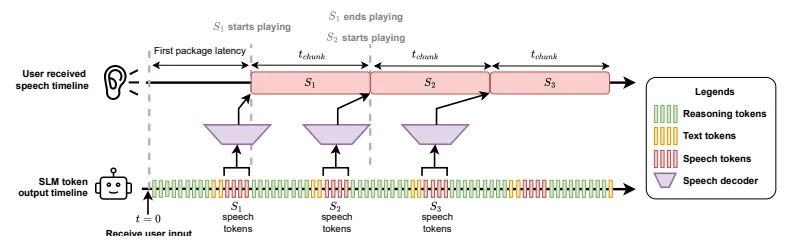
图 5:STITCH 边说边想示意图
Mind-Paced Speaking 采用 dual-brain 设计:一个 brain 负责 articulation,也就是把当前内容说出来;另一个 brain 负责 formulation,也就是继续规划后面的 thought。这个思路很接近人类说话的状态:嘴里说的是刚组织好的内容,脑子里还在准备下一句。
因此,Audio-to-Speech Reasoning 最核心的矛盾不是模型会不会推理,而是推理和实时交互之间的冲突。想得越深,通常越慢;但语音交互不能让用户一直等。
四、范式三:Audio-Visual Reasoning
真实世界里,声音很少单独出现。很多判断本来就需要同时看和听。比如判断“谁在说话”,需要看嘴型,也要听声音;判断一个杯子是不是摔碎了,视觉能看到杯子掉落,音频能确认碎裂声;判断画面外发生了什么,视觉可能完全看不到,但声音会提供线索。
Audio-Visual Reasoning 关心的就是这类问题:模型要同时整合声音和视觉两种模态,并根据问题判断哪种证据真正相关。VITA、Baichuan-Omni、Lyra、LongCat-Flash-Omni、Qwen3-Omni 等模型都在尝试构建更统一的 omni模型框架。它们之间的差异不只是模型规模,还包括 audio encoder、visual encoder、projector/resampler、speech output、thinking mode 和训练配方。
评测方面,Daily-Omni、WorldSense、AV-SpeakerBench、Omni-Captioner、JointAVBench 等工作都在强调同一件事:音频必须成为必要证据。一个好的音视频推理benchmark 不应该让模型只看视频描述就能答对。它需要通过一些问题的设置,检查模型是否真的在联合使用声音和视觉。
这一点对整个 audio reasoning 都很重要。多模态不是把几个模态堆在一起,而是要证明每个模态在推理里都有不可替代的作用。
五、范式四:Agentic Audio Reasoning
前面几类范式主要讨论模型如何回答问题。但真实场景里的语音助手,往往不只是回答,还要完成任务。比如用户说:“帮我找一下刚才会议里张老师提到的那篇论文。”这句话背后其实是一串任务:先理解语音,再定位说话人和时间片段,可能还要检索文档、调用搜索工具、总结结果,最后再用语音回应。单个端到端模型目前的能力未必适合把所有环节都包下来。于是,Agentic Audio Reasoning 开始出现。
AudioToolAgent 把 ASR、声音事件识别、语音转写、检索等工具暴露给 agent,由 planner 决定什么时候调用工具、怎么整合工具结果。
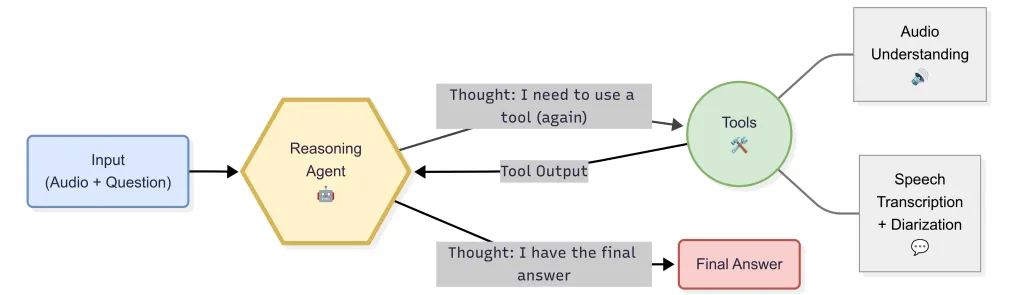
图 6:AudioToolAgent 调用 Agent 示意图
从这个角度看,Agentic Audio Reasoning 的本质不是“回答得更长”,而是把“听懂声音”推进到“基于声音完成任务”。
这也意味着,未来的音频推理可能不只是模型问题,更是系统问题。
六、结语
从 ASR 到 audio captioning,再到 audio reasoning,音频智能正在经历一次重要转向。过去,模型主要回答“这段声音里有什么”。现在,我们开始追问“这段声音意味着什么”。再往后,模型还需要回答“我应该如何基于这段声音行动”。这篇综述的价值,不只是把相关工作整理到一起。更重要的是,它提醒我们:Audio Reasoning 应该被看作多模态基础模型里的独立研究问题。未来的音频模型不应该只是“听见”声音,而要能够基于声音证据进行理解、推理、表达和行动。
七、参考文献
[1] Guo Z, Cui W, Lin G T, et al. A Survey of Audio Reasoning in Multimodal Foundation Models[J]. arXiv preprint arXiv:2605.21008, 2026.
[2] Ma Z, Chen Z, Wang Y, et al. Audio-CoT: Exploring Chain-of-Thought Reasoning in Large Audio Language Model[J]. arXiv preprint arXiv:2501.07246, 2025.
[3] Xie Z, Lin M, Liu Z, et al. Audio-Reasoner: Improving Reasoning Capability in Large Audio Language Models[J]. arXiv preprint arXiv:2503.02318, 2025.
[4] Kong Z, Goel A, Santos J F, et al. Audio Flamingo Sound-CoT Technical Report: Improving Chain-of-Thought Reasoning in Sound Understanding[J]. arXiv preprint arXiv:2508.11818, 2025.
[5] Li G, Liu J, Dinkel H, et al. Reinforcement Learning Outperforms Supervised Fine-Tuning: A Case Study on Audio Question Answering[J]. arXiv preprint arXiv:2503.11197, 2025.
[6] Tian F, Zhang X T, Zhang Y, et al. Step-Audio-R1 Technical Report[J]. arXiv preprint arXiv:2511.15848, 2025.
[7] Xu J, Guo Z, He J, et al. Qwen2.5-Omni Technical Report[J]. arXiv preprint arXiv:2503.20215, 2025.
[8] Chiang C H, Wang X, Li L, et al. SHANKS: Simultaneous Hearing and Thinking for Spoken Language Models[J]. arXiv preprint arXiv:2510.06917, 2025.
[9] Chiang C H, Wang X, Li L, et al. STITCH: Simultaneous Thinking and Talking with Chunked Reasoning for Spoken Language Models[C]. The Fourteenth International Conference on Learning Representations, 2026.
[10] Wijngaard G, Formisano E, Dumontier M, et al. AudioToolAgent: An Agentic Framework for Audio-Language Models[J]. arXiv preprint arXiv:2510.02995, 2025.
供稿:韩冰,编辑:方楠,审核:韩冰
