
 语音小管家
大家好,欢迎来到「AudioCC交我学」专栏!
作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。我们将用通俗易懂的语言拆解复杂理论,用数据与实验结果验证技术价值,带你快速了解最新、最有趣的学术论文,打破学术与大众之间的壁垒,让你在碎片化的时间里也能 get 到前沿知识!
1、投机解码:加速大模型推理的外部方案
随着AI的大力发展,作为人工智能领域的关键应用,大语言模型(LLM)的推理加速一直是研究热点。模型推理加速可以通过不同的方式实现,例如vLLM通过重新设计page attention实现了对KV Cache的有效管理,模型量化通过改变参数数据精度实现了更高效的计算。投机解码同样作为模型推理加速方法,但是其实现方式却和上述方法有所不同,在这里我把它称为“外部方案”。
“外部方案”是指不改变模型内部结构设计和参数格式,通过在模型外增加一部分参数或者模型的方式来实现模型推理加速的方式。投机解码通过草稿模型(小模型)、上文采样等方式,为目标模型(大模型)快速提供多个猜测的token。进而通过并行验证的方式,在一次前向推理的时间内同时验证多个预测的候选token,实现目标模型推理一次获得多个token输出的效果。
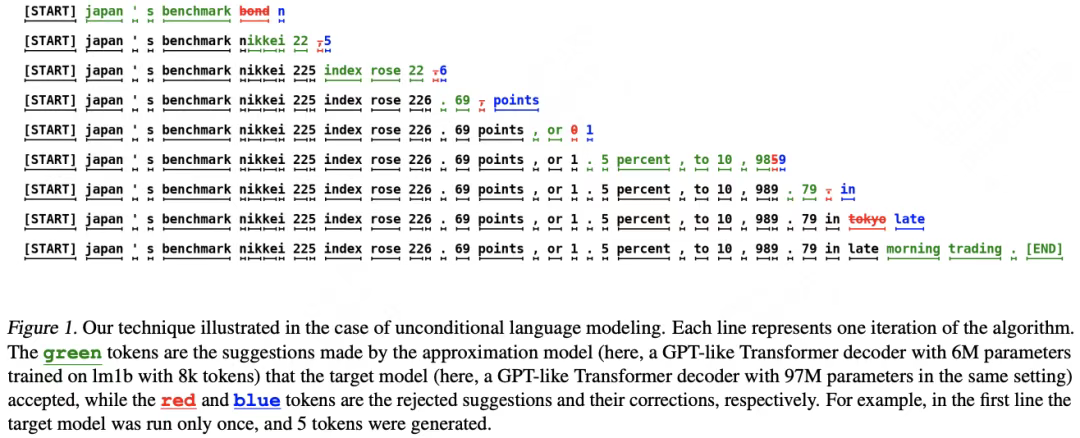
图1:投机采样效果验证
投机解码的这种特性使得它无需改变模型本身,只要模型支持并行推理,便可使用投机解码的方式进行加速。这种特性使投机解码摆脱了对模型本身结构的依赖,在模型之外添加辅助模型用于辅助模型加速,因此投机解码和量化、剪枝等模型压缩技术完全正交。
2、投机解码的基本概念:大小模型与并行验证
投机解码系统通常由两个关键结构组成:草稿模型(Draft Model)和目标模型(Target Model)。目标模型是待提升推理速度的模型;草稿模型是为目标模型提供预测token的小模型,通常选择小尺寸的同类型模型或者蒸馏模型。也有一些工作中没有采用完整的模型结构,转而采用模型的一部分结构,如最后一层Decoder结构或者解码头充当草稿模型。
草稿模型扮演“军师”或者“参谋”的角色,为目标模型提供一些供参考的输出,由大模型进行验证后选择性采纳。小模型带来了更大的开销,但是也赋予了大模型更快输出的能力。投机解码中的“投机”是指猜测模型输出。因此草稿模型的预测能力对投机解码而言至关重要。
并行验证保证了目标模型可以一次性推理验证草稿模型的预测输出。只要有并行推理能力的目标模型,在理论上都可以实施投机解码。投机解码可以和其他推理加速方案结合使用,同时投机采样也适用于所有可以并行验证的模型上。
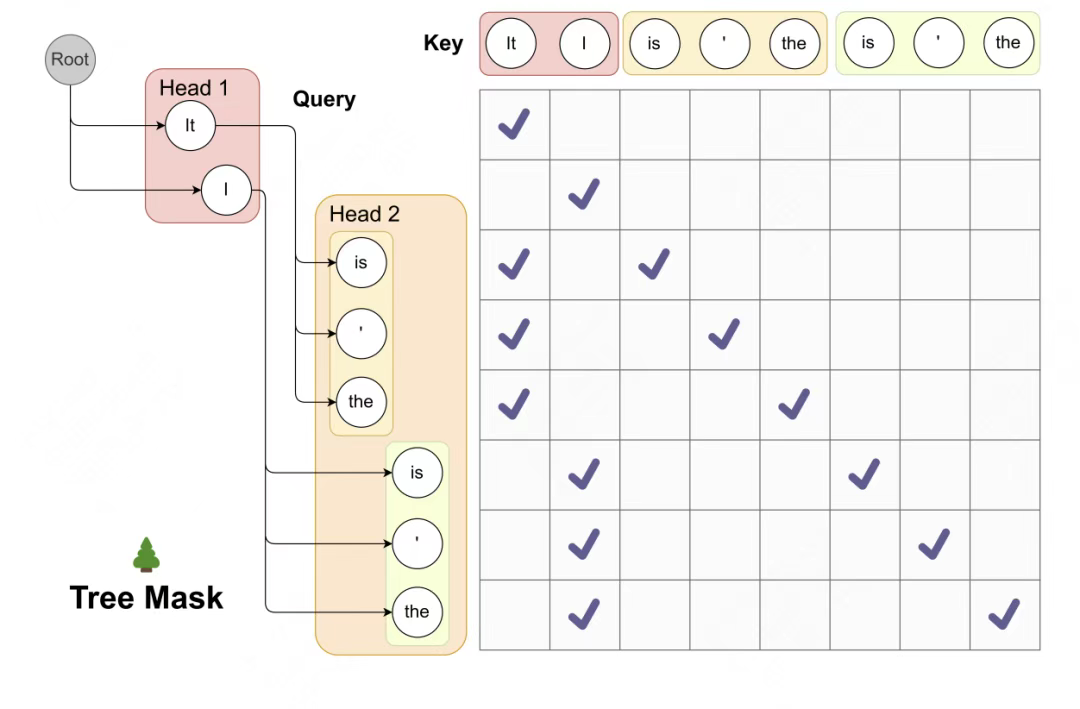
图2:投机采样中的并行验证
投机解码在产生预测输出和并行验证中带来了更大的推理开销,换来了更快的输出效率,本质上是在用计算量(batch或空间)换取时间。因此,投机解码方法的优化也主要从这两个方面入手,也就是设计更加高效的草稿模型增加投机解码的命中率,设计特殊的并行验证musk实现高效并行验证。
3、通过训练高效草稿模型优化投机解码
上文中提到的草稿模型对投机采样的效果起到重要作用,当前大部分方法都依赖草稿模型的高效推理和预测。本期带来两种主流的通过设计高效率草稿模型实现投机采样的方式。
l EAGLE:预测隐藏状态实现投机采样
与传统投机采样依赖小型草稿模型不同,Eagle直接利用原始模型提取的丰富上下文特征(即第二顶层输出的特征向量),训练一个轻量级自回归头(Auto-regression Head)来预测后续特征序列,并通过冻结的分类头生成最终token。这种方法无需额外草稿模型,仅需少量参数即可实现高效解码。
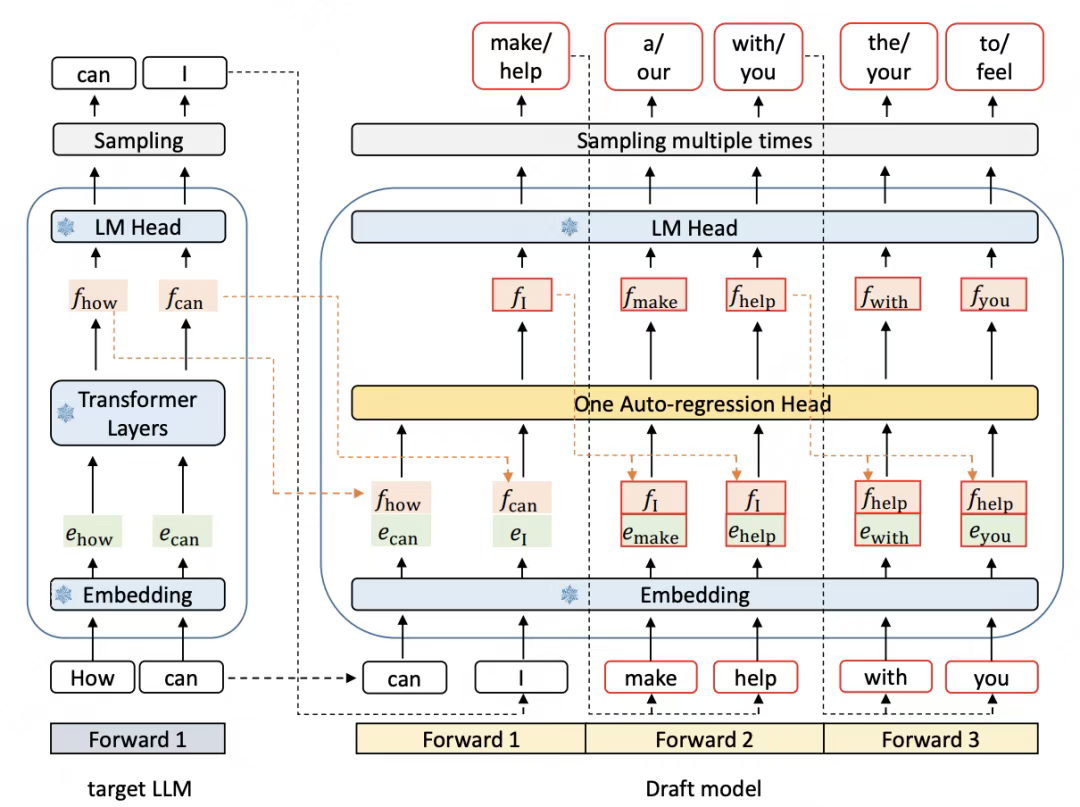
图3:投机解码方法EAGLE
l Medusa:通过多头结构生成多个token
Medusa的主要思想是在目标模型的基础上,设置多个解码头,并且每个头预测的偏移量是不同的,比如原始的头预测第i个token,而新增的Medusa Heads分别为预测第i+1,i+2...个token。如下图,Medusa通过综合多个解码头Top-k采样之后最后选择最优的输出。
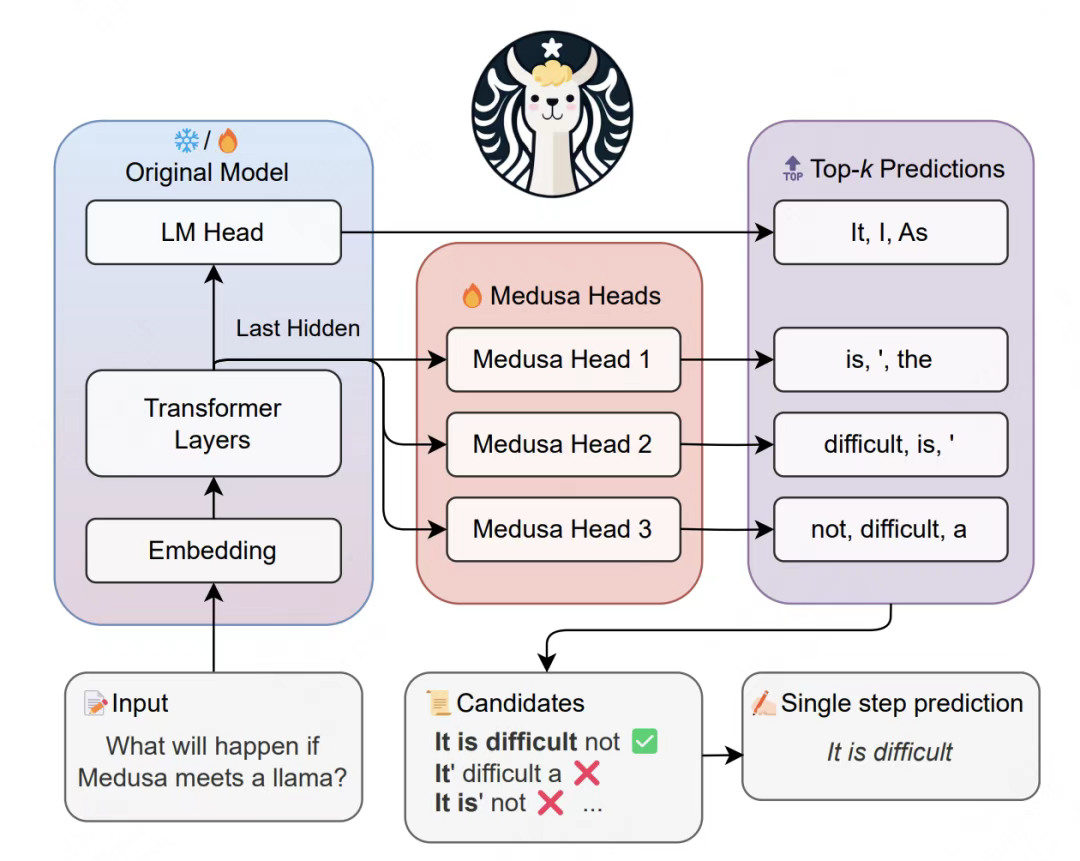
图4:投机解码方法Medusa
4、投机解码与DeepSeek-V3
投机解码也被应用在了DeepSeek-V3中,DeepSeek采用了类似于EAGLE的在主干模型之后添加一部分参数的方式实现了投机采样,并命名为MTP(Multi-Token Prediction)。但是DeepSeek采用投机采样的目的却不局限于加速推理,而是把加速模型训练作为主要目标。
MTP从方法上可以实现更多的前向预测,但是为了线上部署之后的计算开销和命中率等因素,MTP在实际应用中只保留了next 2 tokens 预测,相当于在生成下一个token的时候多预测了一个token。虽然这种实现方式加速效果受限,但只预测下一个token的实现方法使得MTP的命中率很高,达到了85%~90%。
在训练模型方面,首先MTP将后续预测token的Loss通过梯度回传,覆盖主干网络的所有Transformer模块,能辅助主干模型加快收敛速度。其次在MTP的设计中,Output Head和Embedding Layer也是共享的,理论上也能接收到后续词语的Loss影响。因此整个目标模型主干网络的所有参数,都能得到后续词语的Loss实现训练,最大程度的加快了主干网络的收敛。
5、通过并行解码加速投机解码
投机解码的方法也可以通过流水化并行来实现提升。传统的投机采样方法在草稿模型输出时,目标模型处于空闲状态,然而由于草稿模型也是基于自回归模型设计,在输出时无法得到目标模型的反馈,造成错误累积的问题。例如草稿模型预测的第一个token就无法通过目标模型的验证,这样后续草稿模型的输出将完全没有意义,在拉低了命中率的同时还浪费了推理时间。
l PEARL:通过并行解码提升投机解码效率
PEARL方法通过pre-verify和post-verify两种方法来提升投机解码的效率。
pre-verify: 当draft model推理时,target model提前验证第一个draft token;如果第一个draft token就已经错了,此时没必要在进行完整验证,这样就可以跳过无效的验证环节。
验证post-verify: 当target model验证时,draft model可以继续生成draft tokens,进而节约整体生成时间。
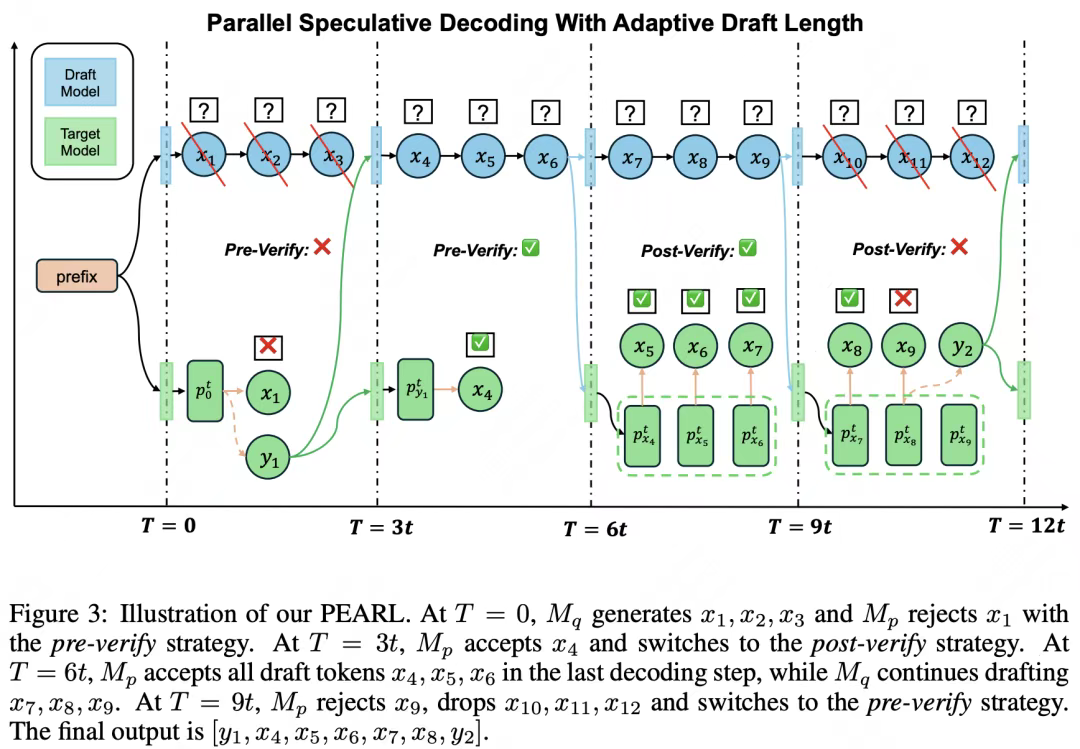
图5:投机采样方法PEARL
6、无草稿模型:无需训练的投机解码
草稿模型的作用是为目标模型提供预测token,但是预测token的来源不一定是草稿模型。原理上,只要有一些预测文本,就可以取代草稿模型。在大语言模型的实际应用场景,比如客服模型,RAG等上下文领域相关度高的场景下,直接采用上文中的内容作为预测token也是不错的主意。
这样做的好处很多。首先,无草稿模型可以节约投机解码的开销,省去了多余的草稿模型推理开销;其次,如此便省去了草稿模型的训练过程,无需整理训练数据,造成模型训练流程的增加;最后,这样的方法可以实现即插即用,不需要进行多余的准备工作便可直接开始产生预测token。
无草稿模型投机采样方法Lookahead
Lookahead通过将上文中的提示词和输出进行整理,采用前缀树的方式保存上文中的输入输出,通过树状结构匹配来产生投机采样的预测token。此时
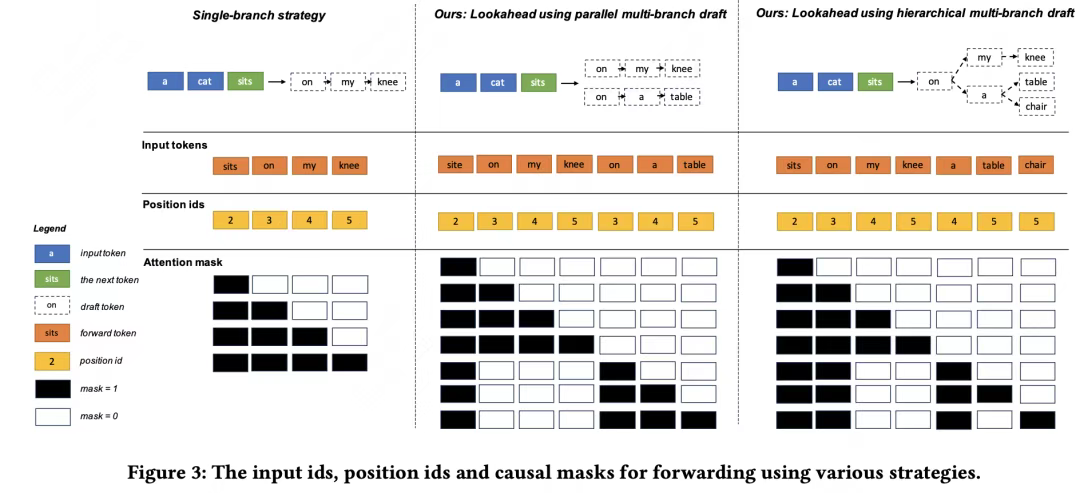
图6:投机解码方法Lookahead
7、总结
投机解码方法作为大语言模型的推理优化方法,可以在保证模型输出质量的前提下大幅提升模型推理速度,为大语言模型的推广和使用起到了关键的促进作用。通过采用更强的草稿模型,进行并行验证,采用无草稿模型采样等方式,投机解码的效率不断提升,为模型推理加速提供了新的思路和方法。
