
 语音小管家
大家好,欢迎来到「AudioCC交我学」专栏!
作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。我们将用通俗易懂的语言拆解复杂理论,用数据与实验结果验证技术价值,带你快速了解最新、最有趣的学术论文,打破学术与大众之间的壁垒,让你在碎片化的时间里也能 get 到前沿知识!
随着大语言模型(LLM)的兴起,机器翻译(Machine Translation)领域也迎来了深刻的变革。近期,我们调研了一些最新的研究进展,整理了几大热点和未来趋势,与你分享。
一、大模型时代的翻译新挑战
1. 翻译幻觉(Hallucination)
尽管LLM拥有强大的理解能力,但在翻译任务中仍可能出现幻觉问题。模型容易仅基于概率进行翻译,而非真正理解文本含义。
2. 评估翻译质量难度增加
现在大模型普遍具备不错的翻译能力,传统的评价指标(如BLEU)已难以有效区分翻译质量优劣,迫切需要更先进的评估方法。
3. 低资源语言与语音翻译仍面临困境
尤其在语音翻译中,语音识别(ASR)的误差导致整体翻译性能明显落后。
二、最新研究如何提升大模型翻译能力?
我们挑选了几篇近期有代表性的论文进行介绍:
1. Prompting与CoT方法优化翻译效果
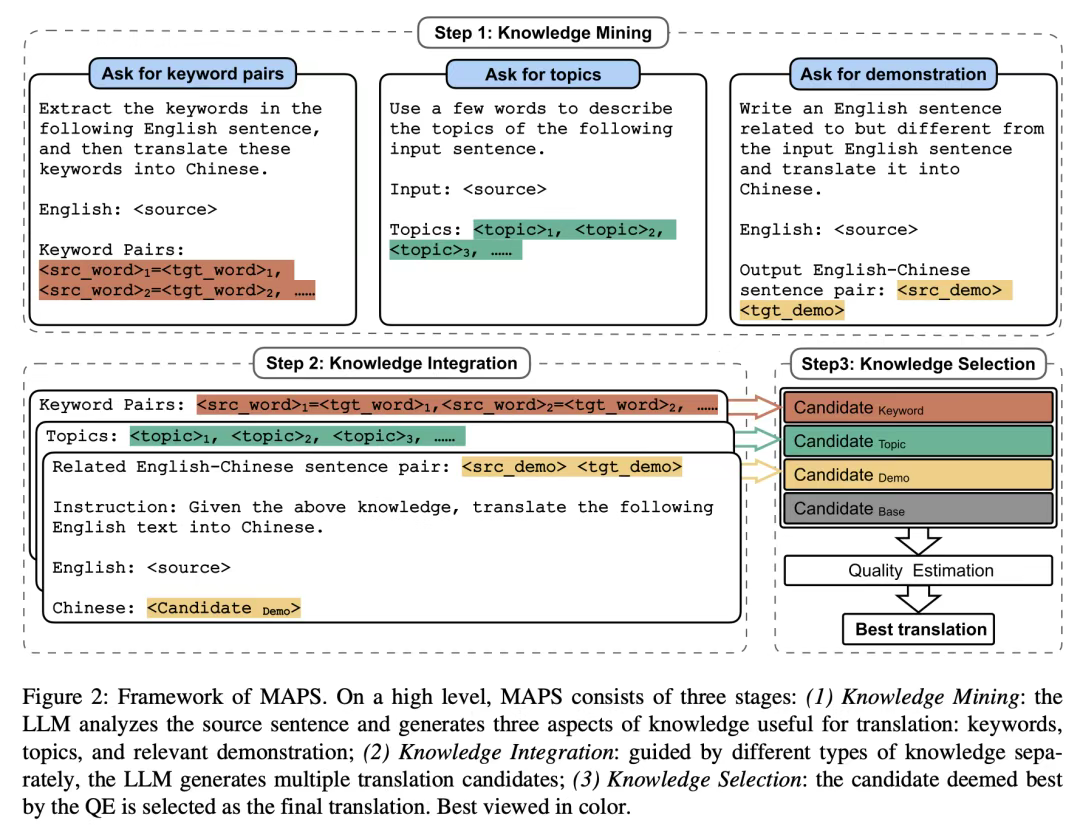
这篇来自上海交大与腾讯研究团队的工作,通过设计精细的Prompt(提示),引导大模型更准确地理解文本并进行翻译。具体做法包括:
从源文本中提取对于主题更有价值的关键词
单独生成候选翻译,再组合筛选出最佳结果
虽然提升幅度不大(1~~2个BLEU点),但有效减少了错误,尤其在易混淆词汇上表现突出。但相对的推理开销较大。
2. 回译(Back Translation)迭代优化翻译质量
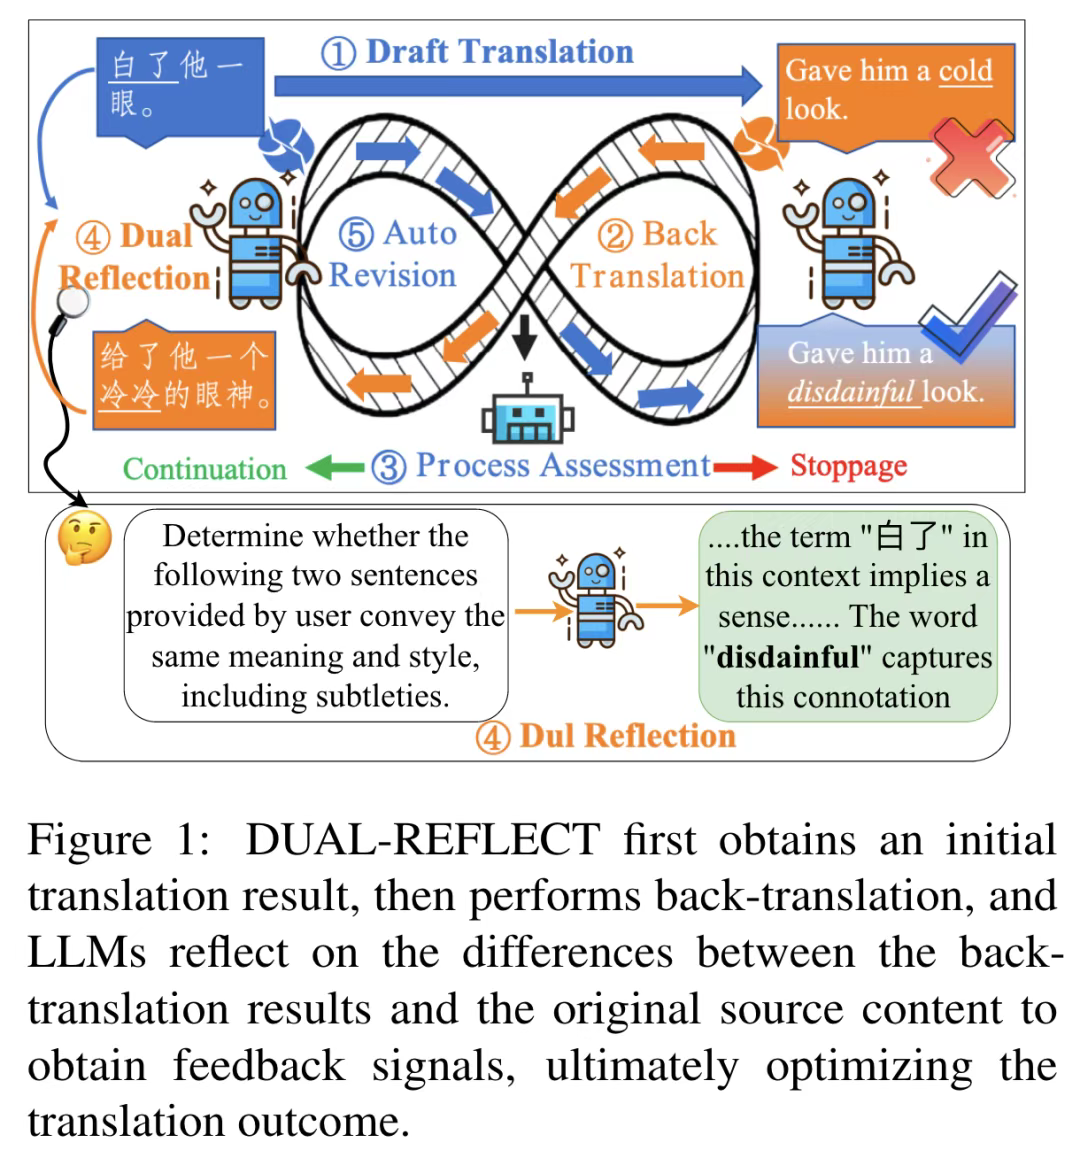
另一研究提出利用翻译的回译机制自动纠错。具体流程包括:
初步翻译
要求大模型回译到原语言,并且判断是否回译成功。
如果回译成功,则作为正确结果输出。
如果回译失败,则分析错误原因并提出改进建议。
该方法显著提高了翻译准确性(1~~4个BLEU点),且无需额外标注数据,甚至让GPT-3.5性能超过了GPT-4。但该方法也较耗时,迭代三轮效果最佳。
3. 多模态辅助强化翻译质量
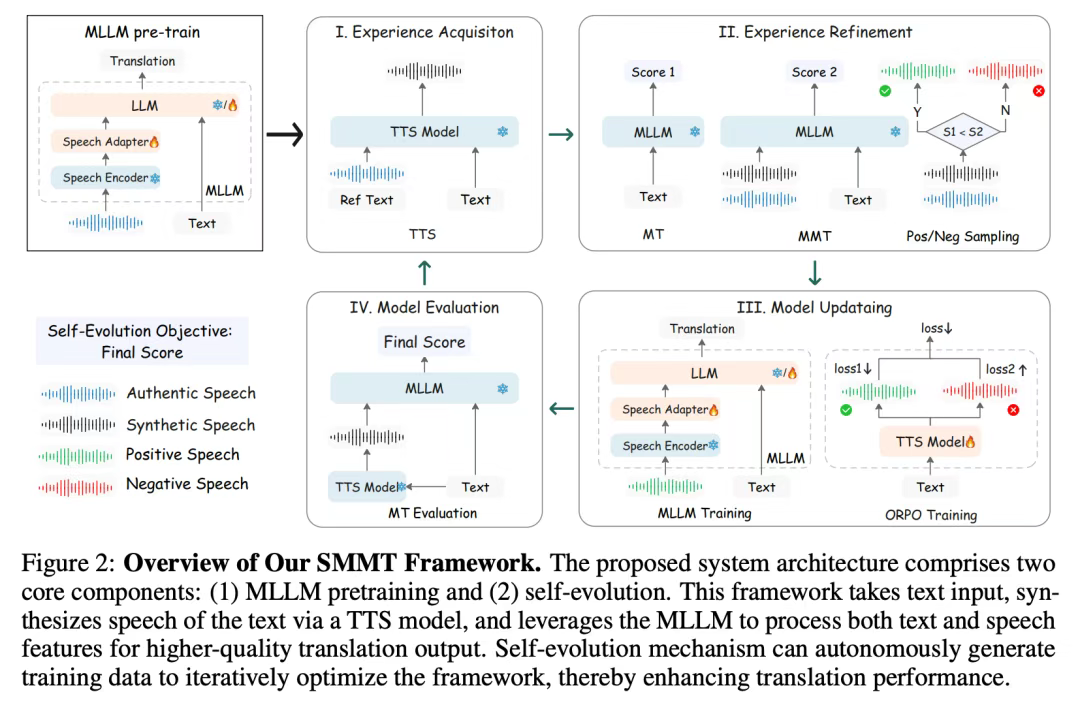
《When Speech Meets Multimodal Machine Translation: Aligning Synthetic Speech with MLLM Preferences via Self-Evolution》
这一工作提出利用多模态大模型的听觉能力,使用文本和对应的语音同时输入来增强大模型的翻译能力。
该工作发现,对多模态大模型同时输入语音与文本进行训练,可以增强大模型对原文本中易忽视的部分的注意力,有效减少“漏翻”错误。实验表明,在进行多模态训练后,漏翻错误率由5.2降至3.5。因此,该工作提出利用TTS合成的音频来辅助文本翻译。此外,该工作还设计了强化学习算法对TTS模型进行微调,以强化这种辅助作用。在微调后,其使用的10B模型在多项翻译指标中均超越目前的商用大模型,达到SOTA水平。
三、翻译评估指标的更新换代
评估指标准确与否,是否贴合人的喜好,是大模型翻译能力能否继续迭代进步的关键。传统指标(如BLEU, chrF)已无法满足评估需求,研究者提出了更接近人类判断的新指标:
1. BLEURT
BLEURT 由 Google 提出,是基于 BERT 预训练语言模型并经过微调的评估指标。BLEURT 先用大量人工评分的句对进行监督微调,学习如何用上下文语义表征参考译文和候选译文,输出一个相关性分数。能捕捉复杂的语义和语法关系,能判别多样化表达;实验表明与人工评价相关性高,适应多种语言对。
2. COMET
COMET 是当前主流的神经网络自动评价指标之一,由 Unbabel 和大学学者合作开发。通常采用基于 XLM-R/BERT 等多语种预训练模型,输入候选译文、参考译文、源句三者,基于三元输入建模,使用人工标注的数据(如 DA scores)进行微调,学习端到端的“好坏”打分。支持多语种,能直接利用源文信息,鲁棒性强,对语义一致性和文体多样性更敏感,公认与人工评价的一致性很高。
3. MetaMetrics-MT
MetaMetrics-MT 是 Meta提出的最新一代自动评价指标,融合了大量人工评分和多种训练目标。在大规模的人工评价数据集上微调强大的 Transformer(如 XLM-RoBERTa)模型,支持多语言、多类型打分(如 adequacy、fluency 等),并对不同评价任务进行“多任务学习”。MetaMetrics-MT在WMT2024的Metric 榜单中,达到SOTA。
其中BLEURT 与COMET 因为其开源模型被广泛使用。但即便是SOTA的MetaMetrics在与人偏好相关性也仅达到0.7。一个更好的翻译评价指标依然是一项重大的考验。
四、总结
随着大模型的到来,机器翻译的问题似乎已经被解决,然后从各项试验结果来看,依然有一些可以探索的问题:
* 如何能让翻译指标更好的贴合人的喜好,同时提升翻译评估方法的可解释性,让指标更透明?
* 如何增强多模态翻译的能力,如语音,图像。
* 如何迁移到实时流式的场景,如会议中的同声翻译,并增强实时性。
