
 语音小管家
大家好,欢迎来到「AudioCC交我学」专栏!
一、技术必要性分析
稀疏注意力的发展主要源于三方面需求:
计算效率需求:传统注意力在处理长文档、高分辨率图像等任务时,计算量随长度平方增长,严重制约模型扩展性。
内存优化需求:注意力矩阵的显存占用是训练长序列模型的主要限制因素,稀疏注意力通过减少存储需求突破这一瓶颈。
算法效率考量:实证研究表明,自然语言中存在大量冗余注意力权重,选择性计算可提升模型效率而不显著影响性能。
二、稀疏注意力的基本概念
标准自注意力机制需要计算输入序列中所有位置对之间的相关性权重,这种全连接模式在长序列场景下面临计算效率瓶颈。稀疏注意力的核心思想是:在保持模型性能的前提下,仅计算对任务关键的位置对之间的注意力权重。 主要技术路径包括:
静态稀疏模式:基于先验知识设计固定注意力模式
局部注意力:限制每个位置仅关注固定大小的邻域窗口。
块稀疏注意力:将序列分块,在块内或特定块间计算注意力。
动态稀疏模式:根据输入内容自适应选择重要位置
基于相似度的选择策略。
基于哈希的高效检索方法。
三、 DeepSeek NSA技术创新详解
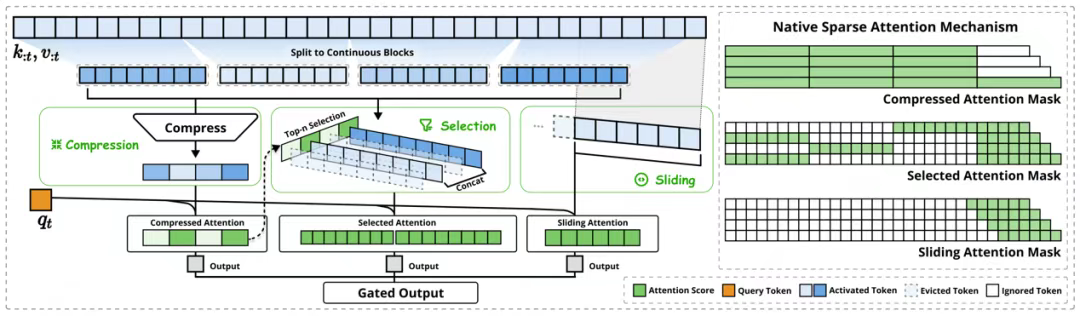
Natural Sparse Attention(NSA) 是 DeepSeek 在2025年2月发布的针对长序列处理提出的硬件感知的原生稀疏注意力机制,其核心创新在于将算法层面的稀疏策略与硬件层面的并行计算特性深度结合。
分层稀疏架构: 根据输入序列特性动态调整稀疏模式,在全局信息捕获与计算效率间实现优化平衡 (如下图所示)
模式一:粗粒度块压缩 (Compressed Attention)
计算流程转变:
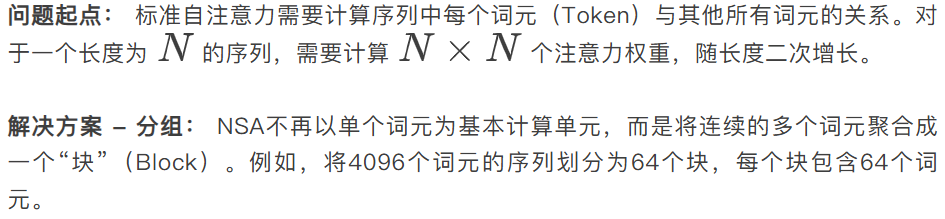
之前(标准注意力): 处理 4096个Token-> 需要处理 4096 * 4096 ≈ 16.7M个关系对。
之后(块压缩): 处理 64个块 -> 先计算块与块之间的注意力。此时,需要处理的关系对数量骤降至 64 * 64 = 4096 个。
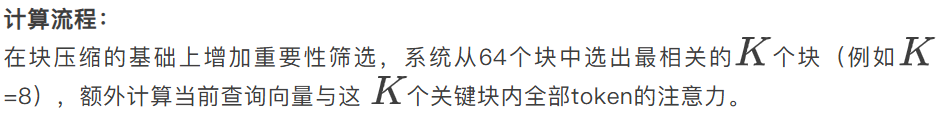
模式二:细粒度重要性筛选 (Selected Attention)
目标: 在压缩后的块中,筛选出需要“精读”的关键部分。
问题起点: 简单的块压缩是“一刀切”的,它假设所有块都同等重要。但实际上,对于当前要处理的词元来说,某些块是关键的(如核心论据),某些块是次要的(如背景信息)。
解决方案 - 动态选择: NSA引入动态机制,根据当前的查询(Query)内容,评估并筛选出最相关的少量关键块。
系统会为每个块计算一个“重要性分数”。这个分数通常基于当前查询向量与每个块的“摘要向量”(通常是块内词元的均值或通过一个小型网络生成)的相似度。
模式三:滑动窗口 (Sliding Attention)
目标: 保证局部上下文信息的完整性。
问题起点: 纯粹的块压缩和全局筛选可能会割裂最紧密的局部依赖关系。在自然语言中,一个词的含义最直接地受其前后几个词的影响。如果当前词元只能关注到被筛选出的、可能很遥远的“关键块”,而完全忽略了紧邻它的词元,会导致模型无法理解基本的语法和短语结构。
解决方案 - 局部保留: NSA强制性地规定,无论重要性筛选的结果如何,每个词元都必须关注以其自身为中心的一个局部窗口内的所有其他词元。这个窗口是“滑动”的,因为它随着词元位置的变化而移动。
工作机制: 假设滑动窗口大小为256。那么对于序列中第500个词元,无论如何它都会关注第500-255至第500这个范围内的所有词元。
三模式协同工作流
当一个序列输入NSA时,其注意力计算流程如下:
1.粗粒度块压缩: 将长序列分割成块,把问题规模降下来。
2.细粒度重要性筛选 + 滑动窗口增强: 对于序列中的每一个词元,同时进行两种操作:
滑动窗口: 强制计算与它邻近窗口内所有词元的注意力。
重要性筛选: 动态选择几个远处的、但内容高度相关的关键块,计算与这些块内所有词元的注意力。
3.结果融合: 将“局部滑动窗口注意力”和“全局筛选块注意力”的结果合并,形成该词元最终的上下文表示。
硬件协同优化 基于Triton框架定制高性能计算内核,优化GPU内存访问模式,提升Tensor Core计算效率。
四、实证性能表现
在测试中,NSA技术展现出显著优势:
训练效率:在64K长度序列上,前向传播加速9倍,反向传播加速6倍。
推理性能:解码延迟降低11.6倍,内存访问量减少90%。
质量保持:在“大海捞针”长文本检索任务中保持100%准确率。
能力提升:数学推理任务准确率提升5.4-7.5个百分点 。
五、总结
稀疏注意力技术通过有选择的计算策略,为长序列建模提供了可行的优化路径。DeepSeek NSA技术在算法创新与硬件优化的协同设计方面取得的进展,展示了该方向的重要潜力。随着对长上下文建模需求的持续增长,稀疏注意力有望成为大模型架构演进的关键技术方向。
