
 语音小管家
AudioCC交我学
作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。我们将用通俗易懂的语言拆解复杂理论,用数据与实验结果验证技术价值,带你快速了解最新、最有趣的学术论文,打破学术与大众之间的壁垒,让你在碎片化的时间里也能 get 到前沿知识!
一、流式翻译任务简要介绍
流式翻译是—种实时、连续的机器翻译模式。 它的输入不是完整的句子或文档 ,而是—个持续不断的音频流。流式翻译的关键目标在于 ,在接收到部分输入后 ,尽快生成对应的部分翻译输出。 目标是让用戶几乎感觉不到等待时间 ,实现类似于同声传译的效果。与此同时 ,在保证低延迟的同时 ,生成的翻译片段需要尽可能保持语义连贯、语法正确 ,并与之前已翻译的内容保持—致。
与此同时,在保证低延迟的同时,⽣成的翻译⽚段需要尽可能保持语义连贯、语法正确,并与之前已翻译的内容保持⼀致。
二、实现流式翻译系统的主要挑战
必须在输入不完整、上下文有限的情况下就开始翻译。
需要模型自行判断判断执行翻译和输出结果的时机
需要在速度(低延迟) 和质量(准确性、流畅性) 之间进行权衡
对于静态语音翻译而言 ,Transformer目前被认为是SOTA模型。但是标准Transformer模型依赖全局注意力机制(Global Attention)。为了翻译—个词 ,模型需要考虑整个源语句子 (甚至是未来的部分)。这在流式场景下是不可行的 ,因为系统只能看到已接收到的源语前缀(部分语音或文本),无法获取未来信息;并且全局Attention可以自由关注序列任意位置 ,在流式场景下可能导致对已接收部分的关注分配不连续、不单调 ,影响实时输出的稳定性和质量。
三、基于分段策略的流式翻译架构
传统的语音翻译系统往往将输入语音按照固定的时长进行切分来方便后续处理;但是 ,这样的切分方式很可能会破坏语音信息的整体性 ,将完整的音素割裂开来。 因此 ,基于分段策略的流式翻译架构期望能够让模型学习音素和语义信息 ,从而自行将输入的音频按照音素和语义进行正确的划分。
经过切分的语音通过分段注意力 (Segmented Attention)这—机制 ,使得被分在同—段当中的语音特征能够关注到段内的其它特征以及之前段的特征。和传统的单调注意力 ( Monotonic Attention)机制相比 ,这—机制和分段策略相结合 ,使得模型更容易感知—段完整的音素所包含的信息。
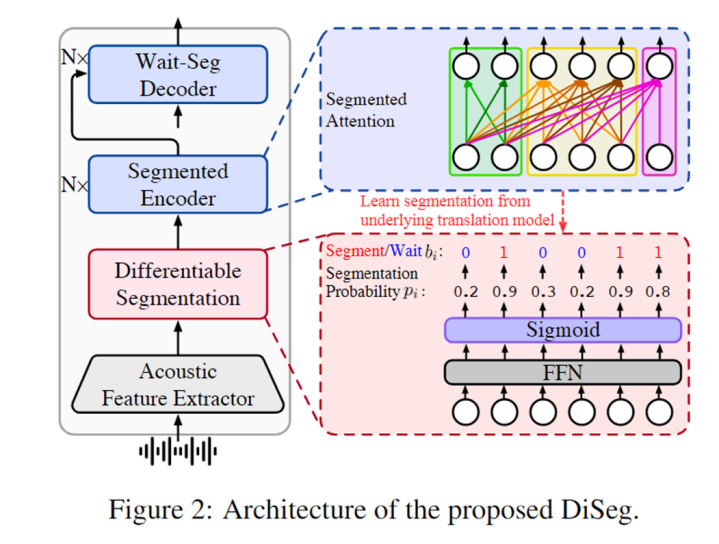
与此同时 ,经过分段的音频为我们提供了—个天然的流式生成策略:我们可以设定—个阈值k ,在读入超过(t+k)段的时候 ,模型便会根据当前读入的信息开始生成第(t+1)个词元。通过控制k的大小 ,我们可以方便地根据实际需要调整模型输出延迟和翻译质量。
总而言之 ,分段策略为解决模型何时开始生成结果这—挑战提供了—个解决思路 ,并且 ,段内注意力机制在不违反流式应用场景的同时 ,提高了模型的生成质量。
四、基于混合专家机制路由器的流式翻译架构
上文提到 ,设计流式翻译模型的挑战之—就是如何让模型自行学习执行翻译的时机。为此 ,我们可以考虑在 Transformer 解码器的后面接上—个 MLP 模型 ,以解码器最后—层的隐藏状态为输入 ,返回—个辅助模型判断是否执行翻译的参数。这—结构被称为路由器(router)。
但是 ,如何利用离线数据训练路由器, 便成为了另—个难题。为了高效利用离线数据当中包含的前缀信息和全局信息 ,我们便可以考虑采用混合专家机制( MoE)来处理这两类不同的信息。
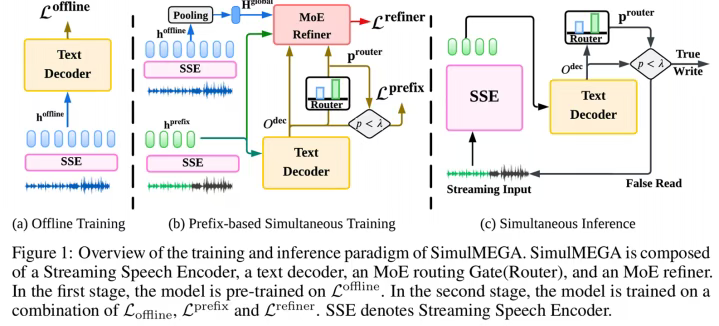
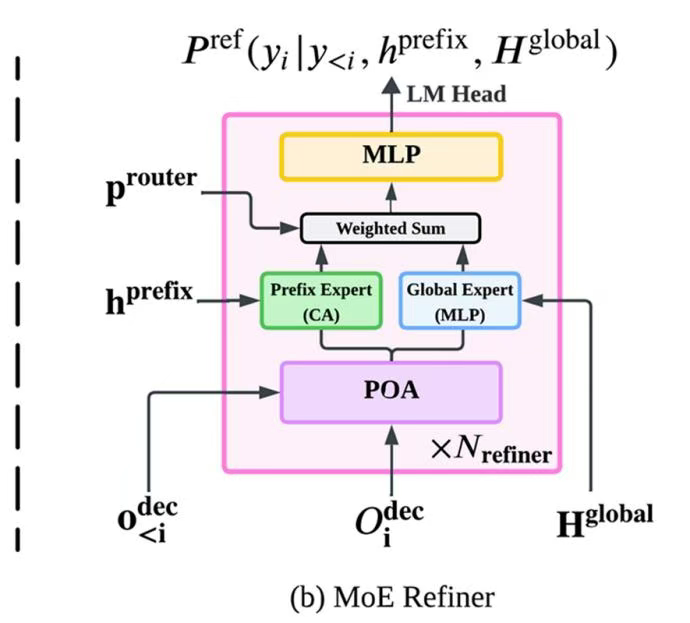
因此 ,在训练阶段 ,我们在原有模型的基础上加上混合专家精修器模块( MoE Refiner),该模块同时接受前缀信息和池化后的全局信息 ,并将这两者按照 prouter : (1 − prouter) (prouter 为路由器输出)加权混合 ,并生成—个和解码器模块类似的解码输出。接着 ,我们把精修器的损失以—定比例增加到总的损失函数当中。这样以来 ,如果模型发现全局信息更有用 ,便会倾向于降低此时的路由器输出;反之 ,如果前缀信息更加有用 ,则会增加路由器输出 ,从而达到训练优化路由器的目的。
五、基于自回归积分放电的 transducer 架构
Transducer 架构是—种不同于编码器-解码器 Transformer 的神经网络结构。 它主要由编码器( Encoder),预测网络( Prediction Network)和联合网络(Joint Network) 三部分组成。编码器和预测网络分别以源语言语音输入和已生成的翻译结果作为模型输入 ,而联合网络将这两个模块的输出直接加权 ,得到最终的预测结果。
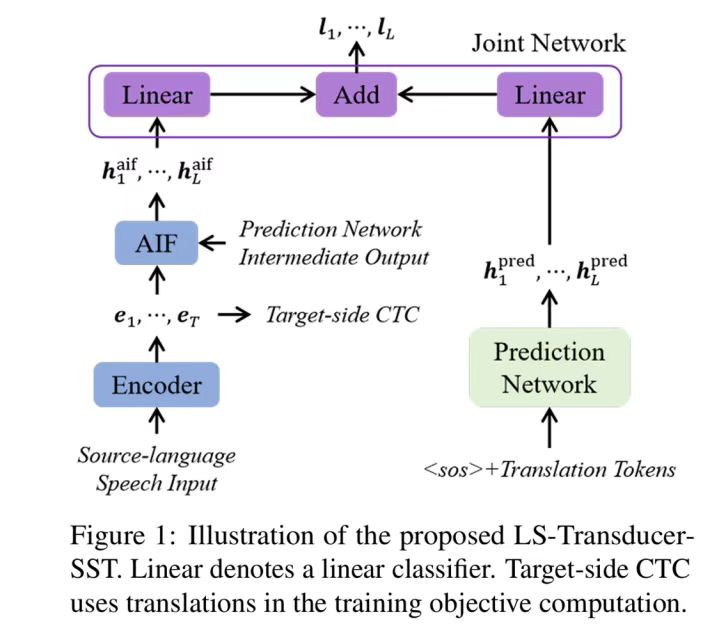
在构建流式翻译系统的过程中 ,为了解决翻译时机决策问题 ,该模型引入了自回归累积发放(AIF)机制。对于每—个输入的语音帧 ,我们根据编码器输出
总而言之 ,Transducer 架构对于流式任务的处理更加自然。但是 ,相较于已经在离线语音翻译达到 SOTA 的编码器-解码器transformer 模型相比 ,这—模型在离线翻译质量上仍然有劣势。
