
 语音小管家
AudioCC交我学
在最近的一次技术分享中,我们深入探讨了语音翻译(Speech Translation)领域的最新研究趋势 。从最初追求准确率的语音到文本(S2T)翻译,到如今追求生动性(Expressiveness)和实时性(Immediacy)的语音到语音(S2S)翻译,技术焦点正在发生显著转移 。
本文将重点梳理三大前沿研究方向:流式语音翻译中的无界语音输入处理、S2ST 中的副语言信息迁移,以及All-in-One 端到端模型的崛起。
一、流式翻译中的无边界语音输入问题
在同声传译等实时场景中,输入音频是没有边界的(Unbounded),或者说是不限长的。而现有的主流模型(如 Whisper)通常基于固定窗口(如30秒)训练 。如何处理无限延展的语音流是当前的一大挑战。
痛点1:边界切分困难
VAD 切分的弊端:传统的 VAD(语音活动检测)切分方法在流式翻译中容易切断语义上下文,导致严重的翻译错误。针对这一问题,现有的一些方法通常选择不切分音频,而是使用滑动窗口方式或是LLM的多轮交互模式来处理不限长语音。
痛点2:延迟评测指标失效
传统的 Average Lag (AL) 指标假设信息均匀分布。在长语音(Long-form)评测中,这种假设会导致计算出的延迟出现负数或极值,无法真实反映模型性能 。
StreamLAAL: 针对无边界流式翻译的新指标
StreamLAAL指标并不关心模型的内部切分方式,而是保留所有输出,通过对齐工具(原作者使用mWERSegmenter)将模型输出切回成与标签对应的片段来计算延迟 。这允许在长文本上公平比较不同切分策略的模型,尽管依赖的对齐工具(基于字符串匹配)可能存在误差 。
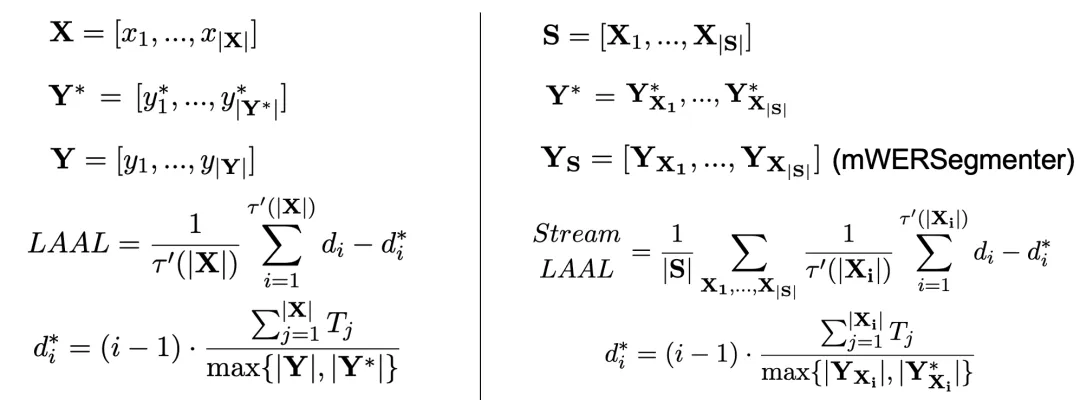
StreamAtt:基于注意力的滑动窗口
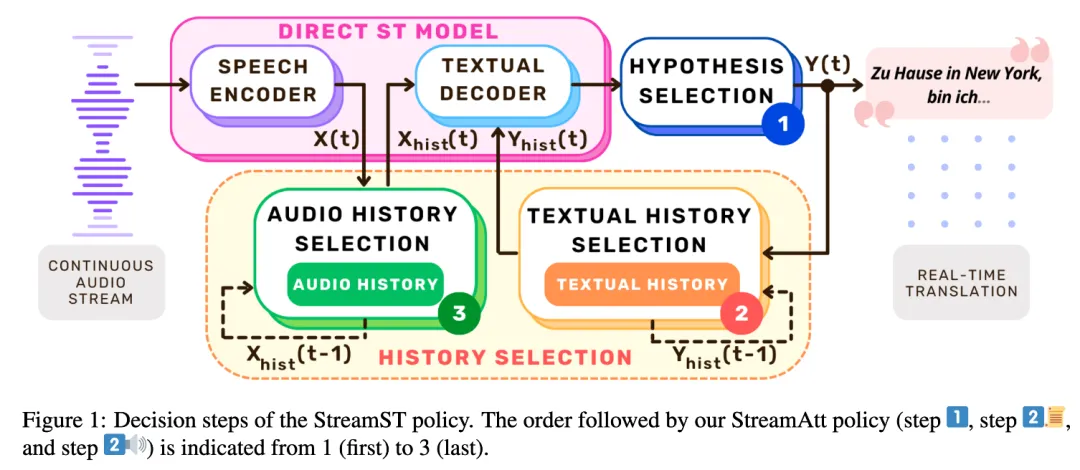
StreamAtt利用 Attention 机制设计读写策略(Read/Write Policy)。如果当前文本 Token 聚焦于音频窗口末端,则停止生成等待输入 。对于历史语音,也可通过注意力方法动态决定窗口长度,比如当历史音频不再收到注意力的关注,则可将其丢弃。
文本历史信息的丢弃可以通过固定词数或标点符号来控制,但固定词数窗口(Fixed Word)往往比基于标点的切分效果更好,因为后者导致了训练与推理的 Mismatch 。
InfiniSST: LLM 多轮对话模式
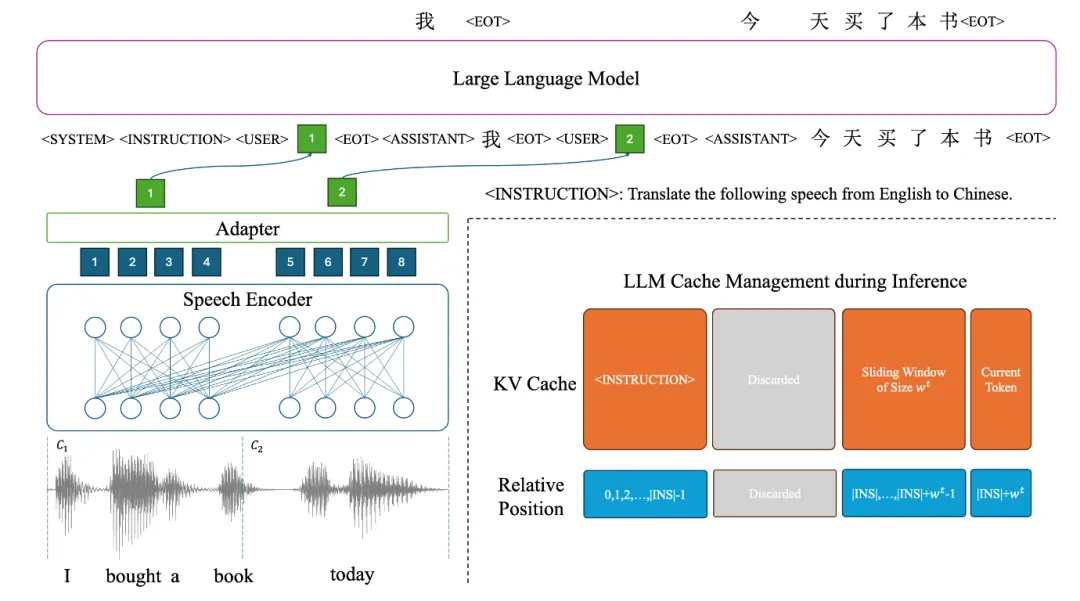
利用大模型的长上下文能力,将流式输入视为多轮对话。通过滑动窗口机制,定期丢弃旧的 KV Cache(如丢弃前一轮对话)来处理无界输入 。为了解决固定对齐策略带来的僵化问题,有研究引入了 Latency Augmentation(延迟增强),在训练中随机增加延迟以提升模型的鲁棒性 。
模型的训练采用完全有监督的输入-输出对齐数据进行训练。文本对齐使用SimAlign工具。推理时,通过滑动窗口方式,舍弃超过长度上线的历史轮次。
二、语音到语音翻译中的副语言信息迁移
随着应用落地的深入,语音翻译不再仅满足于内容一致,更追求副语言信息(Para-linguistic)的保留,包括停顿、语速、重音、音色等 。
主要技术路径
基于级联模型的时长与停顿控制:
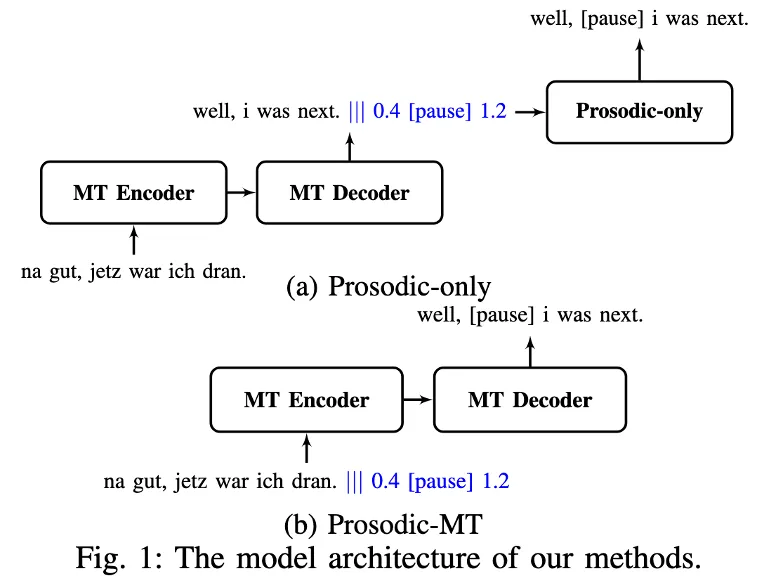
Prosidic Model:在翻译模型后接入一个代理模型,预测停顿位置,将源语言的停顿节奏迁移到目标语言中 。
Length-Aware Beam Search:微软的一项工作提出通过“Short/Normal/Long”标签来训练模型预测不同长度的输出。在解码时,开启三组并行 Beam Search,分别生成不同长度的假设,最后选择与源语音时长最接近的结果 。
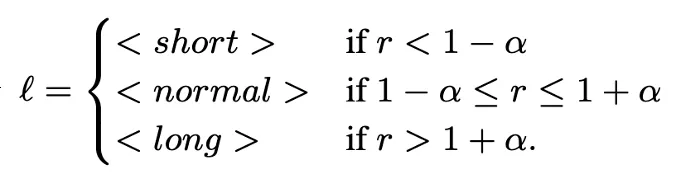
基于大模型的数据驱动重音迁移:
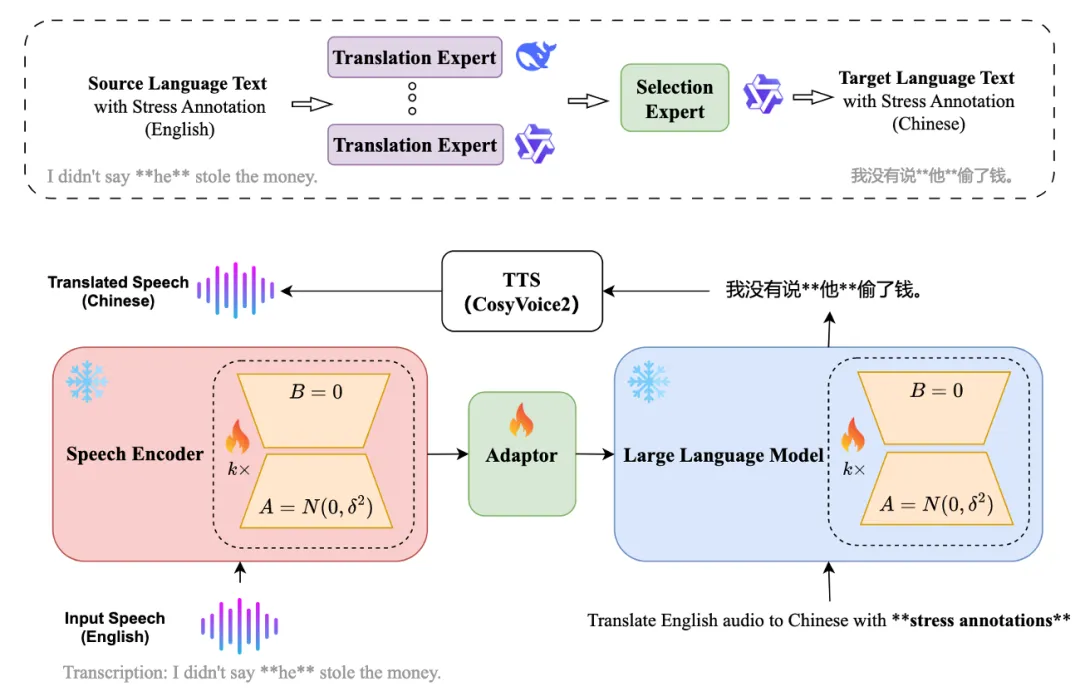
利用大模型对训练文本进行打标(标注重音符号),然后训练模型生成带有重音标记的文本,最后输入给 TTS 模型(如 CosyVoice)合成 。
局限性:由于 TTS 模块可能未针对这些标签进行微调,目前的重音还原效果并不明显,性能在语音到语音任务中会有所下降 。
基于特征解耦的端到端时长,韵律控制:
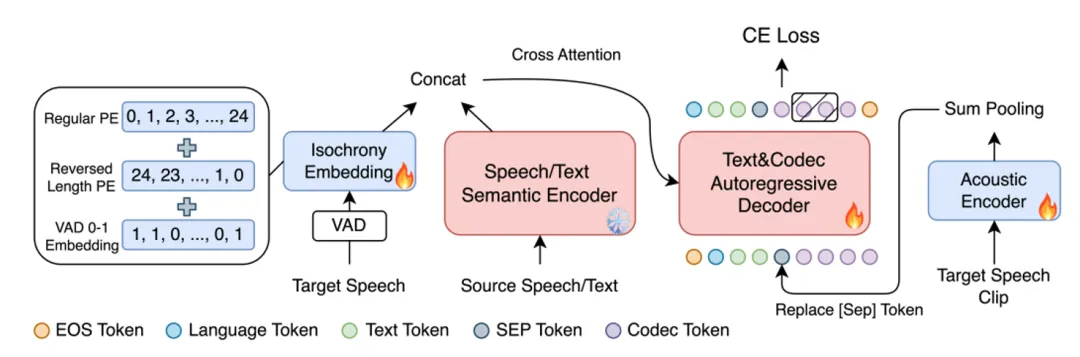
在缺乏大规模数据标注的情况下,可以通过特征解耦的方法(如 TransVIP 工作),在训练时使用 Target Speech 的副语言信息,推理时使用 Source Speech 的信息,实现音色和说话状态的零样本迁移 。未来的方向是将 Pitch(音高)、重音等更多特征加入解耦框架中 。
三、All-in-One Models(全能端到端模型)
目前的趋势明显指向端到端(End-to-End)的大模型方案,其核心竞争力在于大规模的数据构建能力。
代表性模型与趋势
Hibiki (Kyutai):
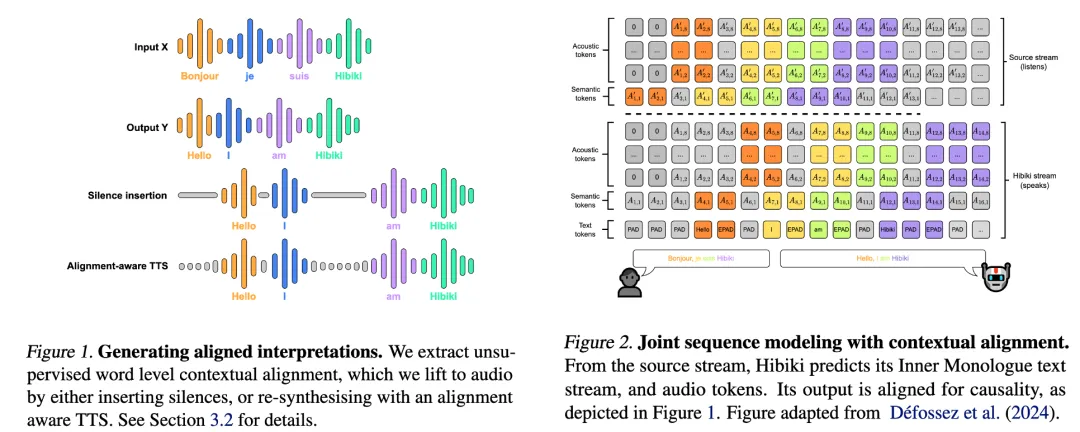
这是一个全双工(Full-duplex)模型,非常适合实时交互 。
数据工程:通过复杂的对齐与合成流程构建数据。它先对齐输入输出文本,然后重新合成语音以确保高质量和完美的 Voice Cloning 能力,从而实现纯数据驱动的训练 。
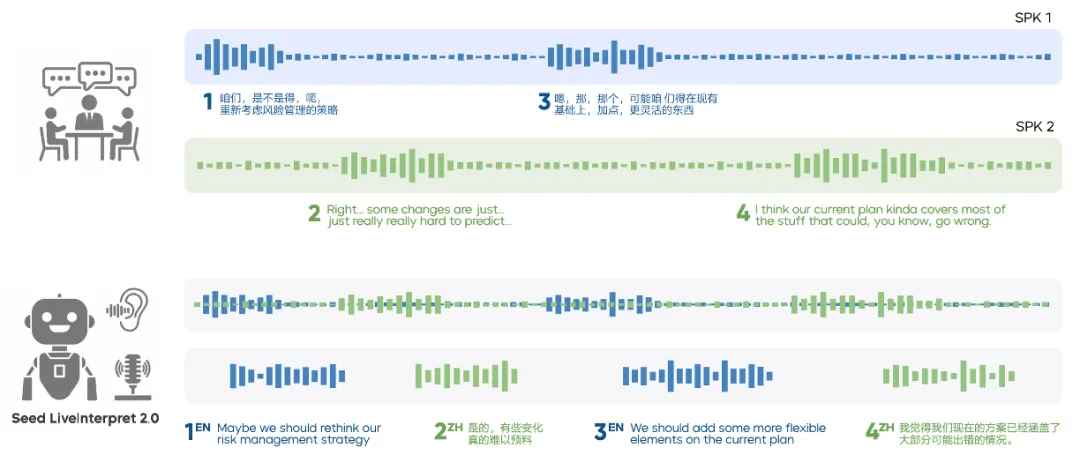
Seed LiveInterpret (ByteDance):
目前被认为是中英翻译性能最好的模型之一(SOTA) 。 其完全依赖依赖数据驱动和强化学习(RL)。通过数据驱动的方式,其利用大模型构建了端到端的同传数据,此外,其技术报告指出,它通过 RL 优化各种 Reward,包括翻译开始时间、质量、指令遵从度、格式一致性和延迟等 。
四、总结
当前的语音翻译技术正处于从“能用”到“好用”的跨越期。无界流式处理解决了时长限制,副语言迁移提升了拟人化体验,而All-in-One 模型则通过暴力美学般的数据工程和强化学习,正在重新定义行业的性能天花板 。对于研究者而言,如何在不依赖大厂级数据规模的前提下,通过算法创新(如更好的时长控制或解耦策略)实现性能突破,仍是值得探索的方向。
供稿:乐辰阳,编辑:方楠,审核:韩冰
