
 语音小管家
AudioCC交我学
作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。我们将用通俗易懂的语言拆解复杂理论,用数据与实验结果验证技术价值,带你快速了解最新、最有趣的学术论文,打破学术与大众之间的壁垒,让你在碎片化的时间里也能 get 到前沿知识!
一、可控语音生成
可控语音生成的目标是在保证语音自然度和可懂度的前提下,实现对多种语音属性的精确调控。这些属性通常包括韵律(Prosody)、音色(Timbre)、情绪(Emotion)、风格(Style)、语言(Language)以及环境(Environment)等。高质量的可控语音生成技术在虚拟助手、有声书、影视配音、游戏角色语音生成等场景中具有广泛的应用价值和实际意义。
二、经典模型架构
1. PromptTTS
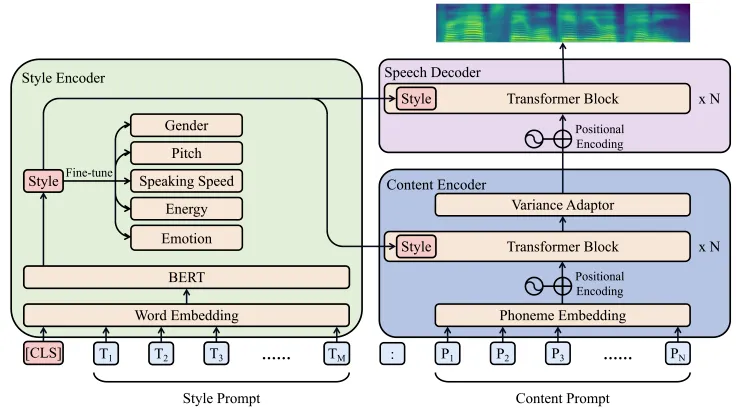
PromptTTS 是早期可控语音合成领域中非自回归方法的代表性模型之一,其整体架构由风格编码器、内容编码器和语音解码器组成。该模型的核心思想在于引入显式的风格表示(Style Representations),并以此对语音生成过程进行条件约束与引导。
在具体实现上,PromptTTS 通过设计辅助任务对 BERT 进行微调,使其能够更充分地建模与语音风格相关的语义信息。随后,模型将提取到的风格表示逐层注入 Transformer 结构中,从而在编码与解码阶段持续强化风格条件的影响。整体而言,PromptTTS 主要侧重于全局层面的风格建模,在细粒度、局部控制上仍存在一定局限。
2. Salle
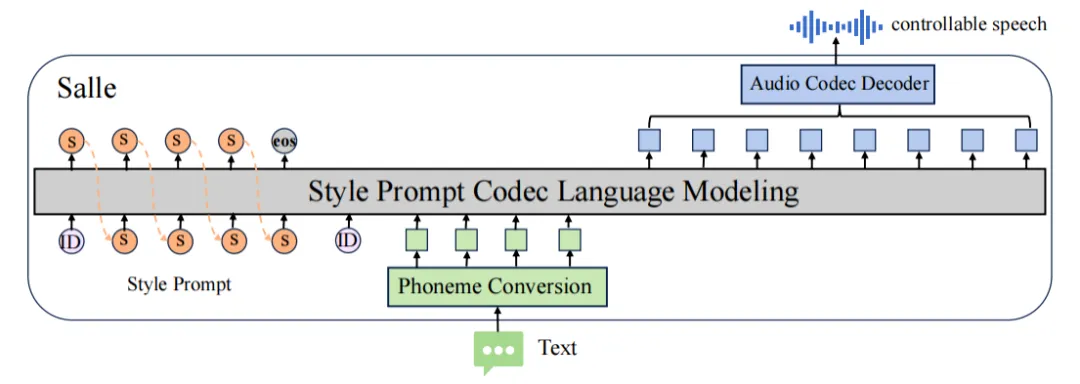
Salle 是可控语音合成的一种自回归方法,其整体架构基于 Transformer 自回归解码框架构建,通过自回归方式逐步生成声学特征,从而有效建模语音序列中的长程时序依赖关系。
在具体实现上,Salle 将包含风格信息的自然语言指令进行编码,作为条件输入,与文本内容表示共同参与自回归解码过程,使模型在每一个生成步均能够同时感知全局语义与风格约束。相较于非自回归方法,Salle 在韵律连续性、细节表达及语音自然度方面具有一定优势。
3. CosyVoice:AR + NAR 的混合范式
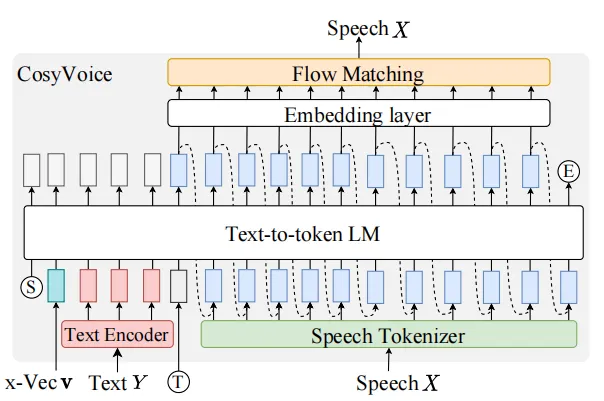
CosyVoice 采用自回归与非自回归相结合的混合式架构。其中,自回归语言模型负责对文本语义与韵律结构进行建模,生成高层次的语义与韵律表示;基于条件流匹配的声学生成模型则用于生成 Mel 频谱,并对音色特征及环境相关信息进行精细化建模与控制。通过这种分工明确的设计,模型在保证语义一致性的同时,实现了高质量且具有良好可控性的声学生成。
CosyVoice 的关键创新之一在于引入了通过自监督学习获得的语音语义 token。具体而言,该方法从 ASR 模型编码器的中间层提取表示,并通过向量量化方式将其离散化,从而获得与文本语义高度对齐的离散语音单元。这一设计显著提升了生成语音的内容一致性,并在零样本语音克隆场景中展现出优越性能。
在此基础上,CosyVoice-Instruct 进一步引入指令微调,使模型能够理解自然语言形式的风格、情绪与表达方式描述,从而实现更加灵活且细粒度的语音控制能力。
三、细粒度指令控制
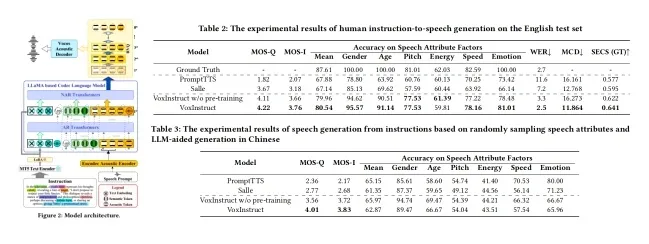
自然语言驱动的细粒度语音属性控制仍然是可控语音合成领域中相对欠缺系统研究的方向。针对这一问题,VoxInstruct 提出了一种基于 LLaMA 架构的指令式语音生成框架,通过统一的自然语言指令实现对语音细粒度属性的建模与控制。
在模型设计上,VoxInstruct 将风格描述(description)与文本内容(content)组合成灵活的自然语言“指令”(instruction)作为输入。模型首先采用自回归方式生成语义 token,这些 token 能够辅助模型准确区分并理解指令中所包含的语义内容,从而消除了对额外音素序列输入的依赖。随后,模型进一步生成声学表示:一方面以自回归方式生成粗粒度声学 token(对应第一层量化器的输出),另一方面以非自回归方式并行生成细粒度声学 token(对应剩余量化器的输出),在建模效率与表达精度之间取得平衡。
实验结果表明,相较于 PromptTTS 主要关注文本提示与全局语音风格嵌入之间映射关系的方法,以及 Salle 将内容与风格提示分离建模的策略,VoxInstruct 在细粒度表达能力和控制灵活性方面展现出明显优势。
四、多模态可控语音生成
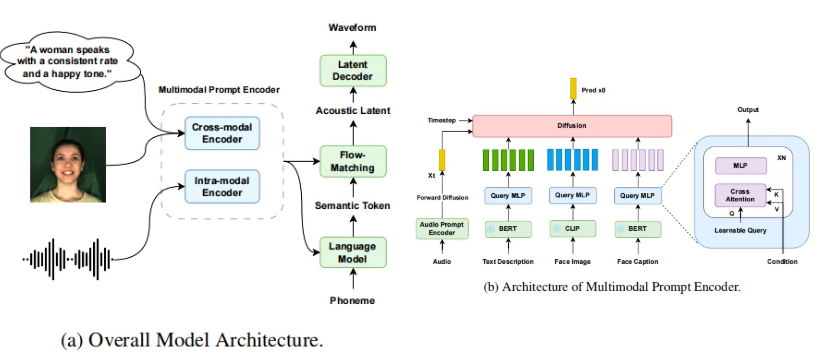
从多模态输入(如文本、图像与视频)合成语音具有广泛的应用前景。FleSpeech 进一步拓展了可控语音合成的输入边界,引入了多模态提示机制,使模型能够同时利用多种模态信息进行语音生成。
具体而言,FleSpeech 支持多种类型的提示输入,包括文本形式的风格描述、参考语音,以及人脸图像或视频等视觉信息。其核心组件为多模态 Prompt 编码器(Multimodal Prompt Encoder, MPE)。该模块采用基于查询的结构,通过引入若干可学习的查询 token,从不同模态提示的表示中提取与语音生成相关的关键信息,并将来自不同模态的特征映射到统一的参考音频嵌入空间,从而实现跨模态对齐与融合。
针对“同一风格描述可能对应多种说话方式”这一内在多样性问题,FleSpeech 采用基于扩散模型的建模策略,以显式刻画语音表达的多样性分布。通过上述设计,FleSpeech 在多模态条件下实现了更加灵活且多样化的可控语音生成能力。
五、数据生成与标注
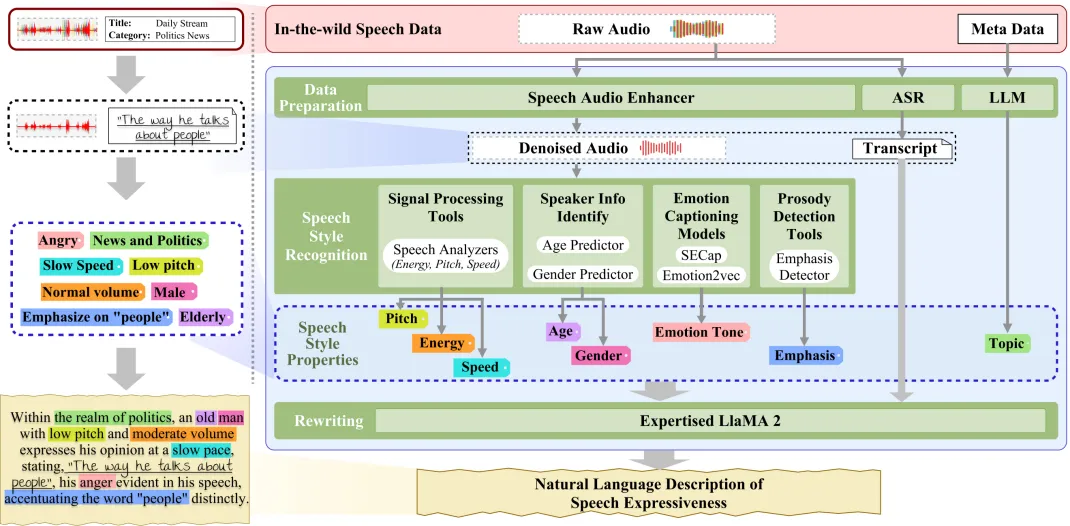
高质量数据始终是可控语音合成面临的核心瓶颈之一。现有数据集普遍缺乏内容与应用场景的多样性,在细粒度标注方面更是稀缺;人工标注不仅成本高昂,而且主观性强、一致性难以保证。
为解决这一问题,SpeechCraft 提出了一套自动化语音标注与数据生成系统,以显著降低人工细粒度标注的成本。该方法首先利用预训练模型从语音中自动提取或预测多维属性特征,再借助大语言模型将这些特征转写并重构为自然语言描述,实现高质量、可扩展的指令式语音标注。
此外,为生成细粒度的重音平行数据,SpeechCraft 基于 FastSpeech 2 的声学生成框架引入控制式合成策略。具体而言,模型通过调节 Variance Adapter 中音素级的音调、能量与时长预测,在关键词位置合成具有明确重音特征的语音样本,从而为重音可控建模提供高质量的平行训练数据。
六、结语
随着可控语音生成技术的发展,未来的研究方向将更加聚焦于精细化控制、多模态融合以及高质量数据驱动的可扩展性。一方面,如何在保持语音自然度与可懂度的前提下,实现对多维属性的精准、细粒度控制,是提升生成质量和用户体验的关键。另一方面,融合文本、图像、视频等多模态信息,将为语音生成提供更丰富的上下文和更灵活的交互方式。此外,高质量、可扩展的数据标注与生成技术仍是支撑精细控制和多样化表达的重要保障。
