
 语音小管家
AudioCC交我学
作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。我们将用通俗易懂的语言拆解复杂理论,用数据与实验结果验证技术价值,带你快速了解最新、最有趣的学术论文,打破学术与大众之间的壁垒,让你在碎片化的时间里也能 get 到前沿知识!
一、音乐源分离
音乐源分离(Music Source Separation, MSS)旨在从混合音乐信号中恢复若干目标声源(声部/乐器)的近似“干净”信号[1]。在研究实践中,音乐源分离往往不是对“所有可能的声音”进行任意分解,而是在预设好的声部体系下进行。最常见的设定是将流行音乐分为 vocals、drums、bass 和 other 四类,也就是常说的VDBO四轨分离。
这一研究方向的发展,与数据集建设密切相关。在流行音乐场景中,常用的代表性数据集包括MedleyDB[2]、MedleyDB 2.0[3]、MUSDB18[4] 、MUSDB18-HQ[5]、Slakh2100[6]、MoisesDB[7]等。
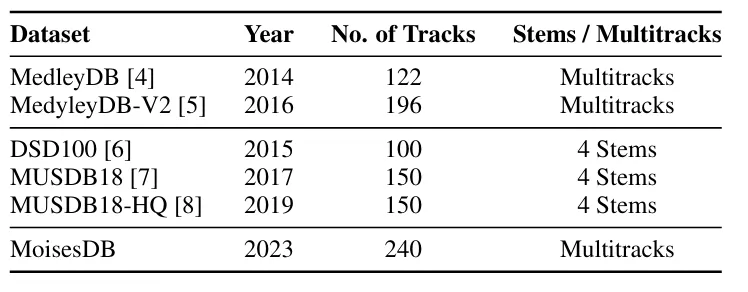
图1 不同流行音乐数据集信息对比[7]
相比之下,古典音乐场景下的数据获取要困难得多。一方面,古典音乐中的乐器种类和编制往往更加复杂;另一方面,真实合奏中的混合关系也不总能被简单视为各轨线性叠加。因此,古典音乐源分离长期面临更明显的数据稀缺问题。现有较有代表性的相关数据集包括 URMP[8]、Bach10[9]、MusicNet[10]、MAESTRO[11],以及较新的The Spheres Dataset[12],它们分别覆盖了室内乐、多乐器演奏、钢琴独奏以及交响乐等不同场景。
从模型方法上看,音乐源分离近年来的发展呈现出清晰的三条线:(1)频谱域方法:在时频图上预测掩码并重建,例如Open-Unmix[13] , Spleeter[14]等;(2)波形域方法:在时域端到端直接输出声源波形,例如Conv-TasNet[15],Demucs[16],Wave-U-Net[17]等;(3)频带划分/混合域方法:将频带切分后分别建模再融合,或是对波形域和时频域都进行建模,如Hybrid Demucs[18],BSRNN[19],TFC-TDF-Unet v2、v3[20,21],BS-RoFormer[22]等。
尽管音乐源分离近年来取得了显著进展,但这一任务距离稳定、通用和高质量地落地应用,仍然面临多方面挑战。首先,在数据层面,现有数据集的规模、覆盖范围和标注质量仍然有限,模型训练中还常常受到标签噪声以及不同声部之间串音(bleeding)问题的影响,因此需要更多高质量数据,以及更有效的数据增强和鲁棒训练策略。其次,在泛化能力与灵活性方面,现实音乐场景往往比标准数据集更复杂,既可能包含更多待分离声部,也可能涉及不同编制、风格和录制条件,这对模型在多样化场景中的适应能力提出了更高要求。与此同时,模型效率和参数规模也是不可忽视的问题:更强的分离性能往往依赖更复杂、更庞大的模型,但这会进一步增加训练和推理成本,限制其实时性和部署能力。最后,评测指标本身也仍有讨论空间。如何更全面地衡量分离结果在信号质量、感知效果和实际应用价值上的表现,仍然是该领域需要持续推进的重要问题。
二、轻量化架构——DTTNet(ICASSP 2024)
随着模型不断变大,轻量化成为音乐源分离中的一个重要研究方向。DTTNet试图在保持较好分离能力的同时,降低模型参数量和推理开销,其核心思路是结合TFC-TDF-UNet与BSRNN的设计优势,如图2所示在整体上保留 U-Net 式的编码器—解码器框架,但是精简了层数以大幅减少参数量,同时在中间隐空间中加入改进的双路径模块,以增强时频建模能力。与BSRNN中的模块不同的是,这个改进的双路径模块在特征送入时会在通道维度再做一次划分,以大幅度加速推理。
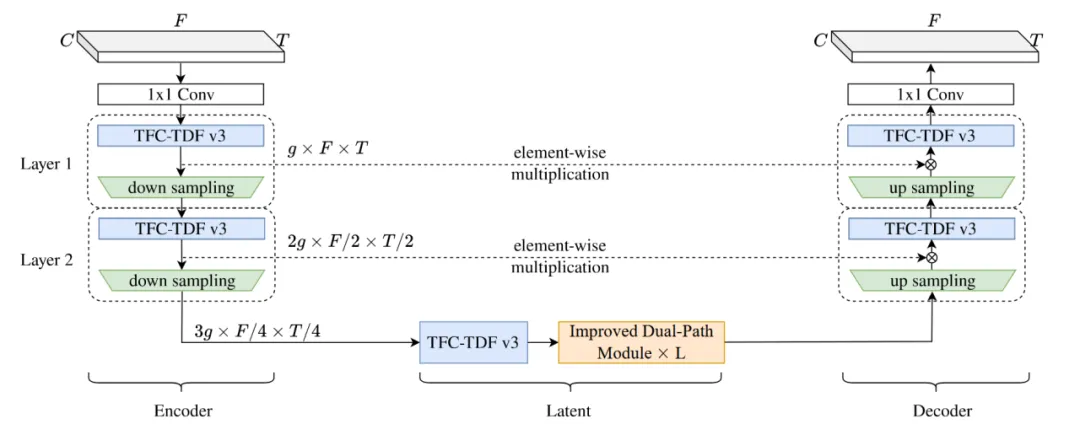
图2 DTTNet架构[23]
如图3所示,从与已有方法的比较来看,DTTNet的主要优势集中在vocal和other这两个类别上,说明它更适合处理中高频成分较多的分离任务。相比之下,在drum和bass这样的低频声部上,它的表现偏弱。这一点其实很符合直觉:在参数和结构都被压缩的情况下,模型对于低频长时结构和复杂谐波重叠的建模能力往往更容易受损。另一方面,DTTNet的参数量相较更重的模型确实有明显下降,相较BSRNN减少约 86%,也比TFC-TDF-UNet更小,只是由于其中仍然包含RNN结构,推理速度并没有像参数量那样得到同等幅度的改善。
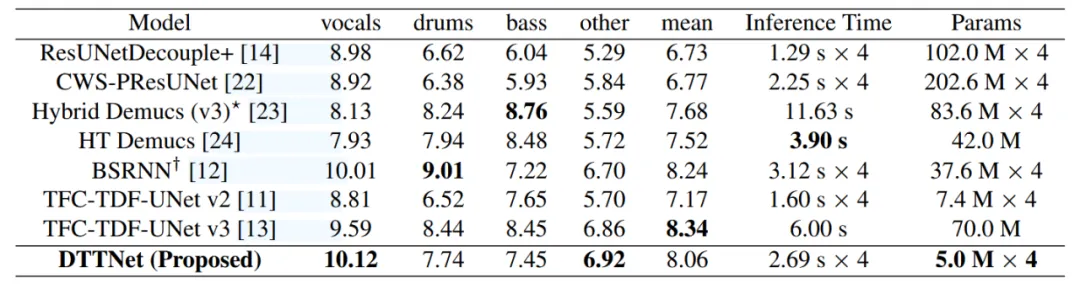
图3 DTTNet在MUSDB18-HQ数据集上的cSDR、推理时间和参数量的对比实验结果[23]
除了标准四轨分离外,这篇文章还专门做了一个泛化性实验。作者额外引入了五种 MUSDB18 中没有的新声源,包括Wah Guitar、Horns、Sirens、Up-filters和Vocal Chops。其中只把原有的vocal与新增的Vocal Chops作为分离目标,重点考察模型面对未见过声源时的适应性。训练策略是在MUSDB18-HQ上训练好的vocal模型基础上微调300轮,并区分训练集中是否包含Vocal Chops的两种情形,分别记为DTT+VC和DTT+NVC。实验结果如图4所示,若不进行微调,测试集中一旦加入任何一种新声源,分离性能都会明显下降;全部加入后下降尤其严重。相比之下,只加入 Vocal Chops 时,性能下降没有那么剧烈;微调之后,大多数情况下分离效果都能明显回升,而且训练集包含 VC 的版本总体优于不含 VC 的版本。
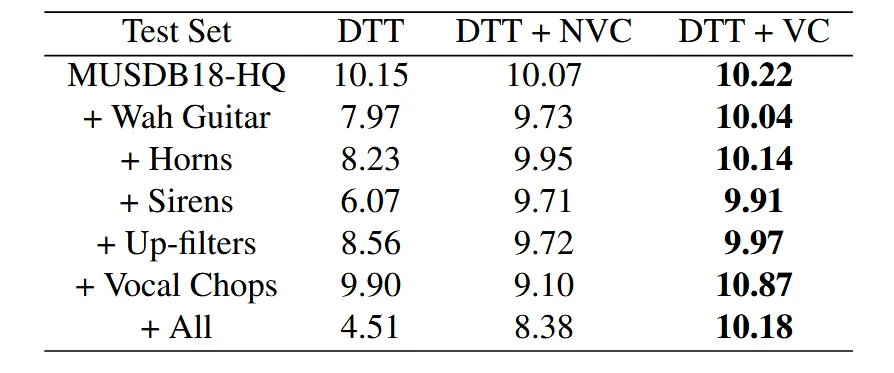
图4 DTTNet泛化性实验结果,测试指标为uSDR[23]
三、超越四轨的可扩展分离——Banquet(ISMIR 2024)
长期以来,四轨分离之所以流行,很大程度上是因为数据集和评测体系都围绕这一设定构建。但真实音乐远比四类声部复杂。除了主唱、鼓和贝斯之外,实际作品中还可能包含多种吉他、钢琴、铜管、弦乐、合成器、和声甚至环境音轨。若每增加一种声部就训练一个新模型,那么模型数量和系统成本几乎会线性增长,这显然不利于扩展。
Banquet 提出query-based、stem-agnostic的单解码器框架,不再为每一种声部单独训练一个解码器,而是通过查询音频引导模型提取目标声部。因此,它更准确地说是一种带条件的目标源提取框架。具体来说,如图5所示,Banquet 包含四个主要部分:第一部分是Mix Encoder,用来对输入混合音频进行编码;第二部分是 Query Encoder,用来对查询音频进行编码,作者使用的是预训练好的PaSST模型,其训练基础来自OpenMIC-2018,并覆盖了MoisesDB中大多数粗粒度乐器类别;第三部分是Query Adapter,它会把查询音频的逐帧特征聚合并降维,再通过一个单层FiLM模块,把查询条件注入混合音频表示中,突出其中与目标stem对应的成分;第四部分是Decoder,通过频带加权和重叠相加得到最终谱掩码,重建目标音频。
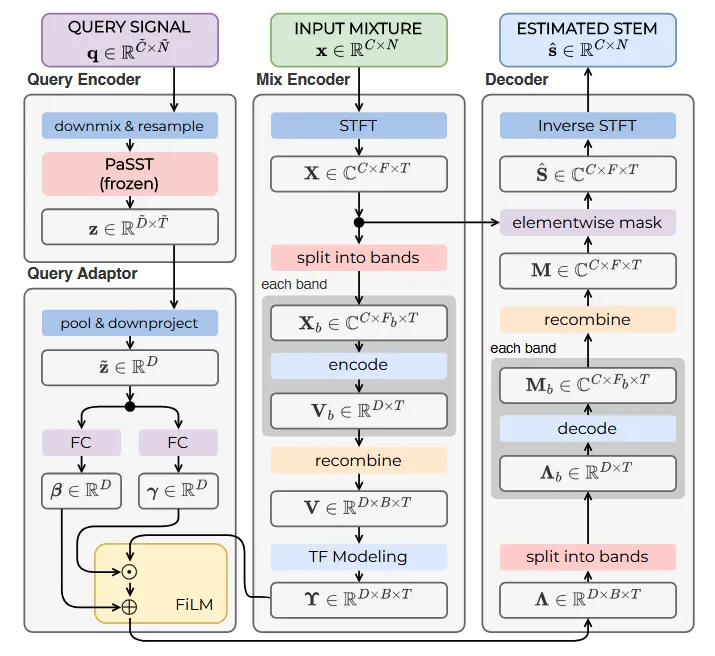
图5 Banquet模型架构[24]
在实验上,Banquet 主要基于MoisesDB数据集展开验证。该数据集包含11个粗类别和30余个细类别,适合用来考察超越传统四轨的可扩展性。作者使用查询音频作为条件输入,分别测试了同曲目查询和跨曲目查询两种查询模式,并比较了从头训练、使用预训练编码器、冻结或继续训练编码器等不同策略。实验结果表明,预训练编码器对训练稳定性和最终性能都非常重要,相比从头训练,基于VDBO任务预训练得到的编码器通常效果更好。进一步扩展到guitar、piano等更多类别时,如图6所示,模型仍然能够工作。
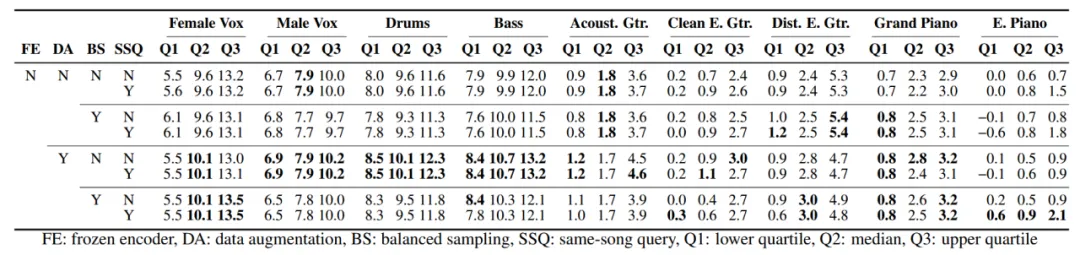
图6 Banquet扩展到VDBGP的细类别SNR实验结果[24]
不过,随着类别继续增多,在更细粒度、长尾分布更明显的乐器类别上,训练稳定性下降,分离效果也明显变差,SNR在0dB上下浮动。作者的分析指出,这与数据本身的长尾特性密切相关:许多新增乐器在数据集中出现次数少、能量低、与其他声部重叠严重,因此即使模型结构上支持更多乐器,实际性能仍然会受到数据分布的明显限制。
因此,超越四轨分离并不是一个单纯的模型设计问题。它同时也是一个数据分布问题、标签体系问题。模型结构上的可扩展,并不自动等于分离性能上的可靠扩展;当类别继续变细、数据继续变稀疏时,数据质量与分布问题仍然会成为主要瓶颈。
四、音乐性数据增广——钢琴协奏曲分离(TASLP 2024)
与流行音乐相比,古典音乐中的多轨干净数据更难获取。因此,在古典音乐源分离中,数据增强往往不仅是训练技巧,更是任务成立的重要前提。
以《Source Separation of Piano Concertos Using Musically Motivated Augmentation Techniques》这篇文章为例,该工作聚焦于钢琴协奏曲中的钢琴与乐队的分离,提出了一套更具音乐性的数据增强策略,用来弥补真实训练数据的不足。具体来说,如图7所示,主要包括以下四类:
随机混音(Random Mixing):将独奏钢琴片段与不含钢琴的管弦乐片段随机叠加,合成新的训练样本。
和声适配(Harmonic Adaptation):利用色度特征(chroma feature)衡量钢琴片段与管弦片段之间的和声关系,并通过移调使二者在调性上更加一致,再进行混合。
齐奏混音(Unison Mixing):利用“管弦作品的钢琴改编版”这类素材,将钢琴与乐队录音进行时间对齐,构造出二者在旋律和节奏上高度重叠的训练样本。
静音掩蔽(Silence Masking):随机将钢琴轨或乐队轨的部分片段置零,但不同时将两者都置零,以模拟协奏曲中常见的“交替出现”结构。
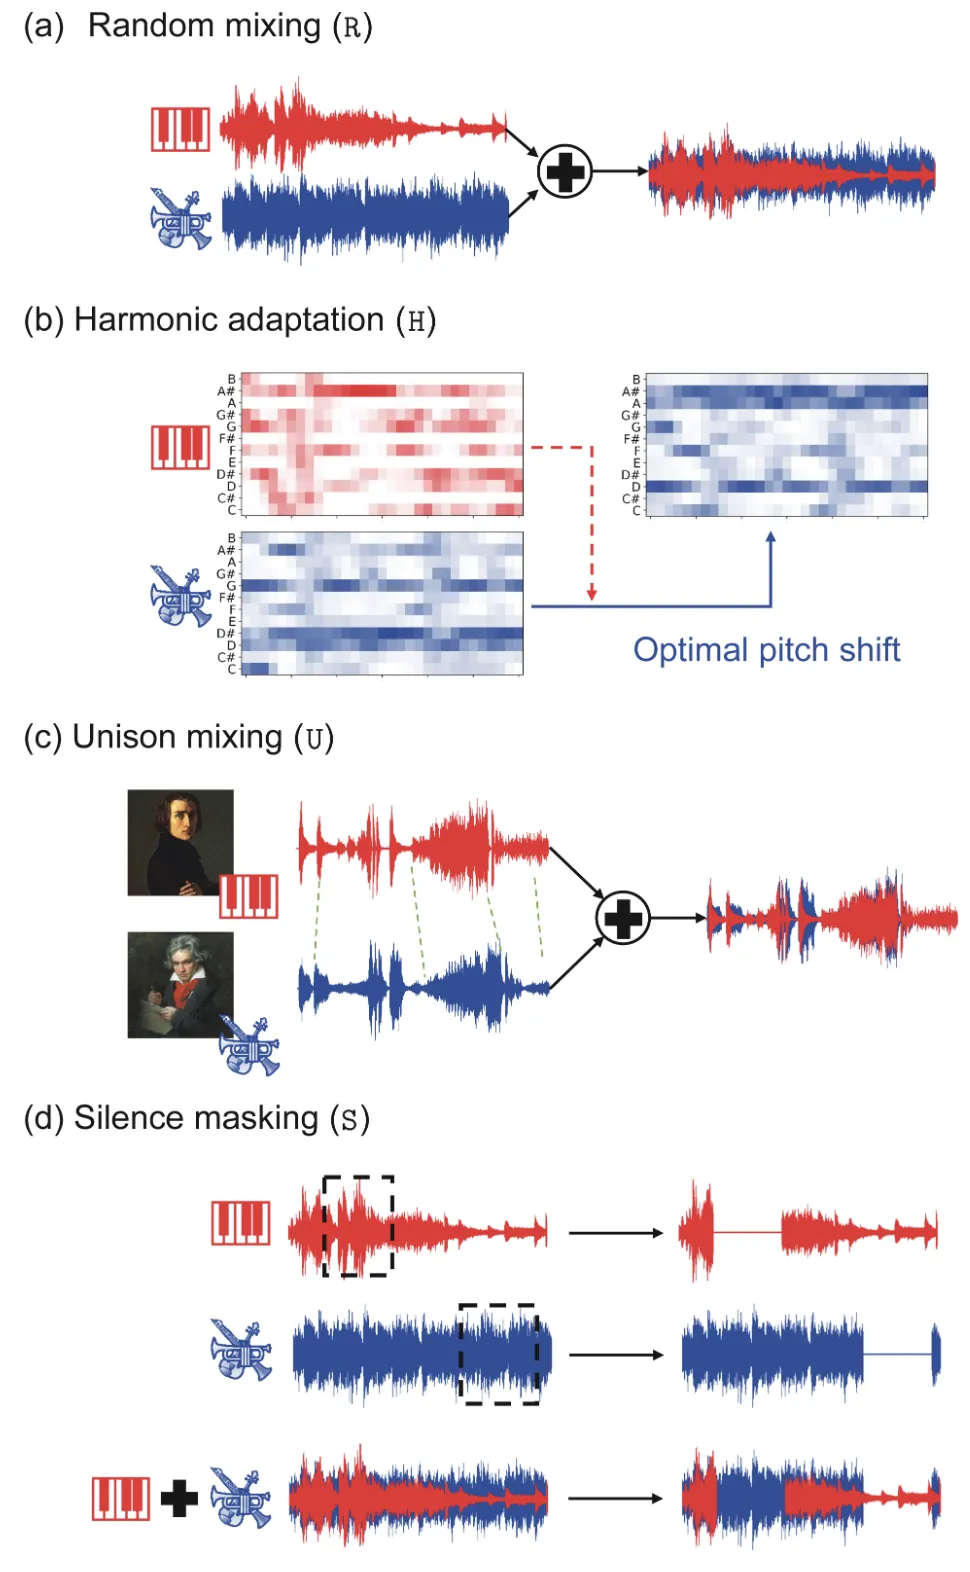
图7 音乐性数据增强方法示意图[25]
文章比较了四种已有模型:Open-Unmix、Spleeter、Demucs和Hybrid Demucs。前两者是频域方法,Demucs是波形域方法,Hybrid Demucs同时建模时域和频域信息,最后将频域和时域分支的结果融合,通常被视为这几者中性能最强的模型。
在实验中,作者将不同增强策略逐步加入训练过程,结果如图8所示,Hybrid Demucs 是整体表现最好的模型。对于较强的混合域模型,和声适配和齐奏混音能够带来明显提升,相比之下,静音掩蔽的效果没有那么稳定;对能力较弱或结构较简单的模型而言,增强并不一定总能转化为收益,甚至可能导致性能下降。这证明增强策略越复杂、越接近真实场景,往往也越要求模型具备足够强的表示和学习能力。
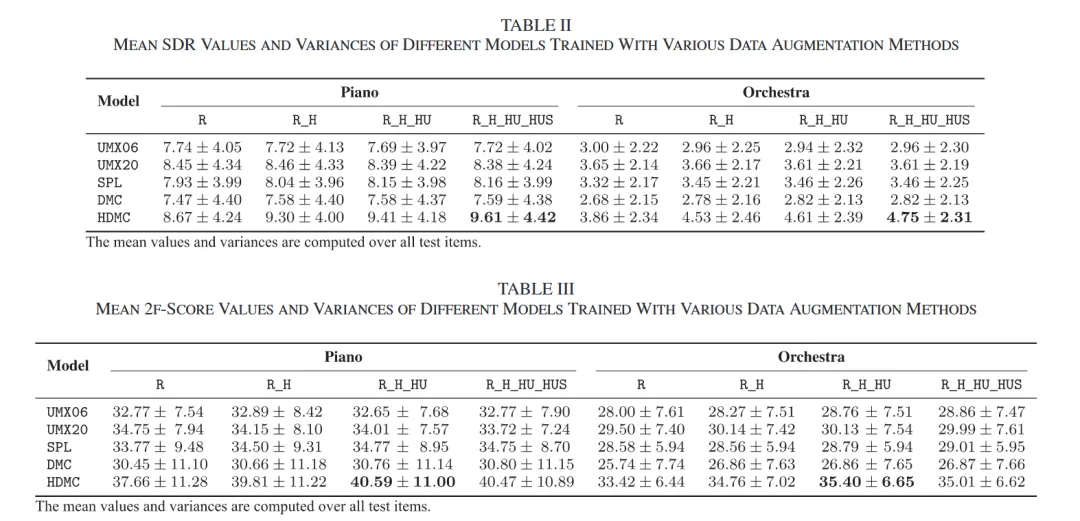
图8 四种模型在钢琴协奏曲分离上的实验结果[25]
五、总结
综合来看,当前音乐源分离的发展正在呈现出以下几个趋势:
性能与效率之间的权衡将长期存在。更大的模型通常意味着更强的建模能力,但也意味着更高的训练与部署成本。轻量化、实时化和流式处理因此不会只是工程问题,而会逐渐成为研究本身的一部分。
超越固定四轨的需求会越来越强。未来的音乐分离系统若想真正服务于创作、编辑、检索和交互式应用,就不能始终停留在固定的VDBO框架中。如何在更多声部、更细类别甚至开放类别条件下保持可靠性,将是一个关键方向。
数据质量与数据构造方式的重要性正在上升。尤其在古典音乐、长尾乐器和复杂编制场景中,仅依赖现成数据集远远不够。如何通过更贴近音乐规律的数据增强、外部数据引入以及更合理的标签体系,提升模型对真实场景的适应能力,将是未来研究的重要支点。
评测方式仍需继续完善。单一的客观指标并不能完整反映分离质量,主观听感、感知质量以及具体应用目标之间的关系,仍需要更系统的研究。
从这个意义上说,音乐源分离的未来未必只是“更高的SDR”或“更好的排行榜名次”,而更可能是朝着多个方向同时推进:更轻量,意味着更容易部署;更灵活,意味着能处理更真实的音乐结构;更贴近场景,意味着研究问题本身将更加面向实际应用。
对于这一领域而言,真正重要的也许不只是把声音分开,而是让模型在复杂而多样的音乐世界中,学会以合适的方式去理解和拆解声音。
六、参考文献
[1] E. Cano, D. FitzGerald, A. Liutkus, M. D. Plumbley and F. -R. Stöter, "Musical Source Separation: An Introduction," in IEEE Signal Processing Magazine, vol. 36, no. 1, pp. 31-40, Jan. 2019.[2] R. Bittner, J. Salamon, M. Tierney, M. Mauch, C. Cannam and J. P. Bello, "MedleyDB: A Multitrack Dataset for Annotation-Intensive MIR Research", in 15th International Society for Music Information Retrieval Conference, Taipei, Taiwan, Oct. 2014.[3] Bittner, R., Wilkins, J., Yip, H., & Bello, J. (2016). MedleyDB 2.0: New Data and a System for Sustainable Data Collection. New York, NY, USA: International Conference on Music Information Retrieval (ISMIR-16).[4] Z. Rafii, A. Liutkus, F.-R. Sto ̈ter, S. I. Mimilakis, and R. Bittner, “The MUSDB18 corpus for music separation,” Dec. 2017.[5] Z. Rafii, A. Liutkus, F.-R. St ̈oter, S. I. Mimilakis, and R. Bittner, “Musdb18-hq - an uncompressed version of musdb18,” Aug. 2019.[6] E. Manilow, G. Wichern, P. Seetharaman, and J. Le Roux, “Cutting music source separation some Slakh: A dataset to study the impact of training data quality and quantity,” in Proc. of the IEEE Workshop on Applications of Signal Processing to Audio and Acoustics (WASPAA), 2019.[7] I. Pereira, F. Araújo, F. Korzeniowski, and R. Vogl, “MoisesDB: A Dataset for Source Separation Beyond 4-Stems,” in Proceedings of the 24th International Society for Music Information Retrieval Conference, Milan, Italy, 2023, pp. 619-626.[8] B. Li, X. Liu, K. Dinesh, Z. Duan, and G. Sharma, “Creating a multitrack classical music performance dataset for multimodal music analysis: Challenges, insights, and applications,” IEEE Transactions on Multimedia, vol. 21, no. 2, pp. 522–535, 2018.[9] Z. Duan and B. Pardo, “Soundprism: An online system for score-informed source separation of music audio,” IEEE J. Sel. Topics Signal Process., vol. 5, no. 6, pp. 1205–1215, Oct. 2011.[10] J. Thickstun, Z. Harchaoui, and S. M. Kakade, “Learning Features of Music from Scratch,” in Proc. Int. Conf. Learn. Representations, 2017.[11] C. Hawthorne et al., “Enabling factorized piano music modeling and generation with the MAESTRO dataset,” in Proc. Int. Conf. Learn. Representations, New Orleans, Louisiana, USA, 2019, pp. 1–12.[12] J. Garcia-Martinez, D. Diaz-Guerra, J. Anderson, R. Falcón-Pérez, P. Cabañas-Molero, T. Virtanen, J. J. Carabias-Orti, and P. Vera-Candeas, “The Spheres Dataset: Multitrack Orchestral Recordings for Music Source Separation and Information Retrieval,” arXiv preprint arXiv:2511.21247, 2025.[13] F.-R. Stöter, S. Uhlich, A. Liutkus, and Y. Mitsufuji, “Open-Unmix - A Reference Implementation for Music Source Separation,” Journal of Open Source Software, vol. 4, no. 41, p. 1667, 2019.[14] R. Hennequin, A. Khlif, F. Voituret, and M. Moussallam, “Spleeter: a fast and efficient music source separation tool with pre-trained models,” Journal of Open Source Software, vol. 5, no. 50, p. 2154, 2020.[15] Y. Luo and N. Mesgarani, “Conv-TasNet: Surpassing Ideal Time-Frequency Magnitude Masking for Speech Separation,” IEEE/ACM Trans. Audio, Speech, and Language Processing, 2019.[16] A. Défossez, N. Usunier, L. Bottou, and F. Bach, “Music Source Separation in the Waveform Domain,” arXiv preprint arXiv:1911.13254, 2019.[17] D. Stoller, S. Ewert, and S. Dixon, “Wave-U-Net: A Multi-Scale Neural Network for End-to-End Audio Source Separation,” in Proc. ISMIR, 2018.[18] A. Défossez, “Hybrid spectrogram and waveform source separation,” in Proc. ISMIR Workshop Music Source Separation, 2021, pp. 1–13.[19] Y. Luo and J. Yu, “Music source separation with bandsplit rnn,” IEEE/ACM Transactions on Audio, Speech, and Language Processing, vol. 31, pp. 1893–1901, 2023.[20] M. Kim, W. Choi, J. Chung, D. Lee, and S. Jung, “KUIELab-MDX-Net: A Two-Stream Neural Network for Music Demixing,” in Proc. of the MDX Workshop at ISMIR, 2021.[21] M. Kim, J. H. Lee, and S. Jung, “Sound Demixing Challenge 2023 Music Demixing Track Technical Report: TFC-TDF-UNet v3,” arXiv preprint: arXiv:2306.09382, 2023.[22] W.-T. Lu, J.-C. Wang, Q. Kong, and Y.-N. Hung, “Music source separation with band-split rope transformer,” in ICASSP 2024-2024 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2024, pp. 481–485.[23] J. Chen, S. Vekkot, and P. Shukla, “Music source separation based on a lightweight deep learning framework (dttnet: Dual-path tfctdf unet),” in ICASSP 2024-2024 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2024, pp. 656–660.[24] K. N. Watcharasupat and A. Lerch, “A Stem-Agnostic Single-Decoder System for Music Source Separation Beyond Four Stems,” in Proc. of the 25th International Society for Music Information Retrieval Conference (ISMIR), San Francisco, CA, USA, 2024.[25] Y. Özer and M. Müller, "Source Separation of Piano Concertos Using Musically Motivated Augmentation Techniques," in IEEE/ACM Transactions on Audio, Speech, and Language Processing, vol. 32, pp. 1214-1225, 2024
供稿:傅思婳,编辑:方楠,审核:韩冰
