
 语音小管家
AudioCC交我学
作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。我们将用通俗易懂的语言拆解复杂理论,用数据与实验结果验证技术价值,带你快速了解最新、最有趣的学术论文,打破学术与大众之间的壁垒,让你在碎片化的时间里也能 get 到前沿知识!
一、任务介绍
1.1 什么是多模态神经机器翻译?
多模态神经机器翻译(Multimodal Neural Machine Translation, MNMT)是一种将视觉信息(如图像)与文本数据相结合,以提升翻译性能的前沿技术。与传统的神经机器翻译(NMT)仅依赖文本不同,MNMT 充分利用图像中蕴含的语言无关信息,为翻译提供额外的语义线索。
1.2 为什么需要多模态翻译?
在现实场景中,文本往往伴随着其他模态的数据。例如:
• 跨境电商:商品描述配有多角度产品图片
• 社交媒体:帖子内容附带照片或视频
• 新闻报道:新闻文本搭配现场图片
这些视觉信息携带着宝贵的语义内容,能够帮助消除歧义、理解上下文,尤其在处理模糊表达、性别相关词汇和领域专业术语时效果显著。
1.3 任务定义
MNMT 的核心目标是:在源语言到目标语言的翻译过程中,融合视觉模态信息,生成更准确、更符合语境的译文。
该任务最早在 WMT 2016 共享任务中正式提出(Specia et al., 2016),此后迅速成为自然语言处理和计算机视觉交叉领域的研究热点。
二、任务分析
2.1 两大核心场景
MNMT 研究主要聚焦于两种场景:
(1)图文语义对齐场景
图像与文本在语义上高度一致,视觉信息能够直接辅助翻译。
(2)图文语义噪声场景
图像与文本语义不相关或存在干扰,模型需要具备鲁棒性以避免被误导。
挑战:在噪声场景下,模型若过度依赖视觉信息,可能产生错误翻译。
2.2 MNMT 的优势
相比传统 NMT,MNMT 在以下方面表现突出:
• 消歧能力:利用视觉信息消除多义词歧义
• 上下文理解:通过图像补充文本缺失的语境信息
• 领域适应性:在电商、社交媒体等特定领域表现优异
三、挑战与威胁
尽管 MNMT 取得了显著进展,但仍面临诸多挑战:
3.1 视觉不平衡问题
在许多数据集中,图像与文本的语义对齐程度不一,导致模型难以有效利用视觉信息。部分图像可能包含大量与文本无关的背景元素,成为噪声干扰。
3.2 跨场景语义漂移
同一词汇在不同场景下可能具有不同含义。例如,“mole” 在医学场景中指“痣”,在间谍语境中指"内鬼"。模型需要根据视觉和文本上下文动态调整语义理解。
3.3 计算成本与延迟
多模态模型通常需要处理高维视觉特征,导致计算开销大、推理延迟高,限制了其在实时翻译场景中的应用。
3.4 无监督多模态翻译
在低资源语言场景下,缺乏对齐的多模态数据,如何实现无监督或弱监督的 MNMT 是一个亟待解决的问题。
3.5 模型可解释性不足
现有 MNMT 模型多为黑盒系统,难以解释视觉信息在翻译过程中的具体作用,限制了模型的可信度和可调试性。
3.6 大模型适配挑战
如何将大型语言模型(LLM)和多模态大模型(MLLM)有效适配到 MNMT 任务,充分发挥其强大的语义理解和生成能力,是当前研究的前沿方向。
四、评测方法及不足
4.1 主流评测指标
MNMT 的评测通常采用以下指标:
• BLEU:衡量译文与参考译文的 n-gram 重叠度
• METEOR:考虑同义词和词干匹配的评测指标
• BLEURT:基于预训练模型的评测指标,与人工评估更为接近
• 人工评估:通过人工打分评估翻译质量
4.2 评测数据集
常用的 MNMT 数据集包括:
• Multi30K:包含英语、德语、法语等多语言图像描述
• CoMMuTE:涵盖更复杂的跨模态语义关系
• Flickr30K:大规模图像-文本对齐数据集
4.3 评测方法的不足
(1)数据集复杂度有限
现有数据集多聚焦于简单的图像描述任务,缺乏复杂句式和专业术语的覆盖。
(2)缺乏专业领域数据
医疗、法律等专业领域的多模态翻译数据稀缺,限制了模型在垂直领域的应用。
(3)忽视文化差异
数据集往往忽略语言中的隐喻和文化内涵,例如"时间就是金钱"等表达在不同文化中的理解差异。
(4)低资源语言覆盖不足
数据集主要集中在英语、中文、法语等主流语言,对孟加拉语、越南语等低资源语言支持不足。
(5)对抗样本缺失
数据集缺乏图文语义噪声场景的对抗样本,导致模型在噪声环境下鲁棒性不足。
(6)文本-视觉语义共现不足
图像中可能包含多个对象,但文本仅描述其中一部分,导致大量视觉信息成为噪声,模型难以捕捉深层语义关系。
五、代表方法速览
根据应用导向,MNMT 方法可分为五大类:
5.1 基于消歧的方法(Disambiguation-based Approaches)
核心思想:利用多模态信息消除歧义表达。
(1)跨模态门控机制(Cross-modal Gating)
• 代表模型:Soul-mix(Cheng et al., ACL 2024)
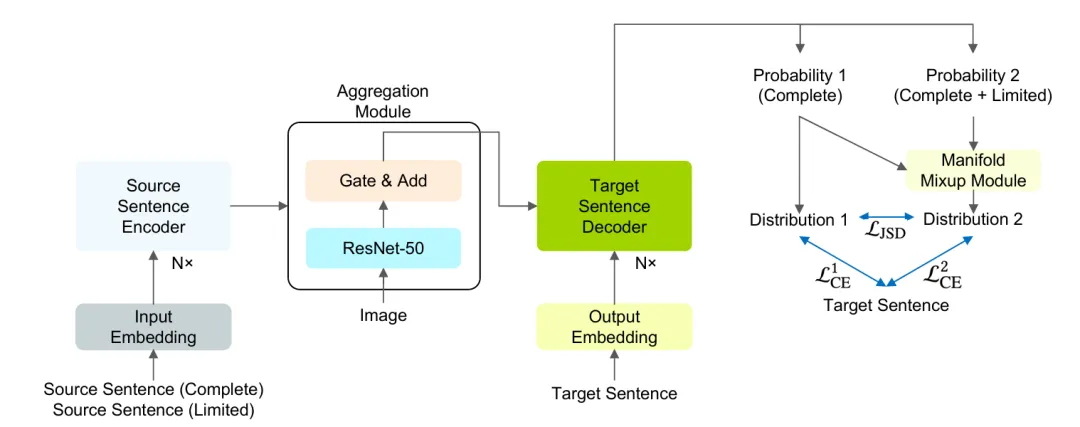
• 结构与作用:通过流形混合(Manifold Mixup)增强多模态表示,提升模型对歧义词的识别能力。
(2)跨模态注意力机制(Cross-modal Attention)
• 代表模型:Noise-robust Cross-modal Interactive Learning(Ye et al., COLING 2022)
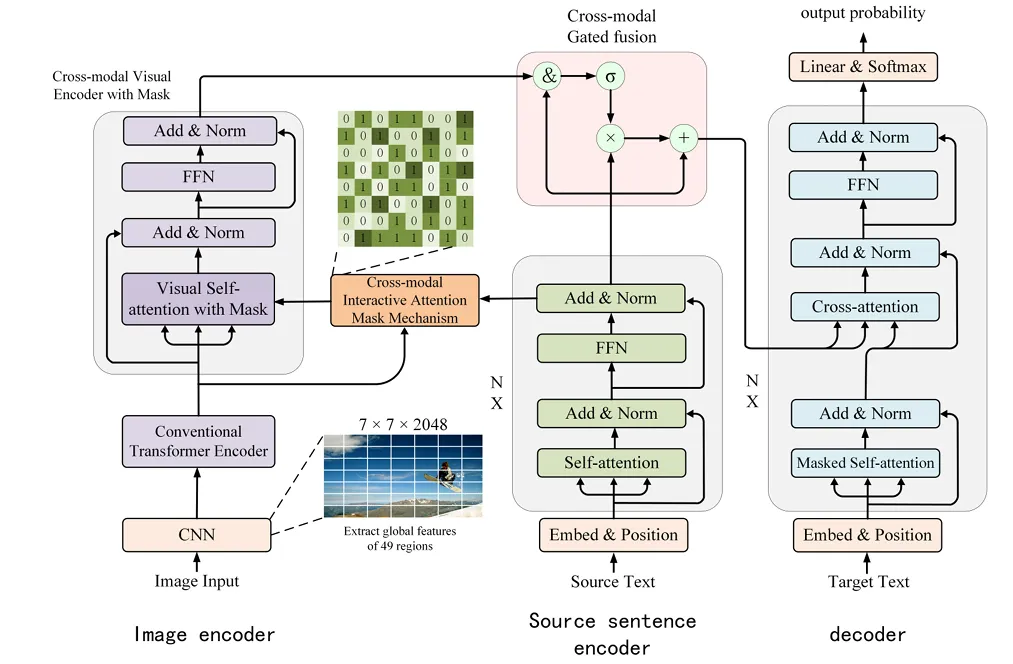
• 结构与作用:通过 Text2Image Mask 机制,主动建立视觉与文本特征之间的语义交互,增强模型对视觉噪声的鲁棒性。
• 代表模型:Encoder-Decoder Calibration(Tayir et al., IEEE TAI 2024)
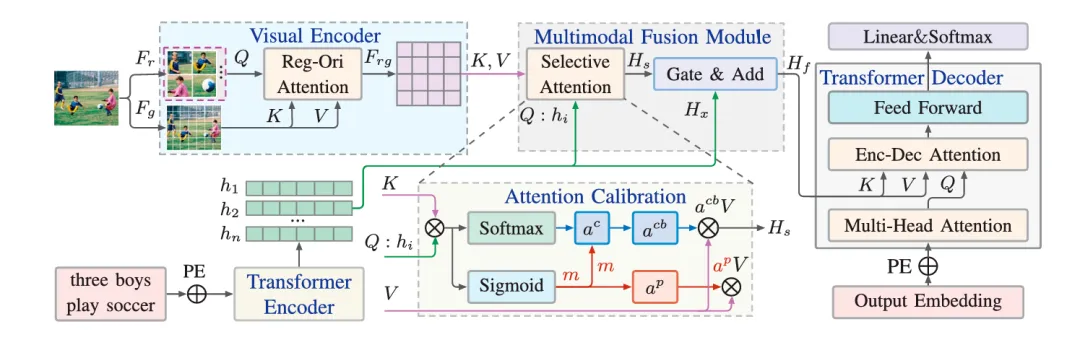
• 结构与作用:在编码器和解码器层面进行跨模态校准,确保视觉信息在翻译过程中的有效利用。
5.2 视觉平衡方法(Visual-Balance Approaches)
核心思想:解决视觉不平衡问题,确保模型在图文对齐和噪声场景下均表现稳定。
(1)单视图增强(Single View Enhancement)
• 代表模型:Valhalla(Li et al., CVPR 2022)
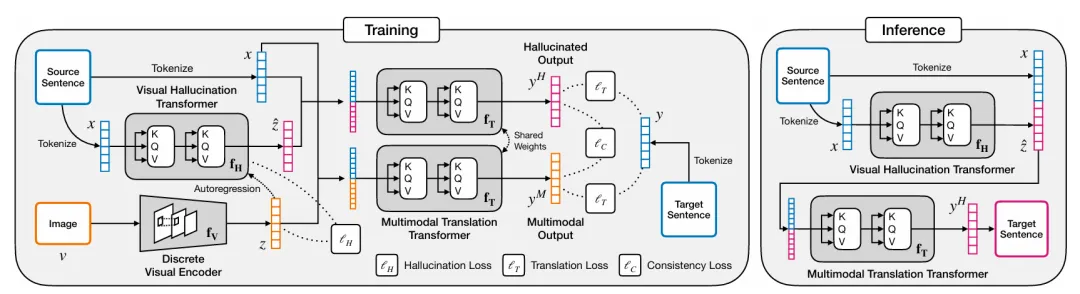
• 结构与作用:通过视觉幻觉(Visual Hallucination)技术,为缺失或噪声图像生成伪视觉特征,平衡视觉信息的贡献。
(2)文本引导生成(Text-guided Generation)
• 代表模型:Stable Diffusion-based Visual Imagination(Chen et al., ACL 2025)
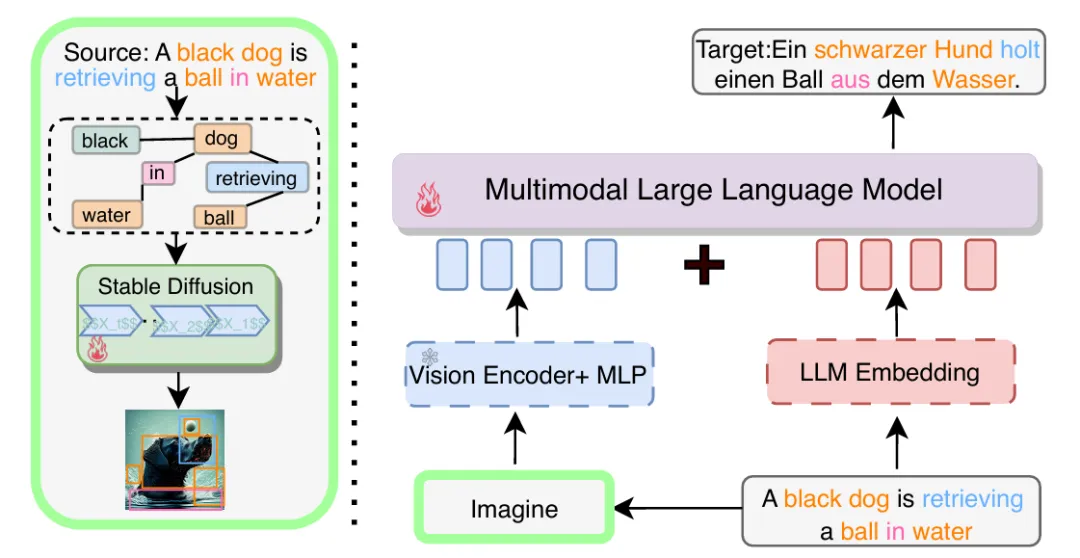
• 结构与作用:利用 Stable Diffusion 模型,根据源文本生成高质量的辅助图像,增强视觉信息的语义一致性。
5.3 视觉枢纽方法(Visual-Pivot Approaches)
核心思想:将视觉信息作为语言枢纽,连接源语言和目标语言。
(1)监督式 MNMT
• 代表模型:Multi-grained Visual Pivot(Guo et al., Neural Networks 2024)
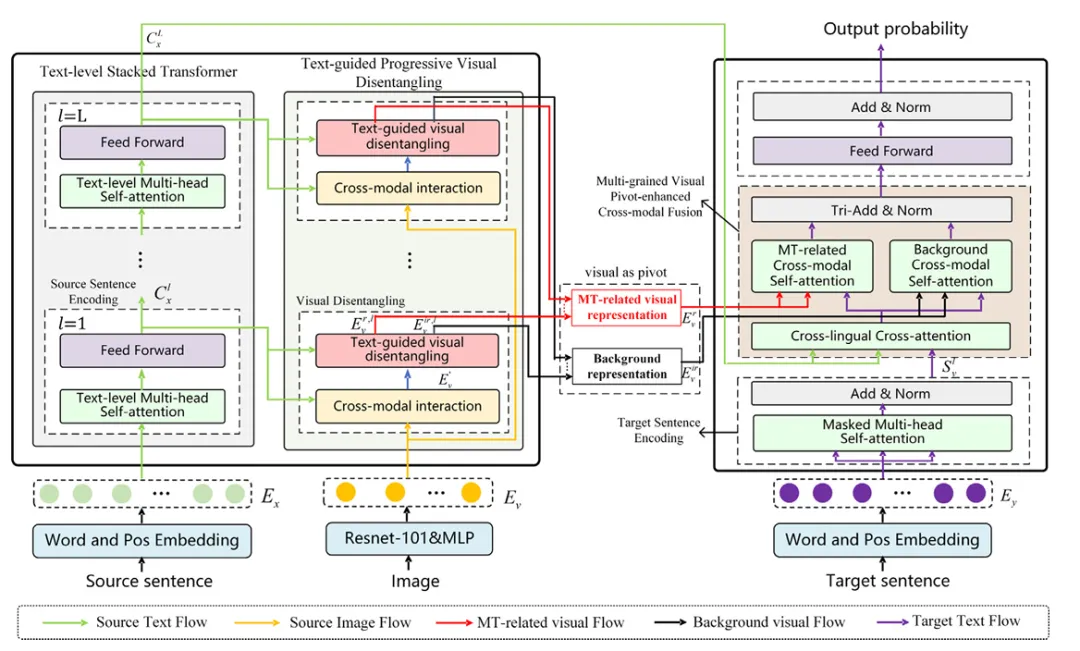
• 结构与作用:通过多粒度视觉枢纽和文本感知的跨模态对比解耦,增强视觉信息在翻译中的桥接作用。
(2)无监督式 MNMT
• 代表模型:Scene Graph as Pivoting(Fei et al., EMNLP 2023)
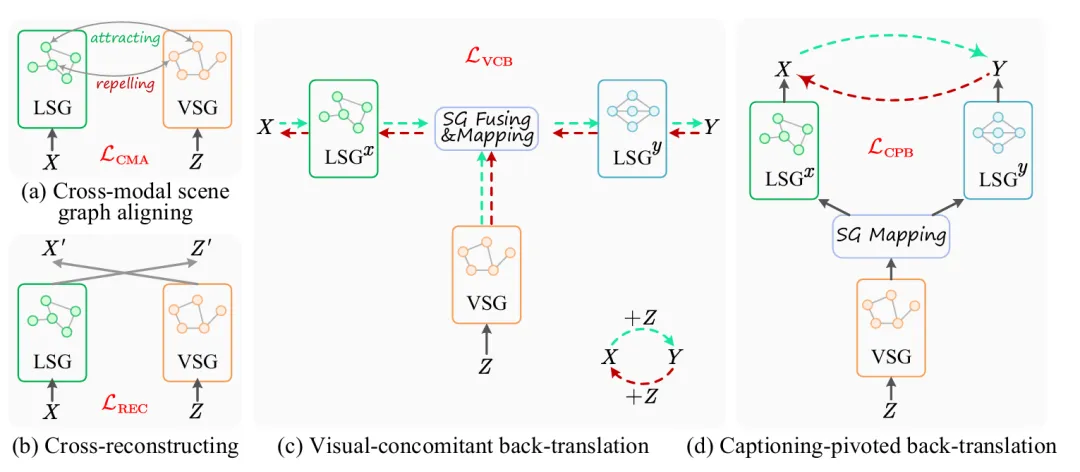
• 结构与作用:利用场景图生成技术,捕捉图像中的对象关系,作为无监督翻译的语义桥梁。
5.4 基于大模型的方法(LLM/MLLM-Based Approaches)
核心思想:利用预训练大模型的强大语义理解能力,提升 MNMT 性能。
• 代表模型:CLIPTrans(Gupta et al., ICCV 2023)
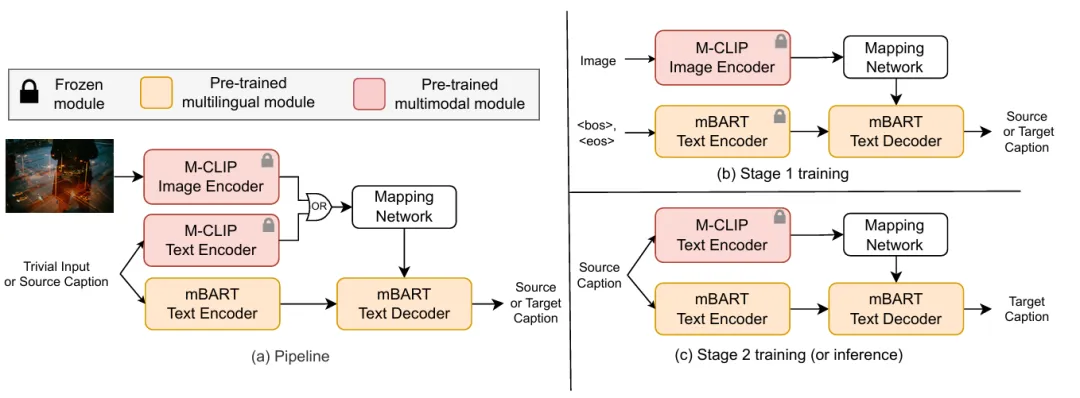
• 结构与作用:迁移 CLIP 预训练模型的视觉知识,通过对比学习增强多模态表示。
• 代表模型:Triplet-modality Group-guided Distillation(Guo et al., IPM 2025)
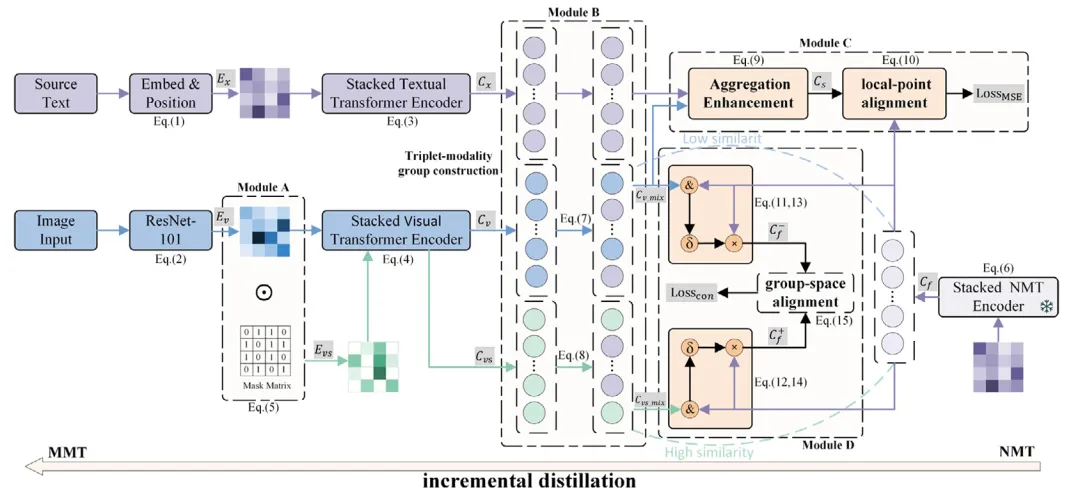
• 结构与作用:采用三元模态组引导的增量蒸馏,结合正则化组语义一致性,提升模型效率和性能。
• 代表模型:Zero-shot MNMT(Futeral et al., NAACL 2025)
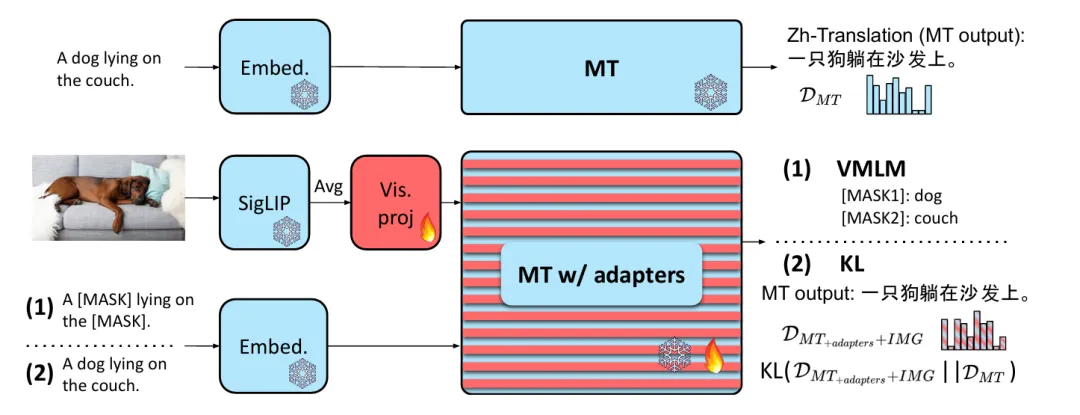
• 结构与作用:探索多模态大模型在零样本翻译场景下的潜力,无需额外训练即可完成翻译任务。
5.5 可解释性导向方法(Interpretability-Oriented Approaches)
核心思想:揭示视觉信息在翻译中的作用机制,提升模型透明度。
• 代表研究:Good for Misconceived Reasons(Wu et al., ACL 2021)
• 发现:在通用领域翻译任务中,视觉信息主要起正则化作用,而非直接提供语义线索。
六、总结与未来可值得研究的方向
6.1 总结
多模态神经机器翻译作为融合视觉与文本的前沿技术,在跨境电商、社交媒体、新闻报道等领域展现出巨大潜力。通过引入视觉信息,MNMT 能够有效消除歧义、增强上下文理解,显著提升翻译质量。当前研究已在消歧、视觉平衡、视觉枢纽、大模型适配和可解释性等方向取得重要进展,但仍面临视觉不平衡、计算成本高、低资源语言支持不足等挑战。
6.2 未来研究方向
(1)低资源语言的多模态翻译
扩展 MNMT 到孟加拉语、越南语等低资源语言,探索无监督或弱监督学习方法。
(2)专业领域的多模态翻译
构建医疗、法律、金融等垂直领域的多模态数据集,提升模型在专业场景下的表现。
(3)跨文化语义理解
研究如何让模型理解和翻译隐喻、成语等文化特定表达,增强跨文化交流能力。
(4)高效轻量化模型
开发计算高效的 MNMT 模型,降低推理延迟,支持实时翻译应用。
(5)对抗鲁棒性增强
构建包含图文语义噪声的对抗样本数据集,提升模型在噪声环境下的鲁棒性。
(6)多模态大模型的深度适配
探索如何将 GPT-4V、Gemini 等多模态大模型有效应用于 MNMT,充分发挥其零样本和少样本学习能力。
(7)可解释性与可信 AI
开发可解释的 MNMT 模型,揭示视觉信息在翻译决策中的具体作用,提升模型可信度。
(8)多模态知识图谱的构建与应用
构建大规模多模态知识图谱,为 MNMT 提供丰富的外部知识支持。
七、参考文献
[1] Specia, L., Frank, S., Sima'an, K., et al. (2016). A shared task on multimodal machine translation and crosslingual image description. Proceedings of the First Conference on Machine Translation: Volume 2, Shared Task Papers, 543-553.
[2] Yin, Y., Meng, F., Su, J., et al. (2020). A Novel Graph-based Multi-modal Fusion Encoder for Neural Machine Translation. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics, 3025-3035.
[3] Cheng, X., Yao, Z., Xin, Y., et al. (2024). Soul-mix: Enhancing multimodal machine translation with manifold mixup. Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 11283-11294.
[4] Ye, J., Guo, J., Xiang, Y., et al. (2022). Noise-robust cross-modal interactive learning with text2image mask for multi-modal neural machine translation. Proceedings of the 29th international conference on computational linguistics, 5098-5108.
[5] Tayir, T., Li, L., Li, B., et al. (2024). Encoder–Decoder Calibration for Multimodal Machine Translation. IEEE Transactions on Artificial Intelligence, 5(8), 3965-3973.
[6] Li, Y., Panda, R., Kim, Y., et al. (2022). Valhalla: Visual hallucination for machine translation. Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, 5216-5226.
[7] Chen, A., Song, Y., Chen, K., et al. (2025). Make imagination clearer! stable diffusion-based visual imagination for multimodal machine translation. Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 26567-26583.
[8] Wang, J., Yang, Z., Zong, L., et al. (2025). Dual-branch Prompting for Multimodal Machine Translation. arXiv preprint arXiv:2507.17588.
[9] Xu, T., Liu, X., Wong, D. F., et al. (2025). Exploiting Multimodal Knowledge Graph for Multimodal Machine Translation. IEEE Transactions on Multimedia.
[10] Guo, J., Su, R., Ye, J. (2024). Multi-grained visual pivot-guided multi-modal neural machine translation with text-aware cross-modal contrastive disentangling. Neural Networks, 178, 106403.
[11] Zhang, Z., Sun, S., Zhao, J., et al. (2025). VQA-Augmented Machine Translation with Cross-Modal Contrastive Learning. Findings of the Association for Computational Linguistics: EMNLP 2025, 10113-10124.
[12] Fei, H., Liu, Q., Zhang, M., et al. (2023). Scene Graph as Pivoting: Inference-time Image-free Unsupervised Multimodal Machine Translation with Visual Scene Hallucination. Findings of the Association for Computational Linguistics: EMNLP 2023, 15454-15471.
[13] Gupta, D., Kharbanda, S., Zhou, J., et al. (2023). CLIPTrans: transferring visual knowledge with pre-trained models for multimodal machine translation. Proceedings of the IEEE/CVF international conference on computer vision, 2875-2886.
[14] Guo, J., Li, Y., Tan, K. (2025). Triplet-modality group-guided incremental distillation with regularized group semantic consistency for multi-modal neural machine translation. Information Processing & Management, 62(5), 104149.
[15] Futeral, M., Schmid, C., Sagot, B., et al. (2025). Towards zero-shot multimodal machine translation. Findings of the Association for Computational Linguistics: NAACL 2025, 761-778.
[16] Wu, Z., Kong, L., Bi, W., et al. (2021). Good for Misconceived Reasons: An Empirical Revisiting on the Need for Visual Context in Multimodal Machine Translation. Proceedings of the 59th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers).
[17] Feng, Y., Li, C., He, J., Hou, Z., Ng, V. (2025). Multimodal Neural Machine Translation: A Survey of the State of the Art. Proceedings of the 2025 Conference on Empirical Methods in Natural Language Processing, 22130-22147.
