
 语音小管家
AudioCC交我学
作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。我们将用通俗易懂的语言拆解复杂理论,用数据与实验结果验证技术价值,带你快速了解最新、最有趣的学术论文,打破学术与大众之间的壁垒,让你在碎片化的时间里也能 get 到前沿知识!
一、引言:声音不只有"内容",还有"位置"
当我们闭上眼睛聆听周围的世界,大脑不仅能识别出声音是"什么"(一辆汽车、一个人说话),还能判断出声音从"哪里"来——是左边还是右边,是近处还是远处,甚至能感受到声音所处空间的大小与回响。这种能力,依赖于人耳对声音相位差(IPD)、响度差(ILD)以及声波经由人头、耳廓反射和衍射所形成的细微线索的综合处理。
然而,对机器来说,理解声音的空间信息远比识别其语义内容困难得多。随着大语言模型(LLM)在语音、图像等模态上取得突破,一个自然的问题浮现出来:能否让大模型真正"听懂"声音的空间信息?
本文将介绍近期空间音频理解领域的四项代表性工作——BAT[1]、OWL[2]、Sci-Phi[3] 和 SING[4],梳理这一方向的技术脉络与最新进展。
二、背景:什么是空间音频理解?
空间音频包含哪些信息?
一段音频信号中,除了语义信息(说了什么、是什么声音),还蕴含着丰富的空间信息:
声源位置与运动状态:声源在三维空间中的方向与距离;
空间环境特征:房间的大小、几何形状、混响时间;
传播路径信息:声波经过障碍物的阻挡、介质的衰减等。
主要任务类型
空间音频理解的任务体系可以分为三个层级,呈现出从"感知"到"推理"的递进关系:
L1 分立识别:声音事件检测(SED)、声源定位(SSL)——各自独立地完成分类和定位;
L2 关系整合:声音事件定位与检测(SELD)——将声音类别与空间位置结合起来联合建模;
L3 认知推理:在理解空间位置关系的基础上进行逻辑判断,例如"哪个声源更近?"、"声音是在靠近还是远离?"
常用输入特征
目前主流方法主要使用两类输入:
绝对特征:Mel 谱、STFT 幅度谱,描述声音本身的内容信息;
相对特征:通道间相位差(IPD)、通道间强度差(ILD)、强度向量(Intensity Vectors, IVs)——描述多通道之间的空间关系,类似于人耳感知空间方向的生理机制。
多通道音频格式上,FOA(First-Order Ambisonics) 是最常用的格式,包含 W(全向声压)、X、Y、Z 四个通道,能够完整描述声场的一阶球谐分量。
三、四项代表性工作详解
1. BAT:空间音频问答的首个大模型框架
BAT(Binaural Audio Transformer)的核心贡献在于,将空间音频理解构建为一个问答(QA)任务,首次系统性地将 LLM 引入空间音频推理。
数据集:SpatialSoundQA
BAT 构建了 SpatialSoundQA 数据集,利用 SoundSpaces 2.0 平台进行房间混响仿真,并以 Matterport3D 作为环境网格来源,生成了超过 21,000 条混响样本(平均每房间约 9.58 条)。声源素材来自 AudioSet,并对需要视觉辅助的标签和低质量标签进行了过滤。
QA 问题按照难度分为五种类型,从单声源检测(A、B 类)到多声源耦合识别(C、D 类),再到需要跨声源关系判断的复杂推理(E 类)。
模型架构:Spatial-AST + LLaMA-2
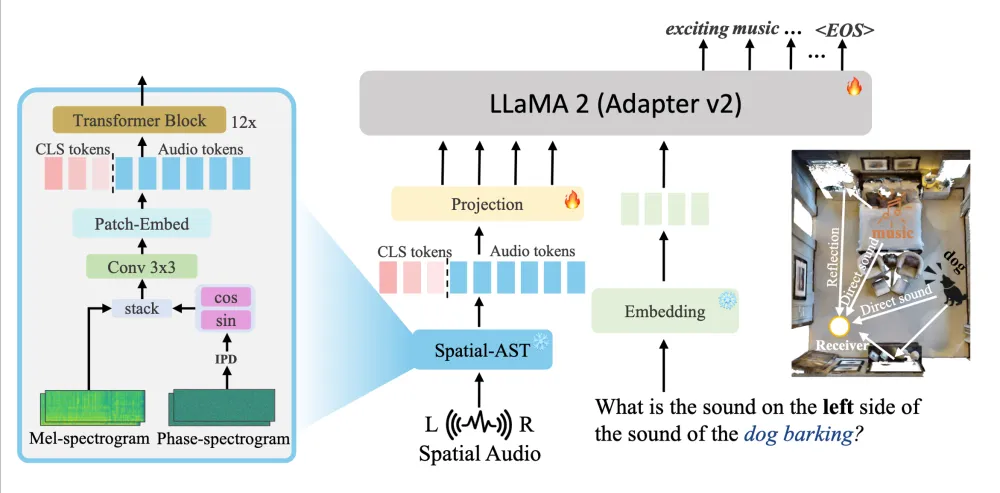
图1 BAT模型结构图
BAT 在架构上由两部分组成:
Spatial-AST Encoder:专门设计的空间音频编码器,使用双通道信号,以梅尔谱与 IPD 作为输入,并通过 3 个 [CLS] token 分别用于声音分类、距离估计和角度估计;
LLaMA-2 Decoder:将编码器输出映射为自然语言回答。
Spatial-AST 的训练目标将距离和角度均定义为分类任务(距离以 0.5m 为间隔,角度以 1° 为间隔),使用交叉熵损失监督。
训练策略:课程式学习
BAT 设计了一种"从感知到推理"的三阶段课程式训练策略:
1.热身阶段:单声源感知任务(A、B 类),让模型适应音频模态;
2.多声源阶段:引入 C、D 类问题,使模型隐式学习声源分离能力;
3.推理阶段:解锁 E 类复杂推理任务,要求模型理解多声源间的空间关系。
消融实验表明,去掉 C、D 类训练后,模型的空间推理能力明显下降——声源分离相关任务在训练中起到了关键的"桥梁"作用。
2. OWL:用视觉几何感知辅助空间音频推理
OWL(Open-World Listening)的出发点是:空间音频中蕴含的几何信息,仅凭音频信号本身难以充分提取,而深度图像天然包含了房间几何的精确描述。OWL 的核心思路是在训练时借助视觉模态"教会"音频编码器感知空间几何,在推理时仅依赖音频。
数据集:BiDepth
OWL 构建了 BiDepth 数据集,包含 28,000 对 RIR(房间冲激响应)与全景深度图的配对数据,来源于 SoundSpaces 2.0 与 Matterport3D 环境。
QA 问题同样分为四类:事件检测(Type I)、方向估计(Type II)、空间推理(Type III),以及带有思维链(Chain-of-Thought) 标注的空间推理(Type IV)——这是 OWL 与 BAT 的重要区别之一。
模型架构:双编码器 + 几何感知预训练
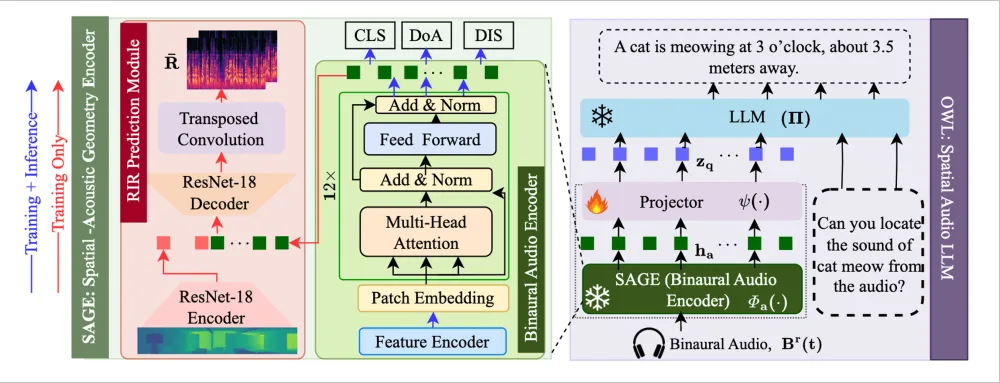
图2 OWL模型结构图
OWL 的编码器由两部分构成:
Binaural Audio Encoder(SAGE):负责提取空间音频特征;
RIR Prediction Module:在训练时,要求音频编码器的输出能够预测 RIR,从而将编码器的表征与视觉深度图所隐含的空间几何信息对齐。
在推理阶段,深度图编码器被移除,仅使用音频编码器,实现了"训练时有视觉辅助、推理时纯音频"的轻量化部署。Decoder 采用 LLaMA-2-7B。
实验结果
OWL 在 BiDepth 数据集上取得了最优性能,并在 SpatialSoundQA 数据集上的零样本测试中同样表现最佳,验证了几何感知预训练的跨数据集泛化能力。
3. Sci-Phi:用 FOA 和大模型进行全场景空间描述
如果说 BAT 和 OWL 聚焦于声源的定位与推理,Sci-Phi 则更进一步,目标是对声学场景进行全面的自然语言描述,包括:
房间大小与几何
混响时间(T60)
噪声水平
清晰度指数(C50,有用混响与干扰混响的比例)
多声源的位置与类别
数据与输入特征
Sci-Phi 使用 FOA 四通道信号作为输入,提取 Mel 谱与 Intensity Vectors(IVs),并基于 IMAGE 方法合成了约 4000 小时的训练数据,是目前该方向规模最大的合成数据集之一。
模型架构:双编码器设计
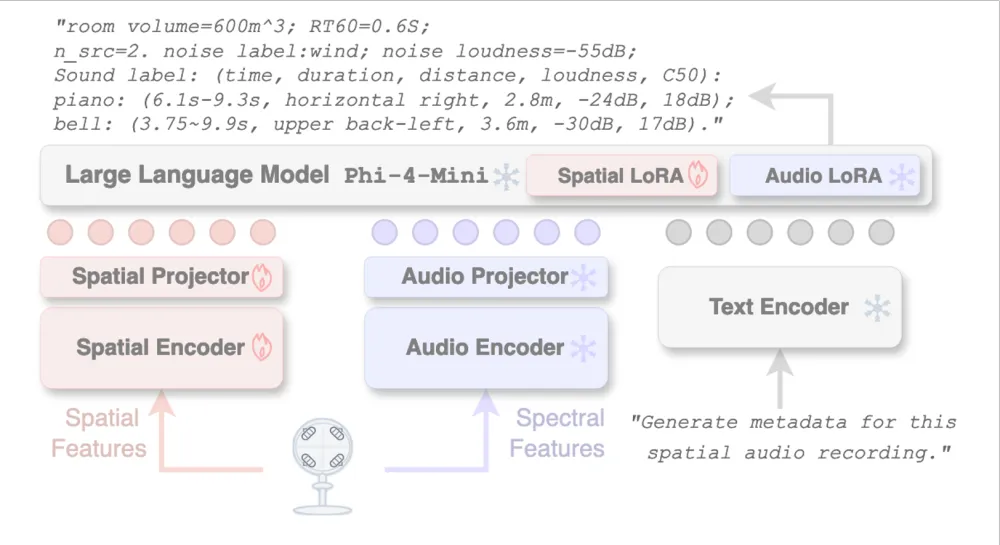
图3 Sci-Pho模型结构图
与 BAT/OWL 不同,Sci-Phi 采用了分立的双编码器架构:
Audio Encoder:仅使用 FOA 的 W(0 阶全向)通道,基于预训练的 Phi-4 Multimodal 模型,提取声音内容信息;
Spatial Encoder:使用所有 4 通道,基于 SELDNet 提取空间特征。
两路编码器的特征被融合后输入语言模型,实现全场景的空间描述。这种设计的优势在于,让专用的空间编码器承担几何感知任务,避免通用多模态模型处理空间特征时的信息损失。
4. SING:可穿戴单麦克风的空间音频推理
前三项工作均依赖双耳音频或多通道 FOA 信号,SING 则面向更贴近现实的应用场景——单麦克风。
核心创新:微结构传感器设计
SING 设计了一种便携可穿戴的接收腔体结构,使得来自不同到达方向(DoA)的声音经过腔体时产生不同的传递路径,从而让单通道信号中也隐含了方向信息。这一物理设计思路与人耳耳廓对声音进行方向编码的机制异曲同工。
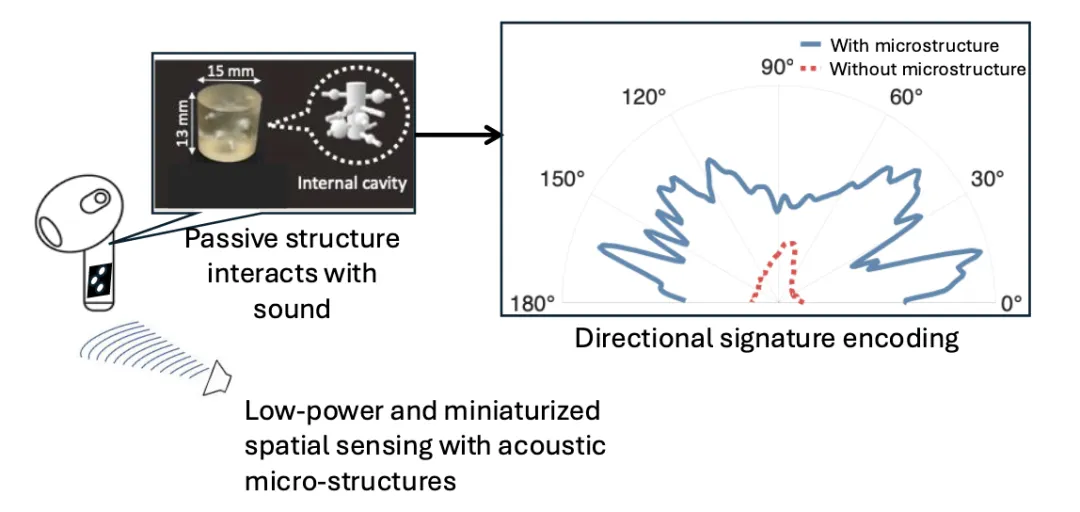
图4 单通道麦克风腔体对于不同方向声音接收特性示意图
模型架构
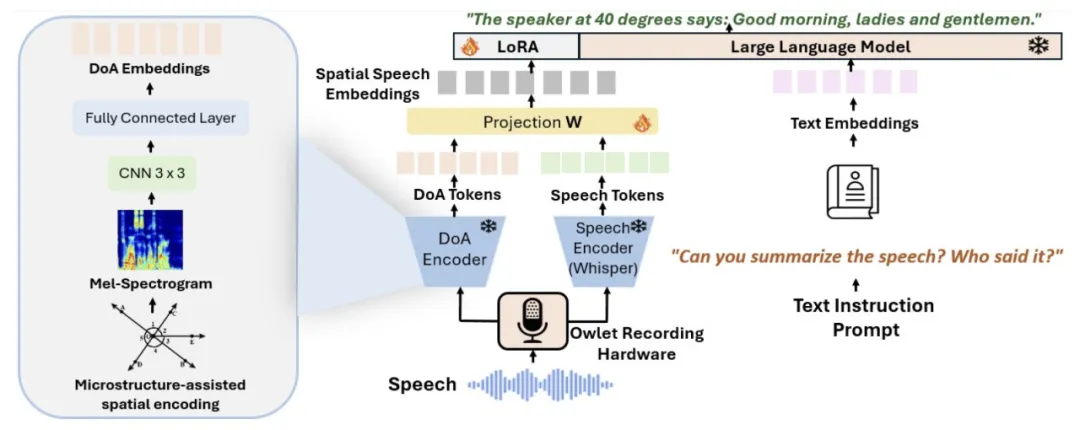
图5 SING模型结构图
SING 基于Whisper(语音识别预训练模型)作为 Audio Encoder,结合 DoA 估计模块,并使用LLaMA 3.2 3B作为语言模型 Decoder,实现了在低资源设备上的空间音频推理。
实验结果表明,SING 的 DoA 估计与空间推理性能优于现有基线方法,展现了小模型在可穿戴场景下的实用潜力。
四、横向对比
模型 | 核心编码器 | 音频格式 | 推理能力 | 主要贡献 |
BAT | Spatial-AST | 双耳音频 | 基础空间逻辑 | SpatialSoundQA 数据集;课程式训练策略 |
OWL | SAGE | 双耳音频 | CoT 空间推理 | 视觉几何感知预训练;BiDepth 数据集 |
Sci-Phi | Dual Enc.(Phi-4 + SELDNet) | FOA 四通道 | 全场景描述 | 多声源并行参数估计;4000h 合成数据 |
SING | Whisper + DoA | 单声道 | 语音位置感知 | 微结构传感器设计;可穿戴设备适配 |
五、现存问题与挑战
尽管上述工作展示了空间音频理解的广阔前景,目前该领域仍面临以下主要挑战:
1.输入格式不统一:双耳音频、FOA、单声道等格式并存,限制了模型的通用性,也难以进行统一的 Scale-up;
2.仿真数据与真实场景的 Gap:现有数据集几乎全部基于仿真,与真实复杂声学场景(街道、户外等)存在显著差异;
3.场景复杂度不足:当前工作主要聚焦于室内封闭声学场景,对开放环境、动态场景的建模能力有限;
4.定位精度仍有提升空间:尤其在距离估计和精细方向估计上,与人耳能力相比仍有较大差距。
六、总结
从 BAT 的问答式空间推理,到 OWL 的几何感知预训练,再到 Sci-Phi 的全场景描述,以及 SING 对可穿戴场景的探索,空间音频理解正在从"分立感知"走向"语义推理",从"受控实验室环境"走向"真实可部署系统"。
如何弥合仿真与真实场景的差异、统一多格式输入、提升推理精度与泛化能力,将是这一方向未来持续突破的核心课题。我们期待看到更多将大模型的推理能力与空间声学的物理机制深度融合的工作。
七、参考文献
[1]ZHENG Z, PENG P, MA Z, et al. BAT: Learning to Reason about Spatial Sounds with Large Language Models[C]//ICML 2024. http://arxiv.org/abs/2402.01591.
[2]BISWAS S, KHAN M N H, ISLAM B. OWL: Geometry-Aware Spatial Reasoning for Audio Large Language Models[A].arXiv,2025. http://arxiv.org/abs/2509.26140
[3]JIANG X, GAMPER H, BRAUN S. Sci-Phi: A Large Language Model Spatial Audio Descriptor[A]. arXiv,2025. http://arxiv.org/abs/2510.05542.
[4]MISHRA A, BAI Y, NARAYANASAMY P, et al. Spatial Audio Processing with Large Language Model on Wearable Devices[A].arXiv,2025. http://arxiv.org/abs/2504.08907.
供稿:刘正龙,编辑:方楠,审核:韩冰
