FFmpeg之父新作——音频压缩工具 TSAC
前两天FFmpeg作者Fabrice Bellard在个人主页发布了一款音频压缩工具TSAC。根据官网介绍,TSAC可达到非常低的比特率,例如44.1 kHz采样率下的码率可以达到单声道 5.5 kb/s 或立体声 7.5 kb/s,具有良…
70 0 0
前两天FFmpeg作者Fabrice Bellard在个人主页发布了一款音频压缩工具TSAC。根据官网介绍,TSAC可达到非常低的比特率,例如44.1 kHz采样率下的码率可以达到单声道 5.5 kb/s 或立体声 7.5 kb/s,具有良…
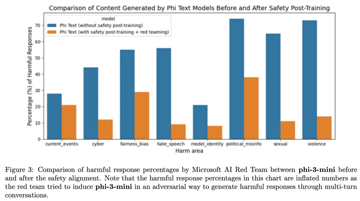
Llama-3 刚发布没多久,竞争对手就来了,而且是可以在手机上运行的小体量模型。 本周二,微软发布了自研小尺寸模型 Phi-3。 新模型有三个版本,其中 Phi-3 mini 是一个拥有 38 亿参数的语言模型,经过 3.3 万亿 tok…

声学室模拟允许在AR眼镜上以最少的真实数据进行训练,用于开发鲁棒的语音识别声音分离模型。 随着增强现实(AR)技术的强大和广泛应用,它能应用到各种日常情境中。我们对AR技术的潜能感到兴奋,并持续不断地开发和测试新技术与体验。其中一个研究方向…

该篇论文提出了一种基于大规模预训练模型的鲁棒机器异常声音检测方法,旨在解决由于数据收集困难和复杂声学环境导致的异常声音检测任务泛化性能不佳的问题。研究团队采用wav2vec 2.0、HuBERT、UniSpeech和WavLM等大规模预训练…


本项目希望通过开源社区的力量复现Sora,由北大-兔展AIGC联合实验室共同发起,当前资源有限仅搭建了基础架构,无法进行完整训练,希望通过开源社区逐步增加模块并筹集资源进行训练,当前版本离目标差距巨大,仍需持续完善和快速迭代,欢迎Pull…


论文题目:Speaker Recognition Based on Pre-Trained Model and Deep Clustering 作者列表:何亮,宋志达,刘双红,牛孟其,胡英,黄浩 单位:新疆大学计算机科学与技术学院、清华大学…