Seed 全双工语音大模型发布:懂倾听、抗干扰,走向更自然的交互

今天,字节正式推出原生全双工语音大模型 Seeduplex。相比于上一代半双工豆包端到端语音模型,Seeduplex 基于“边听边说”的全新框架设计,交互体验的自然感、顺畅度大幅提升。 如果说端到端架构通过统一“听”“说”模块,让 AI 拥…
81 0 0

今天,字节正式推出原生全双工语音大模型 Seeduplex。相比于上一代半双工豆包端到端语音模型,Seeduplex 基于“边听边说”的全新框架设计,交互体验的自然感、顺畅度大幅提升。 如果说端到端架构通过统一“听”“说”模块,让 AI 拥…

歌曲结构标注(MSA)是一种能够识别歌曲中具有功能意义的段落(如前奏、主歌、副歌)并精准检测其边界的技术,正日益成为音乐理解和可控音乐生成的重要支撑技术。然而,现有的 MSA 方法通常由于训练数据规模有限、标注不一致、依赖复杂预处理流程等原…
生成式通用语音增强(Universal Speech Enhancement, USE)旨在利用生成式模型改善各类失真条件下的语音质量。当前主流方法虽能有效提升感知质量,但在语义一致性方面仍面临挑战——生成语音常出现语义偏差、词汇误换或上下…
来源丨新智元、AI小展厅 面壁智能2B小模型VoxCPM 2惊艳开源,一众外国网友疯狂了!30种语言与9大方言它是信手拈来,复刻的贺炜激昂解说与徐志胜脱口秀,相似度简直直击灵魂。这哪是工具,分明是降维打击的生产力核武器! VoxCPM 2,…
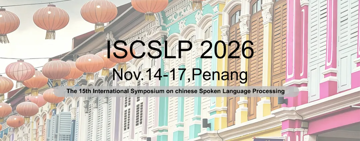
🎯中文口语语言处理国际会议 International Symposium on Chinese Spoken Langauge Processing (ISCSLP) 会议时间:2026年11月14-17日 会议地点:马来西亚·槟城 往…

多模态情感分析正经历从静态分类向生成式推理(Generative Reasoning)的深刻范式转变。为了理解复杂的社交互动,系统必须能够综合诸如面部微表情和语音韵律等细粒度信号,以解码潜在的因果逻辑。 近年来,虽然通用多模态大语言模型(如…

来源丨paperWeekly 近日,南京大学与腾讯音乐发布开源语音大模型 VITA-Qinyu ,这是业内首款兼具自然对话、高表现力角色扮演与歌唱能力的 开源端到端语音语言模型 (SLM)。目前 VITA-QinYu 的训练代码与模型权重全…