
阶跃 StepAudio 2.5 ASR 上线!500TPS 极速推理,30分钟语音“秒级转写”

今天,阶跃正式发布新一代自动语音识别模型StepAudio 2.5 ASR! 这款模型的核心突破在于速度与精度的兼得。我们率先将大语言模型(LLM)的推理加速技术引入语音识别领域,基于 ASR+MTP-5 深度融合架构,实测推理速度提升40…
60 0 0

今天,阶跃正式发布新一代自动语音识别模型StepAudio 2.5 ASR! 这款模型的核心突破在于速度与精度的兼得。我们率先将大语言模型(LLM)的推理加速技术引入语音识别领域,基于 ASR+MTP-5 深度融合架构,实测推理速度提升40…

在今天的语音合成系统里,听起来自然已经不再稀缺,但哪里该慢一点、哪个字该拉长、哪个位置该停顿、停多久,依然很难真正交给用户来控制。 但这恰恰是很多真实应用场景在意的问题。 比如导航播报里,“前方路口左转”中的“左转”往往需要更清楚、更突出;…


今天,小米发布MiMo-V2.5-TTS Series与MiMo-V2.5-ASR—— 一套面向 Agent 时代的全链路语音模型系列,覆盖识别与合成两大核心能力,让语音的输入与输出都可以被语言自由调度。 MiMo-V2.5-TTS Ser…

近期,浙江大学研究者提出了WavAlign: Enhancing Intelligence and Expressiveness in Spoken Dialogue Models via Adaptive Hybrid Post-Trai…

Annual Meeting of the Association for Computational Linguistics(简称 ACL)年会是计算语言学和自然语言处理领域国际排名第一的顶级学术会议,由国际计算语言学协会组织,每年召开一…

以下文章来源于Xiaomi MiMo 今天凌晨,Xiaomi MiMo-V2.5 系列模型正式开启公测。 Xiaomi MiMo-V2.5 系列包含 MiMo-V2.5、V2.5-Pro 、V2.5-TTS Series 、V2.5-ASR…


昨晚,千问3.6系列最新模型Qwen3.6-27B正式开源! 该模型在核心编程能力评测中,以270亿的总参数量,性能媲美千亿参数级别模型。在SWE-bench、Terminal-Bench 2.0、SkillsBench、QwenWebBe…
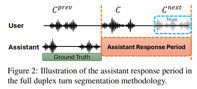
文章链接:https://arxiv.org/pdf/2511.10262 仓库链接:https://github.com/ZhangHe0918/MTR-DuplexBench 数据集链接:https://huggingface.co/d…
