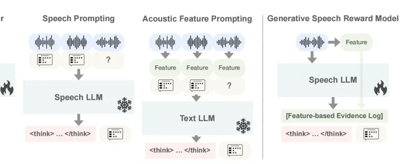
从 “能说话” 到 “会说话”:Meta+MIT 联手打出 GSRM “声学 + 推理” 组合拳,合成语音自然度赢率飙升 82%

以下文章来源于AI随想录,作者William 论文标题: GSRM: Generative Speech Reward Model for Speech RLHF 论文链接: https://arxiv.org/pdf/2602.13891…
24 0 0

以下文章来源于AI随想录,作者William 论文标题: GSRM: Generative Speech Reward Model for Speech RLHF 论文链接: https://arxiv.org/pdf/2602.13891…
来源丨新智元、AI音频时代 谷歌在 7.5 亿月活的 Gemini 中上线了 AI 音乐生成功能,输入一句话或一张照片,几秒就能得到一首带人声和歌词的完整歌曲。背后是 DeepMind 最新的 Lyria 3 模型,训练数据超 200 万首…
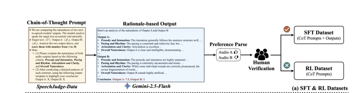
语音合成(TTS)领域长期存在一个矛盾:机器判断的“自然”与人类主观感受脱节。 这样的场景常常出现:你让AI生成一段语音,客观指标显示“完美”(如WER=0、FAD极低),但听起来却像机器人在背书。 如何让机器get到人类觉得“自然”的点?…
百灵多模态团队节前前发布了 Ming-flash-omni-2.0,基于其语音模块,我们新发布了 Ming-omni-tts,通过模型 scale up 实现了更强的效果。 不管你是短视频博主配旁白,独立播客创作者想把单人对话变成双人播客,…
从多人对话中的语调起伏与逻辑重心,到环境音背后隐藏的空间几何与物体运动轨迹,再到复杂音乐中演奏技法与艺术情感的深层关联,音频理解不应止于结果的预测。为了透明评估音频模型的推理过程质量,避免通过语言偏见、训练数据偏见或错误的方法“猜中”答案,…