
声浪

IEEE TASLP | JSA-SPG:一种免发音词典的训练方法,推进基于音素的跨语言语音识别

论文题目:Pronunciation-Lexicon Free Training for Phoneme-based Crosslingual ASR via Joint Stochastic Approximation 作者:赛尔达尔·玉…
26 0 0
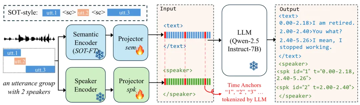
TagSpeech:端到端搞定多说话人ASR与分离,还能精准定位时间
标题:TagSpeech: End-to-End Multi-Speaker ASR and Diarization with Fine-Grained Temporal Grounding 链接:https://arxiv.org/pdf…
27 0 0
OpenAI的首款硬件:是AI耳机,今年销量要冲5000万
来源丨机器之心 以人工智能技术闻名的 OpenAI,终于也要搞硬件了,而且一上来就是和苹果正面对标。 最近,有关 OpenAI 硬件的消息越来越多。 今天一早,数码博主 @智慧皮卡丘透露了关于 OpenAI「To-go」硬件项目的最新细节。…
28 0 0
5.6K Star!原本付费现在开源!本地版“ElevenLabs”,视频翻译+声音克隆全免费!
今天要分享的项目绝对是视频创作者和出海玩家的“年度福音”! 如果你做过视频本地化,你一定知道这个流程有多痛苦: 你要先分离音轨,再用 ASR 识别字幕,然后翻译,最后用 TTS 配音。 中间还会用到一些 API 高质量的服务,结果下来是不仅…
19 0 0
语音识别中热词增强的N种方法,不训练模型也能做
无论是语音产品的用户,比如经常使用语音输入法、语音转文字或语音聊天功能,还是开发者,都会面临一个问题:各家语音识别 API 都声称自己的识别准确率达到了 98% 以上,可为什么实际用起来感觉识别错误还是很多?“做了这么久,老板的名字都识别不…
31 0 0
AI 语音交互:巨头和创业公司们都在做什么
前几天写了一篇关于语音交互的文章(交互革命:AI 硬件别再死磕“语音”了),大家有不少讨论,于是我特意找了一些聚焦语音交互的 AI 公司和产品,想和大家一起看看,现在做语音交互的公司们都在做什么。 大厂:卷场景,争入口 1. OpenAI:…
32 0 0
空间听觉革命:边缘AI与语音架构的未来
来源丨SmellLikeAISpirit 人机交互(HMI)正在经历一场根本性的架构变革,从依赖云端的僵化命令结构,转向流暢、具备情境感知和空间智能的对话模式。 音频前端(AFE)技术,特别是从传统以硬件为中心的波束成形向软件定义的空间听觉…
28 0 0