语音/音频处理学术速递[12.8]

今日论文合集:cs.SD语音13篇,eess.AS音频处理14篇。 cs.SD语音 【1】 iQuery: Instruments as Queries for Audio-Visual Sound Separation 标题:IQuery…
233 0 0

今日论文合集:cs.SD语音13篇,eess.AS音频处理14篇。 cs.SD语音 【1】 iQuery: Instruments as Queries for Audio-Visual Sound Separation 标题:IQuery…
今日论文合集:cs.SD语音5篇,eess.AS音频处理6篇。 cs.SD语音 【1】 Talking Head Generation with Probabilistic Audio-to-Visual Diffusion Priors…
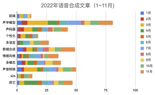
论文统计每月更新一次,主要跟踪语音合成和语音识别的发展状况。很多文章都是在会议后才发出,但不影响统计。统计过程难免存在疏漏,因此统计结果仅供参考。 所有文章语音合成领域统计列表请访问: http://yqli.tech/page/tts_p…
文章来源于THUHCSI人机语音交互实验室,作者HCSIers 本文由清华大学与虎牙信息科技有限公司、元象唯思控股(深圳)有限公司和香港中文大学合作。人们在演唱时会根据歌词语义进行演绎以提高歌声表现力。现有歌声合成工作通常仅考虑基本乐谱内容…
文章来源于THUHCSI人机语音交互实验室,作者HCSIers 本文由清华大学与腾讯 AI Lab、香港中文大学合作。人类语音中丰富多样的表现变化常常来源于所表达内容中蕴含的信息与意图,因此从文本中挖掘尽可能丰富的语义知识并输入给声学模型,…
今日论文合集:cs.SD语音9篇,eess.AS音频处理9篇。 cs.SD语音 【1】 Label-free Knowledge Distillation with Contrastive Loss for Light-weight Spe…
文章来源于智能语音新青年,作者ttslr 本次分享国立台湾大学李宏毅教授团队与JHU、CMU、MIT、Meta等机构联合发表于ACL2022会议的论文《SUPERB-SG: Enhanced Speech processing Univer…
今日论文合集:cs.SD语音21篇,eess.AS音频处理21篇。 cs.SD语音 【1】 DeAR: A Deep-learning-based Audio Re-recording Resilient Watermarking 标题:亲…
摘要:2019年底,清华大学语音处理与机器智能实验室(THU-SPMI)推出了基于CRF的语音识别工具包CAT,在多个基准数据集上取得了前沿性能(State-Of-The-Art,SOTA);2021年10月更新到了v2版。近期CAT工具包…