INTERSPEECH 2022|CALM: 基于对比学习的表现力语音合成跨模态说话风格建模
文章来源于THUHCSI人机语音交互实验室,作者HCSIers CALM: 基于对比学习的表现力语音合成跨模态说话风格建模 本文由清华大学与腾讯科技有限公司和香港中文大学合作,并在腾讯公司落地应用。 说话风格建模对于表现力语音合成具有重要作…
179 0 0

文章来源于THUHCSI人机语音交互实验室,作者HCSIers CALM: 基于对比学习的表现力语音合成跨模态说话风格建模 本文由清华大学与腾讯科技有限公司和香港中文大学合作,并在腾讯公司落地应用。 说话风格建模对于表现力语音合成具有重要作…
今日论文合集:cs.SD语音13篇,eess.AS音频处理11篇。 cs.SD语音 【1】 Puffin: pitch-synchronous neural waveform generation for fullband speech o…
文章来源于音频语音与语言处理研究组,作者张雍茂 构建带口音的语音合成系统可以增加语音合成的多样性和趣味性。然而不是每个人都能说多种口音。为了实现口音与说话人音色的自由组合,借助迁移学习技术,为没有口音数据的说话人构建口音合成系统,是实现“口…
ASV-Subtools更新 -runtime模块重磅发布- ASV-Subtools是厦门大学智能语音实验室(XMUSPEECH)于2020年6月推出的一套高效、易于扩展的声纹识别开源工具,该工具是基于Kaldi与Pytorch开发的,充…
INTERSPEECH 2022 基于多层级上下文信息的中文韵律结构预测 文由清华大学与虎牙信息科技有限公司、元象唯思控股(深圳)有限公司和香港中文大学合作。韵律结构预测对语音合成的自然度和可懂度有重要作用,现有工作主要使用当前语句的文本信…
今日论文合集:cs.SD语音8篇,eess.AS音频处理7篇。 cs.SD语音 【1】 ASiT: Audio Spectrogram vIsion Transformer for General Audio Representation…
文章来源于阿里语音AI,作者达摩院语音实验室 ▏什么是语音降噪模型? 我们日常可能会碰到一些录音质量不佳的场景。比如,想录制一段干净的语音却发现周围都很吵,录制的语音里往往混杂着噪声。当我们在噪杂的地铁或者巴士上通电话,为了让对方听清楚,不…
今日论文合集:cs.SD语音11篇,eess.AS音频处理12篇。 cs.SD语音 【1】 TF-GridNet: Integrating Full- and Sub-Band Modeling for Speech Separation…
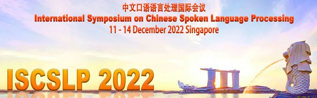
文章来源于音频语音与语言处理研究组,作者ASLPer 作为语音处理技术领域的旗舰国际会议,ISCSLP2022(International Symposium on Chinese Spoken Language Processing)将于…