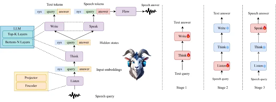
BoSS 超语义语音学:让 AI 听懂“弦外之音”

来源丨中国电信人工智能研究院 同样的文字,在不同语境下,根据说话人的语速、语气、语调的差异,会表达完全不同的意思,代表不同的情绪、态度和意图。 这项应用的背后,是中国电信人工智能研究院(TeleAI)研究的一项新的技术路径——超语义语音学(…
20 0 0

来源丨中国电信人工智能研究院 同样的文字,在不同语境下,根据说话人的语速、语气、语调的差异,会表达完全不同的意思,代表不同的情绪、态度和意图。 这项应用的背后,是中国电信人工智能研究院(TeleAI)研究的一项新的技术路径——超语义语音学(…
近日,中国矿业大学与快手科技联合研发的AudioGen-Omni模型,以面向音频-语音-歌曲三合一生成的统一多模态扩散Transformer架构,实现了高保真音频、语音与歌曲的生成,并达成与输入视频的深度时序同步。 论文链接:https:/…
来源丨AIGC开放社区 今天凌晨1点30,OpenAI开源了大模型GPT-oss,一共有1200亿和200亿两种参数,支持Apache 2.0商业化。 开源地址: https://github.com/openai/GPT-oss http…
论文题目:Multi-Input Multi-Output Target-Speaker Voice Activity Detection For Unified, Flexible, and Robust Audio-Visual Spe…
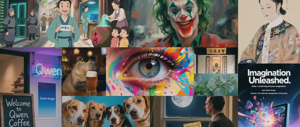
来源丨AIGC开放社区 今天,阿里开源了最新文生图模型 Qwen-Image 。 Qwen-Image是一个200亿参数的MMDiT模型,可生成写实、动漫、赛博朋克、科幻、极简、复古、超现实、水墨等几十种类型的图片,支持图片的风格迁移、增删…
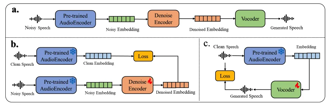
来源丨小米技术 音频理解是构建全场景智能生态的关键领域,在智能座舱、家居交互等场景均有广泛应用。今天小米发布和全量开源了 MiDashengLM-7B 模型。MiDashengLM-7B 基于 Xiaomi Dasheng 作为音频编码器和…