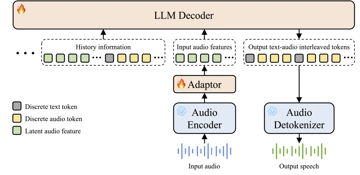
Step-Audio 2:端到端音频大语言模型,实现行业级理解与对话能力

Step‑Audio 2是由StepFun团队开发的多模态大语言模型,可直接从原始音频输入理解语义与副语言信息,并生成连贯的文本与音频响应。 模型通过隐向量音频编码器、强化学习(RL)与检索增强生成(RAG)机制,引入工具调用(如 Web…
29 0 0

Step‑Audio 2是由StepFun团队开发的多模态大语言模型,可直接从原始音频输入理解语义与副语言信息,并生成连贯的文本与音频响应。 模型通过隐向量音频编码器、强化学习(RL)与检索增强生成(RAG)机制,引入工具调用(如 Web…
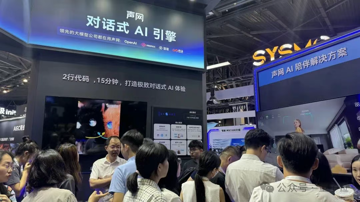
近日,声网在2025世界人工智能大会发布新版对话式 AI 引擎,该版本新增声纹识别、数字人与视觉理解三项功能,实现对话式 AI 音视频交互体验的全新升级。同时,口袋 AI 毛绒宠物—芙崽 Fuzozo、家庭陪伴机器人—赋之 EBO Air…
```mermaid graphTB A([开始])-->|输入|B[音节] B-->|析取音节的音调|C1[节调] B-->|析取音节的音质|C2[节质] C1-->|切分与声母联结的调段|D1[首调] C1-->|切分与声母联结的调段|…
近期,夸克技术团队和浙江大学联合开源了OmniAvatar,这是一个创新的音频驱动全身视频生成模型,只需要输入一张图片和一段音频,OmniAvatar即可生成相应视频,且显著提升了画面中人物的唇形同步细节和全身动作的流畅性。此外,还可通过提…
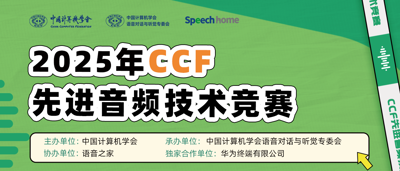
由中国计算机学会主办、CCF语音对话与听觉专委会承办、语音之家协办、华为终端有限公司独家合作的CCF先进音频技术竞赛已正式启动,大赛旨在推动国内高等院校及科研院所在音频技术领域的专业人才培养,支持学生科技创新,选拔优秀人才。 现因赛事安排调…
同声传译,被视为“翻译界的巅峰技能”。它需要译者在数秒的极短时间内转换语言,边“听”边“说”,要求极高。因此,对翻译技术研究者来说,同传一直是最具挑战的方向。 今天,字节跳动 Seed 团队正式发布端到端同声传译模型 Seed LiveIn…
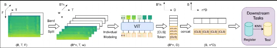
近期,来自清华大学、上海交通大学、北京华控智加科技有限公司和华北电力大学的研究者联合发布首个多模态工业信号基座模型FISHER,采用搭积木的方法对异质工业信号进行统一建模。目前技术报告和权重均已开源,欢迎使用! 论文链接:https://a…

