
声浪


保护音频隐私:语音过滤技术平衡智能设备的隐私和实用性
本文要介绍的Kirigami 是卡内基梅隆大学研究人员开发的一种设备端语音过滤器,用于在声学活动识别等应用中保护用户隐私。它具有以下特点: 基于逻辑回归的轻量级语言检测器:能将短时傅里叶变换(STFT)后的音频每一帧分类为语音或非语音,并去…
14 0 0
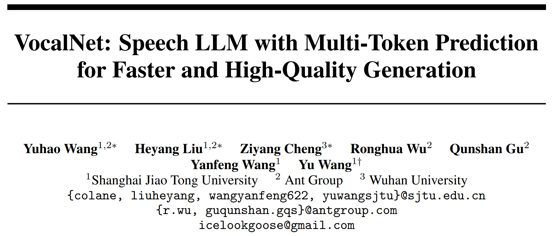
Multi-token Prediction引领语音生成新范式:上海交大、蚂蚁集团联合发布语音交互大模型VocalNet
传统级联式语音交互系统通常采用"语音识别-大语言模型-语音合成"的串联处理流程,这种架构存在明显的时延累积和信息损耗问题。相比之下,语音交互大模型通过端到端的处理方式,将语音理解和语音生成能力深度融合到大语言模型中,从而实现高性能、低时延的…
20 0 0
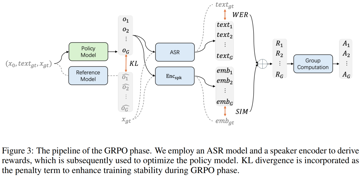
语音合成突破:F5R-TTS首次实现非自回归模型的GRPO优化,零样本克隆性能显著提升
在人工智能技术日新月异的今天,语音合成(TTS)领域正经历着一场前所未有的技术革命。最新一代文本转语音系统不仅能够生成媲美真人音质的高保真语音,更实现了「只听一次」就能完美复刻目标音色的零样本克隆能力。这一突破性进展的背后,是大规模语音数据…
20 0 0
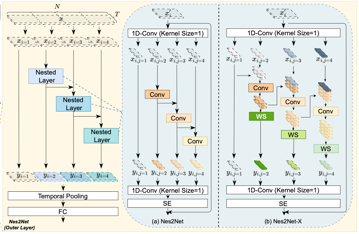
Nes2Net:轻量级嵌套架构,驱动基于语音大模型的深度伪造检测
随着语音领域生成式人工智能与音频伪造技术的迅猛发展,语音深度伪造(Deepfake),也称为语音反欺骗(Anti-spoofing),已成为信息安全领域的重要挑战。与此同时,基于语音大模型(如wav2vec 2.0 [1]、WavLM [2…
20 0 0
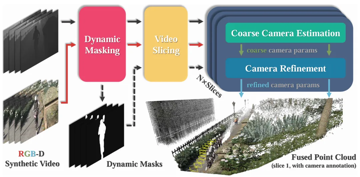
合成数据也能通吃真实世界?首个融合重建-预测-规划的生成式世界模型AETHER开源
近日,上海人工智能实验室(上海 AI 实验室)开源了生成式世界模型 AETHER。该模型全部由合成数据训练而成,不仅在传统重建与生成任务中表现领先,更首次赋予大模型在真实世界中的 3D 空间决策与规划能力,可助力机器人完成目标导向的视觉规划…
16 0 0