语音/音频处理学术速递[4.21]

今日论文合集:cs.SD语音2篇,eess.AS音频处理2篇。 cs.SD语音 【1】Decouple Non-parametric Knowledge Distillation For End-to-end Speech Translat…
152 0 0

今日论文合集:cs.SD语音2篇,eess.AS音频处理2篇。 cs.SD语音 【1】Decouple Non-parametric Knowledge Distillation For End-to-end Speech Translat…
近日,达摩院正式向公众开源工业级说话人识别通用模型CAM++,兼顾准确率和计算效率,训练labels类别达20万,每类含20~200条梅尔频谱特征。当前该模型已上线Modelscope魔搭社区,后续将陆续开源针对各场景优化的工业级模型。 模…
今日论文合集:cs.SD语音4篇,eess.AS音频处理6篇。 cs.SD语音 【1】CB-Conformer: Contextual biasing Conformer for biased word recognition标题:CB-C…
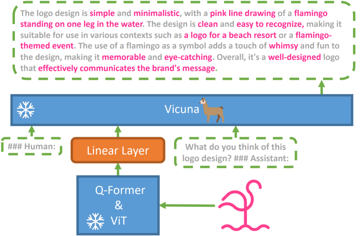
文章来源于AINLPer,作者ShuYini 引言 相比ChatGPT,GPT-4展示出了非凡的多模态能力,它可以利用手写文本生成网站并且还能够识别出图片中的幽默元素。这些优秀的能力在以前的视觉语言模型中很难实现。对于GPT-4惊人的多模态…

文章来源于DataLearner,作者DataLearner HuggingFace是目前最火热的AI社区,很多人称之为AI模型的GitHub。包括Google、微软等很多知名企业都在上面发布模型。 HuggingFace简介:https:…
今日论文合集:cs.SD语音7篇,eess.AS音频处理10篇。 cs.SD语音 【1】A Scalable Framework for Automatic Playlist Continuation on Music Streaming…

语音之家联合WeNet社区2022年6月推出《WeNet语音识别实战》第1期课程上线即广受好评,2022年10月更新的第2期课程有最新的代码和丰富的实战性作业更受学员追捧,学习群内讲师及助教有问必答,帮助很多落地WeNet的开发者解决了实际…

想要训练GPT-4的小伙伴们看过来!由AI2、华大、哥大等单位联合推出了由5.8亿图片、1亿文档、430亿token组成的超大文本图片交织数据集。旨在支持上下文视觉和语言模型的研究。这是训练开源大模型OpenFlamingo的训练数据集。…

今日论文合集:cs.SD语音11篇,eess.AS音频处理14篇。 cs.SD语音 【1】Conditional Generation of Audio from Video via Foley Analogies标题:通过Foley类比从…
文章来源于AINLPer,作者ShuYini 引言 前段时间,清华公布了中英双语对话模型ChatGLM-6B,具有60亿的参数,初具问答和对话功能。最!最!最重要的是它能够支持私有化部署,大部分实验室的服务器基本上都能跑起来。 因为条件特殊…