
音乐检索进入“多模态对齐”时代:清华 CLaMP-3 的三大极限突破

CLaMP 3,作为一款多模态、多语言的音乐信息检索框架,为音乐爱好者、创作者、教育者以及研究者们带来了全新的体验与可能。本文将深入剖析CLaMP 3的技术原理、核心功能、应用场景,带你全面了解这一创新框架。 项目官网:https://sa…
12 0 0

CLaMP 3,作为一款多模态、多语言的音乐信息检索框架,为音乐爱好者、创作者、教育者以及研究者们带来了全新的体验与可能。本文将深入剖析CLaMP 3的技术原理、核心功能、应用场景,带你全面了解这一创新框架。 项目官网:https://sa…

来源丨机器之心 DeepSeek-R1 非常热门,而在其公布的训练配方中,GRPO(Group Relative Policy Optimization)非常关键,是 DeepSeek-R1 核心的强化学习算法。 PPO 与 GRPO 的对…

大型语言模型(LLMs)在各种下游任务中取得了显著进展,启发了业界对语音理解语言模型(speech understanding language models, SULMs)的研发,以期实现基于语音情感、性别等副语言的高表现力交互。然而,大…
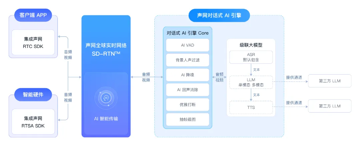
DeepSeek 旋风席卷全球,其独有的深度思考+联网模式让用户纷纷惊叹好用,如果你想脱离与 AI 的文字互动,与 DeepSeek 进行更具真实感的语音对话,声网的对话式 AI 引擎仅15分钟内就能做到。 近日,声网对话式 AI 引擎 B…

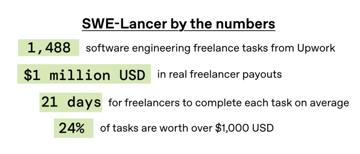
来源丨机器之心 今天凌晨2点,OpenAI开源了一个全新评估大模型代码能力的测试基准——SWE-Lancer。 开源地址:https://github.com/openai/SWELancer
最近,西工大音频语音与语言处理研究组(ASLP@NPU)与南洋理工大学(NTU)合作的论文 “GenSE: Generative Speech Enhancement via Language Models using Hierarchic…
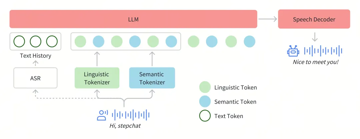
最新发布的产品级开源语音交互模型Step-Audio,可以根据不同的场景需求生成情绪、方言、语种、歌声和个性化风格的表达,可与用户自然地进行高质量对话。模型生成的语音具有自然流畅、情商高等特征,同时也能支持不同角色的音色克隆。 GitHub…
