
Interspeech2025|基于LLM与自监督训练模型的中文方言语音识别对比研究

大规模训练语料库极大地提高了语音识别(ASR)模型的性能。然而由于数据相对匮乏,口音和方言仍然是大多数ASR模型面临的挑战。自监督学习的最新进展表明,其与大型语言模型(LLM)相结合,可以有效提高低资源场景下的 ASR 性能。 近期,西工大…
24 0 0

大规模训练语料库极大地提高了语音识别(ASR)模型的性能。然而由于数据相对匮乏,口音和方言仍然是大多数ASR模型面临的挑战。自监督学习的最新进展表明,其与大型语言模型(LLM)相结合,可以有效提高低资源场景下的 ASR 性能。 近期,西工大…

在真实对话里,插话、停顿、甚至讲话重叠都很常见。如果语音 AI 的回应太早、太晚、或者干脆没有回应,整个用户体验就会变得很“出戏”。对话中的“怎么说”往往比“说了什么”更重要。一段停顿可能代表犹豫、礼貌、自信等不同含义。为了让语音 AI 真…


在 AI 语音模型领域,不论开源还是闭源模型,能在全球排上前十的屈指可数,而 FishAudio 团队语音模型就在其列,每每有新模型上线,总能排进TTS-Arena TOP3之内。 近期,Fish Audio 推出了新一代的 TTS 语音模…

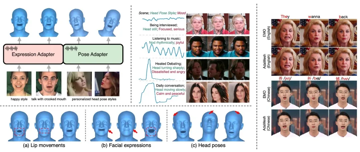
语音驱动的三维人脸动画旨在根据输入语音生成同步的面部运动,这项技术近年来受到了广泛关注。然而,现有方法普遍忽略了说话者的个性化风格,例如独特的面部表情和头部姿态,导致生成的人脸动画缺乏真实感和个性表达。部分工作尝试通过微调模型来建模不同人物…

FlowDirector团队投稿 量子位 | 来源 AI的视频编辑方法总是存在一些问题:例如视频运动不连贯、编辑后的视频产生意外变化等……经过分析,这些问题的产生最终大都指向同一原因——反演-编辑范式。 因此,西湖大学AGILab提出了一种…

随着汽车成为人们日常生活中不可或缺的一部分,而驾驶舱中传统的触摸交互方式容易分散驾驶员的注意力,存在安全风险,因此,车内基于语音的交互方式得到重视。与通常家庭或会议场景中的语音识别系统不同,驾驶场景中的系统面临更加独特的挑战,缺乏大规模的公…
