IEEE TASLP | 基于文本-语音跨模态表征的对话语音识别

随着语音技术的不断发展,在诸如会议转录和语音助手等各种应用中,大家对对话语音接口的需求出现了迅速增长。我们需要在现有语音系统的基础上,进一步拓展其对对话语音的识别能力。对话语音有其独有的特征,如角色偏好(role preferences)和…
93 0 0

随着语音技术的不断发展,在诸如会议转录和语音助手等各种应用中,大家对对话语音接口的需求出现了迅速增长。我们需要在现有语音系统的基础上,进一步拓展其对对话语音的识别能力。对话语音有其独有的特征,如角色偏好(role preferences)和…

苹果发布基于开源训练和推理框架的高效语言模型族 OpenELM。 要说 ChatGPT 拉开了大模型竞赛的序幕,那么 Meta 开源 Llama 系列模型则掀起了开源领域的热潮。在这当中,苹果似乎掀起的水花不是很大。 不过,苹果最新放出的论…
最大开源模型,再次刷爆纪录!Snowflake的Arctic,以128位专家和4800亿参数,成为迄今最大的开源模型。它的特点,是又大又稀疏,因此计算资源只用了不到Llama 3 8B的一半,就达到了相同的性能指标。 就在刚刚,拥有128位…

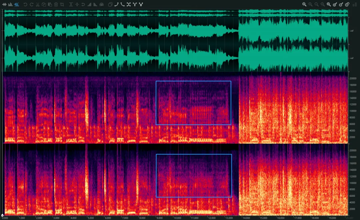
前两天FFmpeg作者Fabrice Bellard在个人主页发布了一款音频压缩工具TSAC。根据官网介绍,TSAC可达到非常低的比特率,例如44.1 kHz采样率下的码率可以达到单声道 5.5 kb/s 或立体声 7.5 kb/s,具有良…
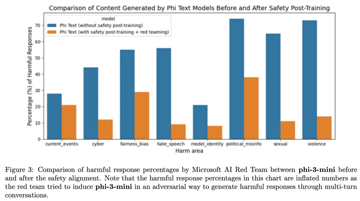
Llama-3 刚发布没多久,竞争对手就来了,而且是可以在手机上运行的小体量模型。 本周二,微软发布了自研小尺寸模型 Phi-3。 新模型有三个版本,其中 Phi-3 mini 是一个拥有 38 亿参数的语言模型,经过 3.3 万亿 tok…

声学室模拟允许在AR眼镜上以最少的真实数据进行训练,用于开发鲁棒的语音识别声音分离模型。 随着增强现实(AR)技术的强大和广泛应用,它能应用到各种日常情境中。我们对AR技术的潜能感到兴奋,并持续不断地开发和测试新技术与体验。其中一个研究方向…