论文分享 | 利用对比学习和知识蒸馏进行缺失模态谣言检测
本次分享由江西师范大学与Institute for Infocomm Research, A*STAR联合投稿于EMNLP 2023 的一篇论文《Leveraging Contrastive Learning and Knowledge D…
53 0 0
本次分享由江西师范大学与Institute for Infocomm Research, A*STAR联合投稿于EMNLP 2023 的一篇论文《Leveraging Contrastive Learning and Knowledge D…

号称不可能轻易被击败的AGI基准ARC-AGI被GPT-4o撼动,GPT-4o以在公共测试集50%、在训练集71%的准确率成为了新的SOTA! ARC-AGI是唯一可以用来衡量通用人工智能进展的基准,创造者François Chollets…
分享8篇通义实验室在 INTERSPEECH 2024 和 ACL 2024 中稿的论文,涵盖音频理解与生成、语音情感表示、语音合成、语音分离、说话人验证、自动语音识别等多个技术方向。 INTERSPEECH是国际语音通讯协会(ISCA)组…
西工大音频语音与语言处理研究组(ASLP@NPU)将在INTERSPEECH 2024携合作伙伴宣读论文14篇,论文的合作单位包括腾讯、出门问问、小米、网易、字节跳动、爱奇艺、阿里巴巴、喜马拉雅、度小满、香港中文大学等。以下是发表论文的相关…
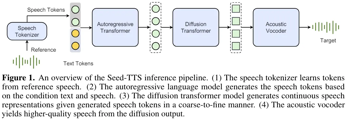
TTS 是指文本转语音,这是一种具备诸多妙用的技术,像是让个人智能助理说话、为视频或游戏配音、辅助视障人士、制作有声书等等。对于 TTS 技术研发者来说,流畅自然的表达一直以来都是值得追求的重要目标。 字节跳动 Seed Team 发布的…
论文题目:利用噪声感知的标签集成和样本选择改进说话人验证:学习并矫正噪声说话人标签 作者列表:方志华,何亮*,李琳,胡英 单位:(1)新疆大学计算机科学与技术学院,乌鲁木齐 830017; (2)清华大学电子工程系,北京 100084; (…
AI圈这遍地开花的大好局面,让吃瓜群众们甚是惊喜。 自 Sora 发布以来,国内外各大科技公司和研究机构都在竞相推出“文生视频”大模型,比如生数科技的 Vidu、快手的可灵和 Runway 昨天才发布的 Gen-3 Alpha 等。 然而,…