ICASSP2024 | MLCA-AVSR: 基于多层交叉注意力机制的视听语音识别
视听语音识别(Audio-visual speech recognition, AVSR)是指结合音频和视频信息对语音进行识别的技术。当前,语音识别(ASR)系统在准确性在某些场景下已经达到与人类相媲美的水平。然而在复杂声学环境或远场拾音场…
94 0 0
视听语音识别(Audio-visual speech recognition, AVSR)是指结合音频和视频信息对语音进行识别的技术。当前,语音识别(ASR)系统在准确性在某些场景下已经达到与人类相媲美的水平。然而在复杂声学环境或远场拾音场…


谷歌大模型,开源了! 一夜之间,Gemma系列正式上线,全面对外开放。 它采用Gemini同款技术架构,主打开源和轻量级,免费可用、模型权重开源、允许商用,同时笔记本可跑。 共有2B和7B两个版本,性能全面超越开源标杆Llama 2。 每种…


好的研究不会被埋没,只会历久弥新。 虽然已经发布近一周时间,OpenAI 视频生成大模型 Sora 的影响仍在继续! 其中,Sora 研发负责人之一 Bill Peebles 与纽约大学助理教授谢赛宁撰写的 DiT(扩散 Transform…


高质量的助听器能让有听力障碍的用户轻松自如地进行交流。我们的头和躯干模拟器、耳模拟器和人工乳突为优化音频质量和清晰度提供了全面的测试解决方案。 开发助听器时,所需要的系统要能够进行测试、提供基准、控制质量并提升产品设计,同时,还要考虑到声音…

语音增强 (Speech Enhancement) 旨在从噪声和混响等多种干扰中恢复并提升语音的质量及可懂度,以提升人耳听感和语音识别率。在深度学习的推动下,基于神经网络的语音增强技术取得了巨大的进展,在诸多数据集上都取得了卓越的性能。近期…

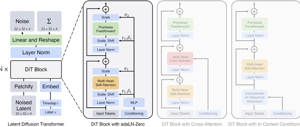
OpenAI Sora文生视频(图像看作单帧视频)一放出就炸翻整个AI 圈,也是ChatGPT掀起GenAI热潮时隔一年后,OpenAI再次史诗级的更新。OpenAI 随后公布的技术综述[文献1],难掩其勃勃雄心:视频生成模型作为世界模拟器…