Suno 5.5 发布 允许用户克隆声音演唱 AI 生成歌曲

AI音乐公司Suno正式发布其音乐生成器5.5版本。除了音质提升外,用户现在还可以用自己的声音演唱歌曲,并训练模型以匹配个人风格。Suno推出了其音乐模型的5.5版本,该公司称这是其“迄今为止最好、最具表现力的模型”。此次更新围绕三项新功能…
26 0 0

AI音乐公司Suno正式发布其音乐生成器5.5版本。除了音质提升外,用户现在还可以用自己的声音演唱歌曲,并训练模型以匹配个人风格。Suno推出了其音乐模型的5.5版本,该公司称这是其“迄今为止最好、最具表现力的模型”。此次更新围绕三项新功能…
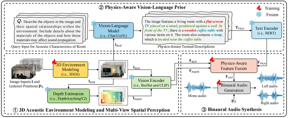
作者:罗立昂,编辑:冯小雨,审核:关键 在追求沉浸式体验的道路上,空间音频扮演着至关重要的角色。想象一下,在虚拟现实中,不仅能看到逼真的场景,还能听到与场景几何、物体材质、布局息息相关的真实声场,这才是真正的“身临其境”。然而,新视角声学合…
随着大语言模型(LLMs)特别是音频大模型(Audio-LLMs)和全能模型(Omni-models)的快速发展,口语对话系统取得了显著进步,不断缩小人机交互与人人交互之间的差距。为了实现真正“类人”的交流,系统需要具备双重能力:一是感知并…
本文来源丨微软亚洲研究院 近日,微软亚洲研究院发布了一款通用的语音识别模型VibeVoice ASR,单次转录可处理长达 60 分钟的连续音频,并能够可靠地生成丰富、结构化的输出,清晰地记录说话者是谁以及其说话时间。作为一种全新的语音识别范…
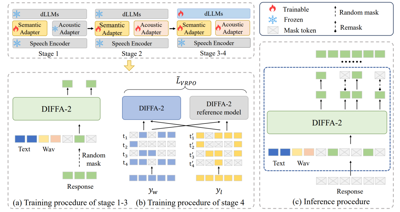
本文介绍的是南开大学人机语言技术实验室(NKU-HLT)与美团 LongCat Interaction 合作团队近期完成的一项研究工作——DIFFA-2。该工作延续了在 AAAI 2026 提出的 DIFFA(DIFFA: Large La…
本文来源:阿里云云原生 作者:雀贤、文婷、复礼、稚柳 随着大语言模型(LLM)、语音识别(ASR)、语音合成(TTS)等能力逐步成熟,AI Agent 开始从文本交互走向语音交互,典型场景包括 AI 教师、AI 情感聊天、AI 助手等。相比…
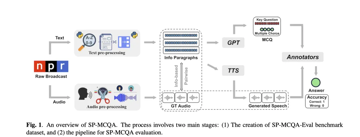
「现存问题」 TTS(文本转语音)这两年进步很快,很多模型在测试集上能做到很低的 WER(词错误率),听起来“字面上没问题”。 但现实场景里,用户真正关心的往往不是“每个词都对”,而是: 这段语音里提到的关键信息我能不能抓住?例如:日期、金…
