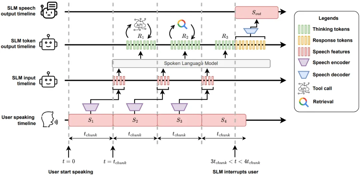
台大李宏毅与微软合作提出 SHANKS:能够边聆听边深度思考的口语语言模型

ChatGPT、DeepSeek等语言模型具备「深度推理」(Reasoning)能力,这类模型会在回答问题前先进行一段较长的推论过程,使回答的品质大幅提升。 不过,这种「等使用者说完话才开始思考」的方式,虽然在纯文字的使用场景能够被接受,却…
22 0 0

ChatGPT、DeepSeek等语言模型具备「深度推理」(Reasoning)能力,这类模型会在回答问题前先进行一段较长的推论过程,使回答的品质大幅提升。 不过,这种「等使用者说完话才开始思考」的方式,虽然在纯文字的使用场景能够被接受,却…
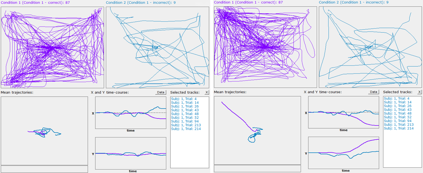
东南大学外国语学院博士生导师陈彧教授和博士生王一诺、北京航空航天大学外国语学院博士生曹盛勤,东南大学外国语学院博士后研究员李洋在语言学SSCI、A&HCI 期刊Lingua发表题为Mandarin Citation Tone Percept…
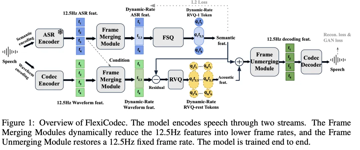
FlexiCodec是一个支持推理时动态调整平均帧率至3Hz到12.5Hz之间的Codec。 论文预印版:https://arxiv.org/abs/2510.00981 模型展示页面:https://flexicodec
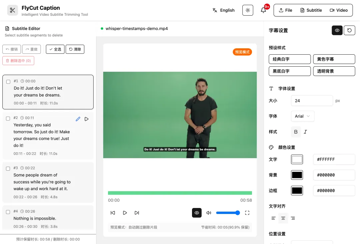
分享一款非常实用、创意十足的开源AI视频字幕编辑工具 — FlyCut Caption。 它不是那种复杂到需要剪辑经验的视频编辑器,而是一款基于 AI 的智能字幕编辑工具,能让你通过“改字幕”来“剪视频”。 也就是它不仅能智能生成字幕,还支…
2025年第二十届全国人机语音通讯学术会议(National Conference on Man-Machine Speech Communication,NCMMSC2025)将于2025年10月16~19日在江苏镇江召开。本次会议由中国…
来源丨机器之心 单 GPU 级世界模型来了。斯坦福大学教授李飞飞创业公司 World Labs 又推出了新成果! 上个月,World Labs 发布了空间智能模型 Marble,「只需一张图片,就能生成持久存在的 3D 世界,比以往更宏大、…
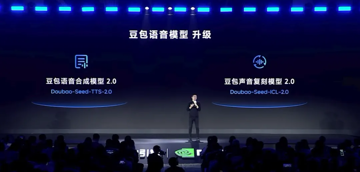
今天,火山引擎发布了豆包语音合成模型2.0(Doubao-Seed-TTS 2.0)和豆包声音复刻模型2.0(Doubao-Seed-ICL 2.0)。此次升级基于豆包大语言模型研发语音合成新架构,让合成和复刻的声音都能解锁深度语义理解和上…
