清华和盛大东京团队提出Hive数据集:以数据质量取代规模,实现高效通用声音分离

基于查询的通用声音分离(USS)技术旨在通过文本、音频等多模态提示从混合信号中分离出目标声音。这项技术能够应用于沉浸式音频渲染、智能音频编辑和辅助听力设备等应用,实现对复杂声学环境中任意声源的精准提取。 尽管近年来方法架构不断演进,现有基于…
33 0 0

基于查询的通用声音分离(USS)技术旨在通过文本、音频等多模态提示从混合信号中分离出目标声音。这项技术能够应用于沉浸式音频渲染、智能音频编辑和辅助听力设备等应用,实现对复杂声学环境中任意声源的精准提取。 尽管近年来方法架构不断演进,现有基于…
AI 音频初创公司ElevenLabs在 D 轮融资中筹集了 5 亿美元。 据报道,此轮融资使这家初创公司的估值达到 110 亿美元,比一年前的估值增长了三倍多。 本轮融资由红杉资本领投,其合伙人安德鲁·里德(Andrew Reed)加入…
来源丨量子位 火星撞地球,新模型大战! Claude Opus 4.6发布仅仅15分钟,OpenAI也甩出了自己最新最强编程模型—— GPT-5.3-Codex。 最直观的感受是,这个新模型终于有点美学品味了。 官方展示了两个Demo:一个…
通义实验室语音团队提出一种基于心理学 PAD 模型的情感语音合成框架,支持用户在愉悦度(Pleasure)、唤醒度(Arousal)和支配度(Dominance)上灵活控制情感表达。无需依赖固定情感标签,就能自由组合出“温柔但坚定”“兴奋而…
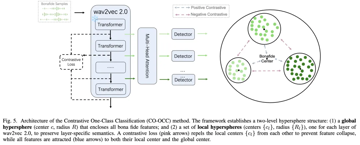
想象这样一个场景:你使用声纹锁保护隐私,攻击者在旁边播放了一段看似普通的陌生人录音(比如一段新闻或别人的谈话)。人耳听不出异样,声纹锁却被“欺骗”并打开了——这就是物理信道(OTA)对抗攻击。 以往,空气中的噪音和回声是天然的屏障,会让这种…
本期分享杭州电子科技大学智能语音课题组在信号处理领域顶级会议ICASSP 2026上录用的3篇论文,入选论文涵盖生成式语音增强、高保真神经音频压缩以及基于最优传输的无监督学习。作为IEEE主办的全球旗舰会议,ICASSP是语音与音频前沿技术…
近日,ICASSP 2026会议发出了审稿结果通知,上海交通大学跨媒体语言智能实验室共12篇论文被会议接收。我们将用两期推送介绍接收论文,本文是第二期。 07、Task Vector in TTS: Toward Emotionally E…
