智源研究院发布千万级多模态指令数据集Infinity-MM:驱动开源模型迈向SOTA性能

近年来,视觉语言模型(VLM)取得了显著进展,训练数据的规模扩展以及数据质量的提升是提升模型性能的关键因素。目前主要的获取数据方式为通过人工对数据进行收集和标注以及利用模型对指令进行合成,业内也有许多工作专注于此。然而,现有的开源数据和指令…
4 0 0

近年来,视觉语言模型(VLM)取得了显著进展,训练数据的规模扩展以及数据质量的提升是提升模型性能的关键因素。目前主要的获取数据方式为通过人工对数据进行收集和标注以及利用模型对指令进行合成,业内也有许多工作专注于此。然而,现有的开源数据和指令…
近日,香港中文大学(深圳)联手趣丸科技推出了新一代大规模声音克隆TTS模型——MaskGCT。该模型在包含10万小时多语言数据的Emilia数据集上进行训练,展现出超自然的语音克隆、风格迁移以及跨语种生成能力,同时保持了较强的稳定性。Mas…
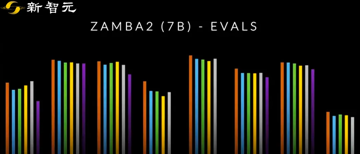
来源丨新智元 Zamba2-7B是一款小型语言模型,在保持输出质量的同时,通过创新架构实现了比同类模型更快的推理速度和更低的内存占用,在图像描述等任务上表现出色,能在各种边缘设备和消费级GPU上高效运行。 除了不断增加语言模型的尺寸来提升性…
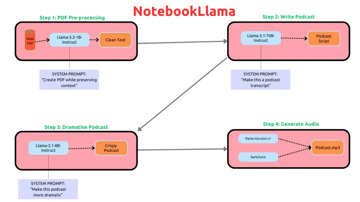
来源丨机器之心 随着谷歌和 Meta 相继推出基于大语言模型的 AI 播客功能,将极大地丰富人类用户与 AI 智能体互动的体验。 上个月,谷歌宣布对旗下 AI 笔记应用 NotebookLM 进行一系列更新,允许用户生成 YouTube 视…
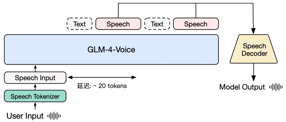
来源丨学术头条 今天,在 CNCC2024 大会上,智谱也推出了他们在多模态领域的最新成果——端到端语音模型 GLM-4-Voice,让人和机器的交流能够以自然聊天的状态进行。 据介绍,GLM-4-Voice 能够直接理解和生成中英文语音,…
来源丨新智元 Mistral 7B诞生一周年之际,法国AI初创公司Mistral再次连发两个轻量级模型Ministral 3B和Ministral 8B,性能赶超Llama 3 8B。 Mistral 7B仅仅发布一周年,法国AI初创小模型…
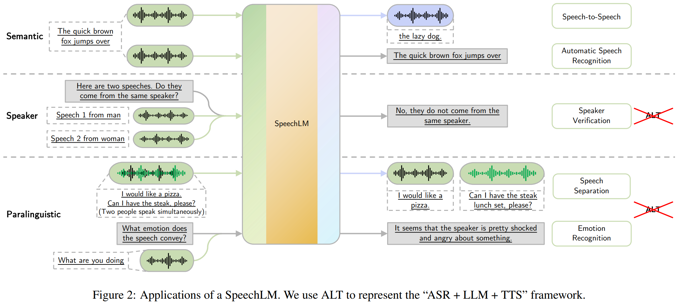
近期,大型语言模型(LLMs)在生成文本和执行各种自然语言处理任务方面展现出了卓越的能力,成为了强大的AI驱动语言理解和生成的基础模型。然而,仅依赖于基于文本模态的模型存在显著局限性。这促使了基于语音的生成模型的发展,使其能够更自然、直观地…
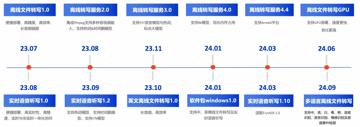
FunASR是由通义实验室开源的语音识别框架,集成了语音端点检测、语音识别、标点预测等领域的工业级模型的训练和部署,吸引了众多开发者参与体验和开发。 为了支持用户便捷高效的集成语音AI能力,FunASR社区推出了服务部署社区软件包,支持Do…
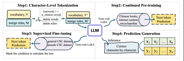
论文题目:C-LLM: Learn to Check Chinese Spelling Errors Character by Character 作者列表:李堃婷,胡勇,何亮*,孟凡东,周杰 单位:新疆大学计算机科学与技术学院、清华大学电…
近期,OpenAI提出了Orchestrating Agents,并同时开源了Swarm,一个轻量级的多智能体编排框架,目前仅是示范框架,并没有计划用于生产。 使用语言模型时,我们通常需要好的prompt并结合较强工具调用能力,Orches…