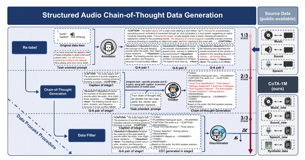
【交我学-37】从“听见”到“听懂”:多模态基础模型中的音频推理综述

AudioCC交我学 这一期我们想聊的不是某一个具体模型,而是一个最近越来越绕不开的问题:当语音大模型、音频大模型和 omni 模型都开始变强之后,模型到底有没有真的“听懂”声音? 过去几年,大家更熟悉的是 ASR、audio captio…
37 0 0

AudioCC交我学 这一期我们想聊的不是某一个具体模型,而是一个最近越来越绕不开的问题:当语音大模型、音频大模型和 omni 模型都开始变强之后,模型到底有没有真的“听懂”声音? 过去几年,大家更熟悉的是 ASR、audio captio…
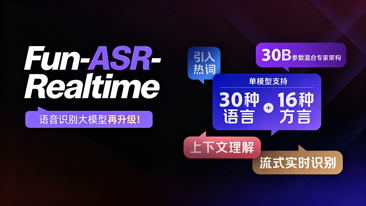
来源丨千问大模型 今天,阿里通义升级实时语音识别大模型Fun-ASR-Realtime——一款首字延迟控制在百毫秒级别、识别准确率接近离线模型的流式语音识别模型,支持16种方言和30种语言。 阿里云百炼: Fun-ASR-Realtime:…
今年的各大学术会议平台陆续公布了赛事征集和开赛的赛事信息,为帮大家一站式掌握赛程、主题及报名窗口,语音之家梳理了6个会议平台上的赛事信息,针对还在开赛中的赛事做一个分享。 ISCSLP 2026 中文口语语言处理国
美东时间2026年06月30日,东南大学外国语学院博士生导师陈彧教授联合天津理工大学聋人工学院张句博士题为Perception of Synthesized Mandarin Speech Based on a Large-Scale La…
分享武汉大学电子信息学院智能音频与语音感知实验室在Interspeech 2026中稿的13篇论文,论文涵盖语音增强、声源定位、声音事件检测、音频表征、音频大模型等多个研究方向。 ⏩一、多通道语音增强与鲁棒波束形成 Joint Learni…
论文题目:SemanticAudio: Audio Generation and Editing in Semantic Space Demo:https://semanticaudio1.github.io/ 论文地址:https://a…
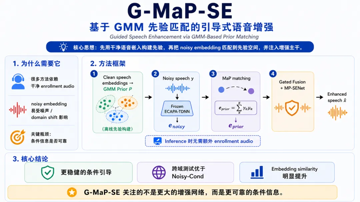
在真实录音场景中,语音增强并不是简单地“把噪声去掉”。更实际的目标是:在压制背景噪声、干扰说话人和录音失真的同时,尽量保留目标说话人的音色、内容和自然度。手机通话、在线会议、智能耳机和语音交互设备中,这类需求都非常常见,也对增强模型的鲁棒性…
来源丨新智元 全球第一!中国AI语音ViiTorVoice首创「局部编辑」神技:配音错字告别重录,像改Word一样修语音。内附姆巴佩、哈兰德爆笑实测,快来见证! 中国AI,登顶全球第一! 最近,在全球语音权威评测榜单 Seed-TTS 上,…
