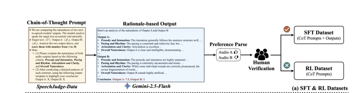
SpeechJudge:让机器真正理解“人类觉得什么是自然”

语音合成(TTS)领域长期存在一个矛盾:机器判断的“自然”与人类主观感受脱节。 这样的场景常常出现:你让AI生成一段语音,客观指标显示“完美”(如WER=0、FAD极低),但听起来却像机器人在背书。 如何让机器get到人类觉得“自然”的点?…
28 0 0

语音合成(TTS)领域长期存在一个矛盾:机器判断的“自然”与人类主观感受脱节。 这样的场景常常出现:你让AI生成一段语音,客观指标显示“完美”(如WER=0、FAD极低),但听起来却像机器人在背书。 如何让机器get到人类觉得“自然”的点?…
百灵多模态团队节前前发布了 Ming-flash-omni-2.0,基于其语音模块,我们新发布了 Ming-omni-tts,通过模型 scale up 实现了更强的效果。 不管你是短视频博主配旁白,独立播客创作者想把单人对话变成双人播客,…
在大语言模型(LLM)的演进中,文本分词器(Tokenizer)作为离散接口,为模型的压缩、理解、生成与上下文学习奠定了基石。然而,在音频领域,如何构建一个简单、同构且具备强大扩展潜力(Scalable)的离散接口,依然是通往“原生音频大模…
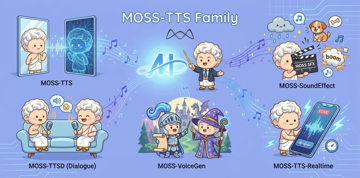
2月10日,由上海创智学院孵化的模思智能及OpenMOSS团队正式发布并开源了MOSS-TTS Family。模型发布后,壁仞科技(06082.HK)旗舰产品壁砺™ 166M率先完成其中语音生成基座MOSS-TTS模型的高性能推理部署。作为…
过去一年,生成式人工智能在音乐行业的应用正不断创造新体验,但歌唱语音合成领域(SVS,Singing Voice Synthesis)整体进展相对缓慢。 为拓展这一领域,近日,Soul App AI 团队(Soul AI Lab)与吉利汽车…
