论文分享 | SpeechFormer: 利用语音信号的层次化特性提升Transformer在认知性语音信号处理领域中的性能
文章来源于智能语音新青年,作者ttslr 本次分享华南理工大学在INTERSPEECH2022会议发表的论文《SpeechFormer: A Hierarchical Efficient Framework Incorporating th…
105 0 0

文章来源于智能语音新青年,作者ttslr 本次分享华南理工大学在INTERSPEECH2022会议发表的论文《SpeechFormer: A Hierarchical Efficient Framework Incorporating th…

文章来源于音频语音与语言处理研究组,作者雷怡 语音合成 (Text-to-speech, TTS) 是将文本转换为自然语音的一类技术,是服务于语音交互、信息播报、有声朗读等任务的核心技术。在深度学习的推动下,语音合成的自然度和音质得到了极大…

文章来源于新一代Kaldi,作者NGK编辑部 本文介绍据我们所知, 第一个使用ncnn进行语音识别的开源项目sherpa-ncnn。 简介 sherpa[1]目前支持使用PyTorch做推理框架,进行语音识别。当模型使用PyTorch训练好…

文章来源于它思科技,作者THU-SPMI 本文介绍清华大学语音处理与机器智能实验室(Speech Processing and Machine Intelligence, SPMI)与中国移动研究院(CMRI)的联合工作——MGA:一种马尔…

文章来源于九章智驾,作者Engineer X 引文 随着硬件水平的提升、算法的迭代,汽车的智能化水平也逐渐提升。从L1到L4,从简单的车道巡航功能到城区内自动驾驶,我们可以看到智能驾驶逐渐落地和普及。 在智能驾驶水平不断进步的同时,我们也看…

北科瑞声 深圳市北科瑞声科技股份有限公司是国内人工智能音频细分领域领军企业,专注于行业智能音频交互技术,拥有全链条核心自主知识产权。北科瑞声创始团队来自香港科技大学、中国科技大学和北京大学。目前北科瑞声总部位于深圳,在香港、广州、南京和青岛…

作者 | 李梅 来源丨AI科技评论 机器翻译是现今人类消除语言障碍、重建巴别塔的新工具。然而,在世界现存的 7000 多种已知语言中,许多低资源语言还未得到足够的关注,尤其是有近一半的语言没有标准的书面系统,这是构建机器翻译工具的一大障碍,…
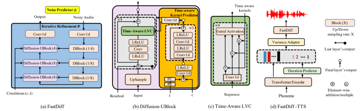
文章来源于PaperWeekly,作者黄融杰 扩散模型在深度生成模型中自成一派,最近成为最热门的话题之一。扩散模型展示了强大的生成能力,无论是生成高水平的细节还是其生成的多样性,都让人印象深刻。 扩散生成模型将生成式建模领域的标准提高到了一…

今日论文合集:cs.SD语音12篇,eess.AS音频处理11篇。 cs.SD语音 【1】 Audio-to-Intent Using Acoustic-Textual Subword Representations from End-to…

奇梦者 奇梦者是一家人机交互技术服务提供商,专注于基础语音和声学技术的研究,致力于通过人工智能技术让机器听得见、听得清、听得远、听得懂,更好地感知世界。 奇梦者是一家全链路声学感知和语音技术的高科技公司,一直从事麦克风阵列技术、语音信号处理…