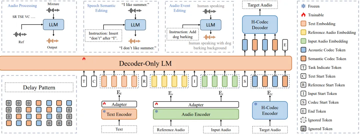
QuarkAudio: 基于语义声学解耦离散表征的音频编辑与生成大模型

近日,千问C端AI人机交互团队联合通义实验室在音频大模型领域取得重要进展,正式开源QuarkAudio:一个面向端到端音频处理与生成的统一建模框架。QuarkAudio基于离散化音频表征实现了对语音修复、音频生成与编辑等多样化任务的统一建模…
47 0 0

近日,千问C端AI人机交互团队联合通义实验室在音频大模型领域取得重要进展,正式开源QuarkAudio:一个面向端到端音频处理与生成的统一建模框架。QuarkAudio基于离散化音频表征实现了对语音修复、音频生成与编辑等多样化任务的统一建模…
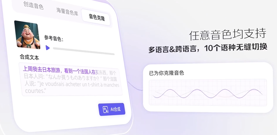
说实话,今年语音模型的内卷程度已经到了不讲武德的地步。但这次,Qwen3-TTS 的更新,是真的有点狠。 阿里通义刚刚上线了 Qwen3-TTS 的两大核心能力: •VoiceDesign(VD-Flash):用文字“设计”声音,而不是选声…
本系列十篇文章,旨在对之前提到的十大趋势进行详细剖析。 关于未来语音技术和应用趋势的10点看法 本系列中将穿插科普、技术综述、技术发展路线,以及来自我个人与其他行业专家的思考。希望不论读者此前对语音技术与应用了解多少,都能从这一系列文章中获…
昨天,阿里通义开源新一代语音交互模型 Fun-Audio-Chat-8B。该模型在OpenAudioBench、VoiceBench、UltraEval-Audio、MMAU、MMSU、SpeechFunctionCall 等多项权威基准测…
官方 Blog: https://developers.google.com/health-ai-developer-foundations/medasr huggingface: https://huggingface.co/google…
大家好,欢迎来到「AudioCC交我学」专栏! 作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术…
GLM-4.7上线并开源。新版本面向Coding场景强化了编码能力、长程任务规划与工具协同,并在多项主流公开基准测试中取得开源模型中的领先表现。 目前,GLM-4.7已通过BigModel.cn提供API,并在z.ai全栈开发模式中上线Sk…
