
声浪

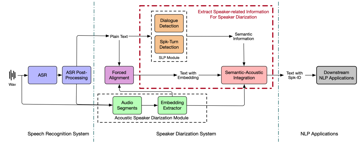
多模态说话人开源项目3D-Speaker

3D-Speaker是通义实验室语音团队贡献的一个结合了声学、语义、视觉三维模态信息来解决说话人任务的开源项目。本项目涵盖说话人日志,说话人识别和语种识别任务,开源了多个任务的工业级模型,训练代码和推理代码。 本项目同时还开源了相应的研究数…
129 0 0
Meta新算法提高语音识别的清晰度和鲁棒性
语音识别系统应该足够强大,能够适合所有人群——包括具有不同说话风格、口音和其他特征的人群。为了衡量自动语音识别(ASR)工具在不同人口群体中的表现,人工智能从业者需要多样化的语音数据。为了与开放科学方法保持一致,Meta发布了一个以公平为导…
56 0 0
ICASSP2024 | 面向多种阵列拓扑的多通道语音识别模型:自动通道选择和空间特征融合

多通道语音识别(Multi-channel ASR)的目标是识别由多个麦克风(如麦克风阵列)拾取的多通道音频,相较于标准的单通道语音识别,多通道语音识别通过有效利用多通道信号提供的空间信息,帮助提升语音识别的性能。在实际应用中,由于麦克风阵…
56 0 0
ICASSP2024 | MLCA-AVSR: 基于多层交叉注意力机制的视听语音识别
视听语音识别(Audio-visual speech recognition, AVSR)是指结合音频和视频信息对语音进行识别的技术。当前,语音识别(ASR)系统在准确性在某些场景下已经达到与人类相媲美的水平。然而在复杂声学环境或远场拾音场…
79 0 0
谷歌最强开源大模型亮相!Gemini技术下放,笔记本就能跑,可商用
谷歌大模型,开源了! 一夜之间,Gemma系列正式上线,全面对外开放。 它采用Gemini同款技术架构,主打开源和轻量级,免费可用、模型权重开源、允许商用,同时笔记本可跑。 共有2B和7B两个版本,性能全面超越开源标杆Llama 2。 每种…
70 0 0