声浪

BASE TTS:基于10万小时的1B流式TTS大模型

Abstract 我们介绍了一个文本到语音(TTS)模型,称为BASE TTS,它代表具有涌现能力的大自适应流TTS。 BASE TTS是迄今为止最大的TTS模型,在10万小时的公共领域语音数据上进行了训练,实现了语音自然度的新技术。 它部…
88 0 0
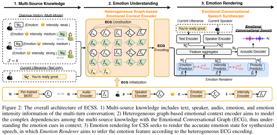
论文分享|AAAI2024 基于异构图上下文建模实现对话语音合成的情感渲染
本次分享内蒙古大学S2LAB与字节跳动、港中文(深圳)合作,关于情感对话语音合成的工作《Emotion Rendering for Conversational Speech Synthesis with Heterogeneous Gra…
48 0 0
Sora物理悖谬的几何解释
龙年伊始,Sora横空出世,举世震惊。Sora声称“作为世界模拟的视频生成模型”,豪气干云。有人悲观预言很多传统领域可能被颠覆,其中最为岌岌可危的可能是计算机图形学,短视频和影视娱乐行业。依随OpenAI透露出更多技术细节,很多Sora生成…
43 0 0
谷歌最强开源大模型亮相!Gemini技术下放,笔记本就能跑,可商用
谷歌大模型,开源了! 一夜之间,Gemma系列正式上线,全面对外开放。 它采用Gemini同款技术架构,主打开源和轻量级,免费可用、模型权重开源、允许商用,同时笔记本可跑。 共有2B和7B两个版本,性能全面超越开源标杆Llama 2。 每种…
69 0 0