Soul App开源实时数字人生成模型SoulX-FlashTalk,实现0.87s亚秒级超低延时

近期,Soul App AI团队(Soul AI Lab)开源了实时数字人生成模型SoulX-FlashTalk 。这是首个能够实现0.87s亚秒级超低延时、32fps高帧率,并支持超长视频稳定生成的14B数字人模型。 除了在速度、效果、延…
25 0 0

近期,Soul App AI团队(Soul AI Lab)开源了实时数字人生成模型SoulX-FlashTalk 。这是首个能够实现0.87s亚秒级超低延时、32fps高帧率,并支持超长视频稳定生成的14B数字人模型。 除了在速度、效果、延…
近日,ICASSP 2026会议发出了审稿结果通知,上海交通大学跨媒体语言智能实验室共12篇论文被会议接收。我们将用两期推送介绍接收论文,本文是第一期。 01、Measuring Prosody Diversity inZero-Shot…
「 现存问题 」 用户在进行指令语音合成时,常常希望用自然语言指令控制情绪、语气、语速等风格,同时又希望用一段参考音频实现零样本音色克隆。但现实中参考音频往往会把自身的情绪与韵律一起“带进来”,文本也可能自带隐含风格,导致模型忽略指令,出现…
作为汉语分支中极具价值的重要方言,吴语承载着约 1 亿使用者的沟通需求与文化记忆,不仅保留了古汉语全浊辅音系统,更有着复杂的连读变调特征。针对吴语这一类低资源方言的语音处理,并开发稳健的语音技术仍然是一项根本性的挑战。尽管吴语在语言学上具有…
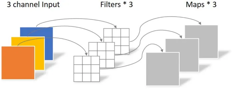
AudioCC交我学 语音增强正朝着“轻量化、高效率、低延迟”的方向快速发展。随着移动设备、实时通信和嵌入式系统对语音前端处理要求的提升,轻量级语音增强模型已成为推动技术落地的关键力量。本文将介绍轻量级模型的典型结构、设计思路与代表性方法,…
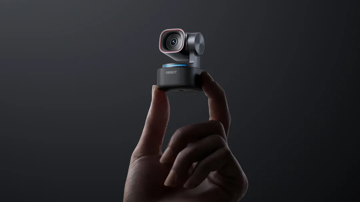
来源丨AI音频时代 OBSBOT 宣布全球发布两款全新 AI 4K 网络摄像头:Tiny 3 与 Tiny 3 Lite。 Tiny 3 系列面向内容创作者、主播、播客、远程办公、教育者等群体,为专业网络摄像头树立新标杆。 两款产品集录音室…
标题:MoE Adapter for Large Audio Language Models: Sparsity, Disentanglement, and Gradient-Conflict-Free 链接:https://arxiv.o…
白铂 博士,华为 2012 实验室理论研究部主任 信息论首席科学家 引 言 本篇是《大模型的第一性原理》系列解读文章的第二篇(点击回顾第一篇),我们将从信号处理的角度解读原论文[1]。重点探讨语义向量化背后的信号处理和信息论原理,并从时间序…
