

最新声浪
查看全部 →

AutoStyle-TTS:基于检索增强的自动风格匹配语音合成

本文由清华大学与腾讯AI Lab合作,研究基于大语言模型与检索增强生成(RAG)技术的自动语音风格匹配文本转语音合成(TTS)系统。当前主流TTS方法虽已实现高保真语音合成,但在语音风格控制方面仍依赖人工设定的提示语,难以自适应待合成文本内…
33 0 0
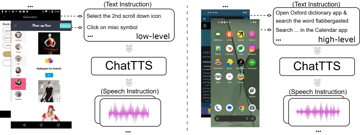
美团提出首个语音交互GUI智能体,端到端语音训练能力优于传统文本训练
GUIRoboTron-Speech团队 投稿 来源 |量子位 由美团和浙江大学联合推出的GUIRoboTron-Speech——让用户解放双手,直接对计算机“发号施令”。 联系方式:wenkangh@zju.edu.cn 论文链接:htt…
20 0 0


AI眼镜——下一代交互与私人助理入口之战,高质量数据推动AI眼镜的智能跃迁
AI眼镜的爆发与挑战 AI眼镜正从科技概念迅速走向大众消费市场,其作为穿戴式智能设备的独特优势,使其有望成为每个独立个体的私人助理,重塑人机交互的入口。近期,随着AI大模型与增强现实技术的深度融合,智能眼镜市场迎来了新的发展机遇。Meta与…
20 0 0

高效多语种ASR新方法:以音素连接语音与语言,用大语言模型替代WFST
语音与语言如何连接,机器耳朵与大脑如何高效协同?本文工作给出了探索回答。在自动语音识别(ASR)中,基于音素的多语种预训练与跨语言微调因其出色的数据利用效率和相较于基于子词模型的性能优势,正受到越来越多的关注。然而,传统的加权有限状态转换器…
32 1 0

谷歌杀疯!百万token神器免费开源,Claude和Codex都顶不住了?
来源丨新智元 谷歌扔下重磅炸弹:AI编程工具Gemini CLI,开源!免费!权限拉满!百万token上下文、千次调用额度、VS Code+终端全打通,谷歌彻底掀桌子:开发者的终端,要定了! 编程智能体,风云突变:编程智能体Gemini C…
14 0 0

Interspeech2025丨FlowSE — 基于流匹配的高效语音增强
在语音通信与人机交互场景中,噪声始终是语音质量和识别准确率的最大干扰之一。语音增强(Speech Enhancement, SE)技术旨在从嘈杂的语音中恢复出清晰、自然的干净语音,在语音通话、助听器、语音识别前端等应用中发挥着至关重要的作用…
28 0 0

离散音频 Token 全景指南:方法、评测与未来
语音是最贴近人类本质的沟通方式,不仅传达语言,还承载情感、声纹、语气与节奏,展现说话者的个性与意图。在大语言模型(LLMs)推动下,语音语言模型迅速演进。离散语音 token(Discrete Speech Tokens) 正成为构建语音表…
25 0 0

Google 现在正在测试 AI 音频片段来回答搜索查询
随着人工智能(AI)在各个领域的引入和融合,技术的发展速度可以说是非常快的。它已经从幕后工具逐渐转变为界面本身。我们见证了从只能勉强拼凑出连贯句子的聊天机器人,到能够进行完整播客对话的 AI 代理的转变,这些 AI 代理帮助人们学习、思考,…
15 0 0