 语音小管家
现有音频评测大多按“语音、环境声音、音乐”等输入类型,或“转写、分类、问答”等任务组织。这些分类便于比较模型在具体任务上的表现,却难以说明任务背后的能力需求。同样是音频问答,辨认两个相近的声音、回忆之前出现过的声音,以及根据声音顺序推断事件,分别对感知、记忆和推理提出了不同要求。把它们归入同一种任务,容易掩盖这些差异,也难以判断哪些能力尚未被充分评估。
人类认知为这个问题提供了一个有依据的出发点。人在持续变化的声音环境中,需要辨别声学线索、保留和更新信息、调用已有知识,并及时作出判断。这些能力需求贯穿不同音频类型和应用场景,也为评估面向人的音频系统提供了参照。 RAIL 因此借鉴人类认知研究建立能力分类体系,先明确需要测量的能力,再据此设计任务、组织数据和解释模型表现。
01、为什么从人类认知出发建立分类体系?
在咖啡馆里跟朋友交谈,你需要从背景声中分辨对方的话,记住前面提到的事情,把新信息与上下文联系起来,并在对话继续之前作出回应。一次自然的聆听,同时包含了感知、记忆、知识、推理和处理效率的要求。模型要在这样的场景中可靠工作,就需要接受覆盖这些要求的评估。
以“记忆”为例,记住一串口头指令与记住一段旋律,输入分别属于语音和音乐,却都要求保留随时间消逝的听觉信息。反过来,同一段语音可以用来测试转写,也可以用来测试信息更新或多步推理。音频类型、任务形式与认知能力之间,并不是一一对应的关系。 只按前两者组织评测,很难得到跨场景可比较的能力图谱。
但能力分类也需要依据。RAIL 选择了 Cattell–Horn–Carroll(CHC)认知能力框架。这一框架建立在长期的人类认知与心理测量研究之上,将广义能力进一步细分为有明确定义的狭义能力。这样的层级结构,使“听觉智能”能够被展开为具体、可设计测试的能力需求。
例如,“记忆”可以进一步区分为短时保留、工作记忆中的操作与更新,以及联结和提取等要求。对应到音频任务,就可以分别考察模型能否复述听到的序列、根据连续指令修改清单,或记住一个声音与某个对象之间的对应关系。每一项测试都因此有明确的设计目标,结果也能回到相应能力层面进行解释。
这套从能力定义出发的设计方法,还能帮助发现评测覆盖的空缺:当转写和知识问答已经得到大量测试时,非语音记忆、持续的信息更新,以及简单任务中的处理效率是否也得到了充分关注?RAIL 将这些需求纳入同一框架,使模型比较能够进一步回答:优势集中在哪里,短板出现在哪一类要求上,下一步应针对什么改进。
02、五类能力,构建一张听觉能力图谱
RAIL 将评测组织为 5 类核心能力、32 项细分能力。其中既有对声音本身的辨别,也有对声音所承载信息的保留、更新和推理。
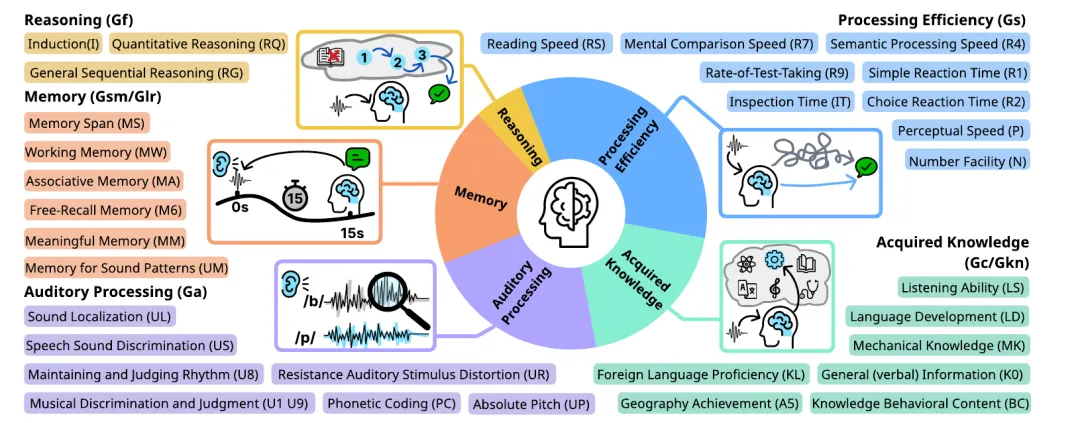
听觉处理:能否捕捉声音的细节? 这一维度覆盖音素辨别、音高、节奏、声源定位及失真条件下的识别等任务。例如,两个音素叠加出现时,模型需要判断其中分别包含什么声音;面对一段节拍,则需要识别节奏是否发生异常。
推理:能否根据听到的信息完成推断? RAIL 评估归纳、数量关系和顺序推理。例如,任务事先规定不同声音对应不同操作,模型需要依照声音出现的顺序,逐步更新一个序列,最终给出正确结果。每一步都必须衔接前一步的状态。
记忆:能否保留并更新听过的内容? 除了记住语音序列,任务还包括工作记忆、联结记忆、自由回忆及声音模式记忆。在购物清单任务中,模型需要听取连续指令,完成替换和重排,忽略无关插话,最后报告更新后的清单。
知识:能否通过声音调用相关知识? 这一维度考察模型如何把听到的内容与语言、常识及领域知识联系起来。例如,根据一段设备运行声判断其可能的功能,要求模型同时利用声音特征和机械知识。
处理效率:能否用较少的推理输出完成正确判断? 面对简单口头指令或说话人比较任务,我们关注模型在不同推理预算下能完成多少正确回答。回答正确与有效使用推理预算,共同构成这一维度的评测目标。
围绕这些任务,RAIL 构建了 5306 条样本,总音频时长约 30.6 小时,其中 68.1% 为新构建样本。数据构建经历框架选择、任务设计、数据整理及质量审核,由计算机科学与认知科学研究者共同参与,检查任务与目标能力的对应关系、音频是否足以支持作答,以及答案是否明确。
研究在统一协议下评估了 26 款音频大模型,包括 21 款开源模型和 5 款闭源模型。同时,24 位参与者完成了覆盖全部 32 项细分任务的 640 题人类评测,为分析模型的能力分布提供参照。
03、26 款模型,暴露出哪些共同短板?
总分领先,听觉处理仍有差距
在人类参与者与模型共同完成的 640 题测试子集上,6 款模型的综合表现高于人类参考水平;但在听觉处理维度,人类整体得分为 64.0,最高模型得分为 61.0。综合排名与具体能力排名,呈现出了不同的图景。
这里的人机对比采用论文设定的单次聆听、不做笔记等测试条件。模型与人类在同一题目子集上比较,结果描述的是这一条件下的表现。对于实际应用而言,更值得关注的是它揭示出的能力差异:综合成绩较高的系统,仍可能在日常听觉所需的基础环节上失分。
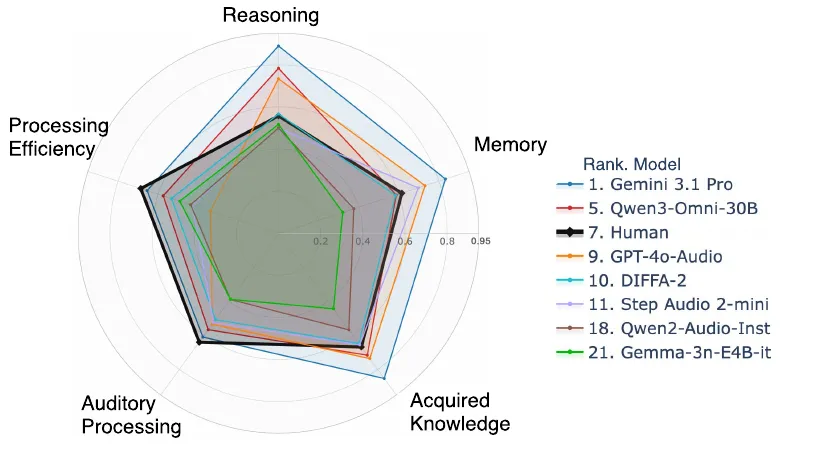
这种差异也体现在听觉处理内部。对于能够借助语言线索的任务,各任务跨模型得分中位数约为 56%—74%;对于更依赖音高、节奏和音素细节的纯感知任务,中位数约为 31%—42%。声源定位的中位数则约为 28%。
这一结果与“模型更善于利用语义线索、对精细声学信息掌握不足”的解释一致。当词义和上下文能提供帮助时,模型更容易找到答案;当任务要求直接分辨声音结构时,语言能力的优势就难以完全转化为听觉表现。
记住了说话内容,却未必记住声音本身
语音记忆与非语音记忆之间的落差,是 RAIL 中一个鲜明的发现。在完整基准的语音短时记忆任务上,Gemini 2.5 Flash 和 Gemini 3.1 Pro 的得分达到 100%,多个开源模型也超过 70%。
但在非语音声音模式记忆任务上,所有受测模型的得分都未超过 60%,最好的 Gemini 3.1 Pro 约为 59%。模型能够保留语言序列,却仍难以稳定保留和比较环境声音等非语音信息。
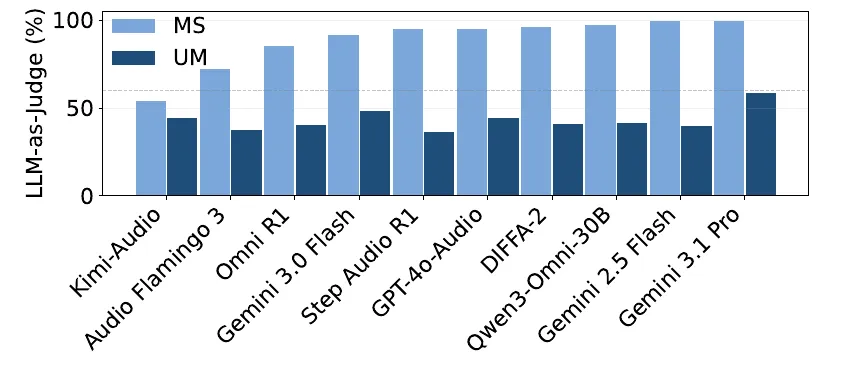
对长时音频理解而言,这个区别很关键。一次会议、一次日常对话,除了“说了什么”,还包含声音如何出现、如何变化等信息。把语言内容记住,只覆盖了听觉记忆的一部分。 因此,评估长音频能力时,语音与非语音记忆需要分别检验。
多步推理,难在持续更新状态
记住信息之后,模型能否继续沿着声音线索完成多步操作?在推理维度,顺序推理是模型的突出薄弱环节。多数受测开源模型在这类任务上的得分低于 50%。它们需要依次识别声音对应的规则、执行操作,并让后续操作建立在已经更新的结果上。
例如,任务规定咳嗽声代表交换序列首尾元素,喷嚏声代表按字母排序。模型听到两种声音后,就要按顺序执行两次操作。即使单独理解每条规则并不困难,只要其中一步状态更新错误,最终答案仍会偏离。
这类任务让我们看到,文字推理能力能否迁移到音频场景,需要直接验证。当证据以声音形式出现时,模型必须把声学识别与多步操作稳定地连接起来。延长一段解释,并不自动保证每一步都使用了正确的声音线索并且更新了正确的中间状态。
处理效率,需要与正确率一起评估
不过,答得正确就足够了吗?对一句简单指令,模型即使最终答对,也可能生成较长的推理输出。只看最终正确率,难以区分这种行为与简洁、准确的判断。RAIL 为此提出 B-AUC,汇总不同推理 token 预算下的正确率,衡量模型能否用较少的推理输出获得正确答案。
越早在较小预算内答对,B-AUC 越高。 这里的 token 数是可观测推理输出长度的代理指标,用于比较预算与正确率的关系;它与实际运行时延、硬件计算量是不同的测量对象。
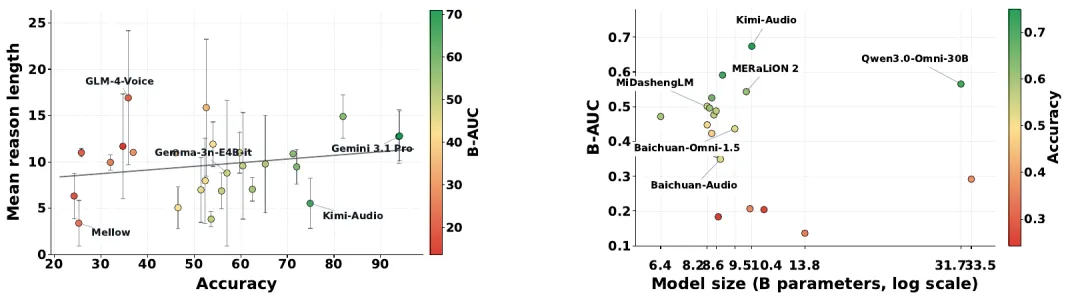
在受测模型中,正确率与推理长度的关系较弱;在 21 款开源模型中,模型参数规模与 B-AUC 也没有呈现清晰的相关关系。大小接近的模型,仍可能表现出明显不同的预算利用效率。
这提示我们,推理预算的使用方式也应成为优化目标。复杂任务需要充分推理,简单任务则应尽早给出可靠答案。对于面向交互的音频模型,评测同时观察正确率与输出行为,能够发现总分之外的改进空间。
04、面向更完整的听觉智能
这些差距,对下一代音频模型意味着什么?RAIL 提供了一套从认知能力需求出发设计任务、组织数据和解释结果的方法。通过同一张能力图谱,我们可以同时看到模型的强项,以及语义问答成绩难以揭示的感知、记忆和效率问题。
对于音频模型开发者,RAIL 提供了一个具体的判断路径:先按能力维度定位失分,再检查对应的声音输入、记忆需求和推理输出。例如,语音记忆得分高而声音模式记忆得分低时,下一步就应针对非语音记忆做专门诊断。
这些结果指向了几个具体方向:在音频前端更好地保留精细声学与空间线索;加强非语音和多轮场景下的记忆训练;让推理过程更稳定地追踪声音驱动的状态变化;把预算约束下的正确率纳入模型优化。
回到最初的咖啡馆场景,可靠的音频智能需要同时完成听清、记住、推断与回应。RAIL 希望让这些能力被分别看见、系统评估,并在后续模型中得到持续改善。
论文与资源
论文题目:RAIL:Rethinking Auditory Intelligence in Large Audio-Language Models with a CHC-Grounded Benchmark
作者:Hongyu Jin,Siyi Wang,Yang Xiao,Jiaheng Dong,Shihong Tan,Kaiyuan Peng,Georgiana Juravle,Shanquan Chen,Gongping Huang,Hong Jia,Eun-Jung Holden,James Bailey,Ting Dang
项目主页:https://aims-rail.github.io/RAIL/
论文主页:https://openreview.net/forum?id=YzcJ3C6DMn
数据集:https://huggingface.co/datasets/AnnoymousNeurLPSsubmit/RAIL