
论文解读|ConsensusBench:从结果奖励到可验证的过程监督

以 GRPO、DAPO 等算法为代表的可验证奖励强化学习(RLVR)已成为提升大语言模型推理能力的主流范式之一。这类方法仅依赖最终答案是否正确来给出二元奖励,简单、可扩展、抗奖励 hacking,却在推理链越来越长的复杂任务中表现不尽如人意…
314 0 0
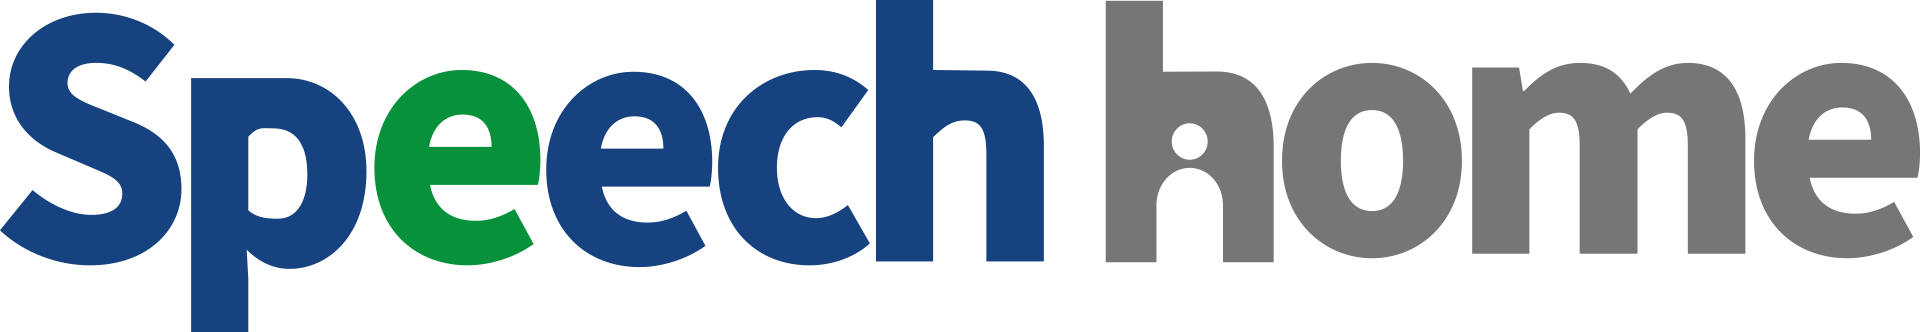
以 GRPO、DAPO 等算法为代表的可验证奖励强化学习(RLVR)已成为提升大语言模型推理能力的主流范式之一。这类方法仅依赖最终答案是否正确来给出二元奖励,简单、可扩展、抗奖励 hacking,却在推理链越来越长的复杂任务中表现不尽如人意…

第三届 Synthetic & Adversarial ForEnsics(SAFE)Workshop 将于 AAAI 2027 期间在加拿大蒙特利尔举办,现面向相关研究领域公开征稿! 我们欢迎来自语音、计算机

连续表征语音生成能够保留更丰富的韵律、音色与频谱细节,但在长文本或复杂语句合成中,现有自回归扩散模型仍容易出现说话人漂移、重复、漏读、错读和语义幻觉。如何同时兼顾长程声学一致性与语义忠实度,是连续表征零样本语音合成走向稳定应用的关键问题。…

实时语音交互最怕的,不只是“没听懂”。 更危险的是:话音刚落,系统已经执行了错误指令;几百毫秒后识别结果又改了,但动作无法撤回。 当 Voice Agent 开始控制设备、调用 API、触发工作流,ASR 输出就不能再“边猜边改”。它既要足…

把录音里说错的一个词改过来,让一句话的语气更轻松,或者去掉背景中的狗叫声,同时保留原本的人声和环境声——这些看似简单的要求,正是音频编辑需要解决的问题。 随着音频生成模型的发展,用文字描述一段声音并让模型生成出来,已经有了不少可行方案。但面…

语音助手正在从“一问一答”走向跨越多次会话的长期交互。用户上周提过的计划、某位家庭成员说过的话、某次对话时的语气,都可能在之后被问起。但语音里的信息远不止文字:谁说的、怎么说的、背景里有什么声音,都只存在于音频信号里,一旦转成文字就丢失了。…
同一句话播放两遍,内容一模一样,只是第二遍音调更高,让它挑出音调更高的那一遍。能把语音转写准确的模型,未必答得好这样的题。类似的问题还有:一段对话里有几位说话人?一段音乐的节奏有没有加快?这些任务都在提醒我们:知道“说了什么”,不等于听懂声…

Edge0 发布 Audio8-ASR-Infinite 预览版,面向中英文实时语音识别,提供 80、120 和 160ms 三档流式音频时钟,并可将转写延迟配置在 240–560ms。 模型原生上下文为 30 秒,但通过滚动 KV 缓存持…
过去一年,OpenAI、Thinking Machines Lab 等多模态团队开始把注意力从「生成更拟人的语音回答」,迈向一个更难的问题:AI 如何真正参与一场实时发生的互动。 全双工模型让智能体边听边说,全模态让语音、视觉等信息协同判断…
ESPnet 团队发布开放语音数据集 YODAS v3,收录超过 110 万小时、147 种语言的真实世界音频,全部以 48kHz 发布,其中超过 70% 包含两个及以上真正不同的音频通道。 相比此前主要面向语音识别的 YODAS,v3 加…