THUHCSI人机语音交互实验室
文章来源于THUHCSI人机语音交互实验室,作者HCSIers
从人设到音色——
基于说话人属性特征的语音合成
个性化语音生成展现出了巨大的应用前景,如虚拟人语音合成、自动配音等。除了要求合成丰富多样的语音之外,这些应用还特别期望合成的声音特点符合人们对角色的人物背景设定、外貌特征等的预期。例如,在虚拟新闻主播这类应用中,人们通常希望其声音具有沉稳庄重的特点,以保证视听觉两个模态所传达的说话人身份特质的一致性;而对于有声小说等应用,虽然没有人物画面,但是人们依旧希望依据角色的人设特点生成合适的声音,如大叔音、少年音等。
纵观各类应用场景,这些说话人具有自己独特的“人设”,是指导语音合成的参考依据。因此,本文提出基于人设,也就是说话人属性特征的信息,来合成语音,达到个性化的声音定制的目的。说话人属性特征是描述说话人生理属性和社会属性的一系列特征,如:年龄、性别、人格等。引入说话人属性特征的概念,使得面向有声小说等应用的声音定制化语音合成成为可能,用户可以设定或修改人物属性特征,从而操纵合成语音的声音特点。同时,该方法也解耦了不同因素对于声音特征的影响,使得语音的合成及定制具有可解释性。
贡献
解决方案
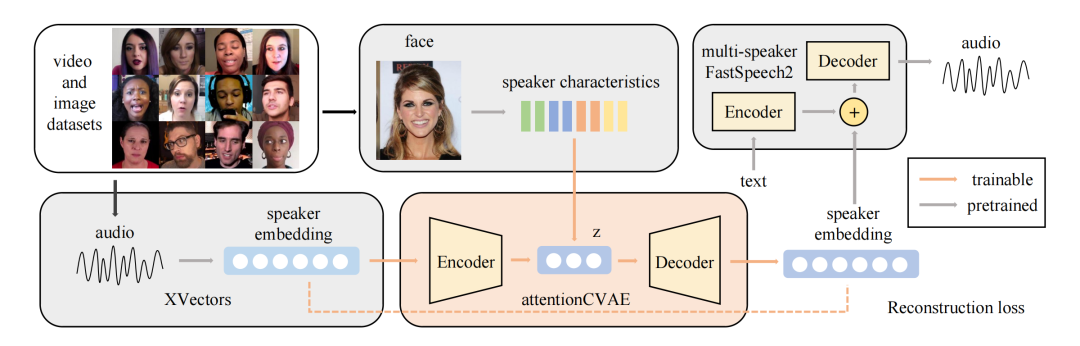
图1 基于说话人属性特征的语音合成框架
本文提出的模型结构如上图所示,它主要包括:
(1)说话人编码器Speaker Encoder;
(2)注意力条件变分自编码器attentionCVAE;
(3)基于多说话人FastSpeech2的声学模型。
说话人编码器用于从真实语音中提取说话人的声音特征(Speaker Embedding),注意力条件变分自编码器从说话人属性特征(Speaker Characteristics)生成相应的声音特征,声学模型基于说话人编码器提取的真实声音特征或注意力条件变分自编码器预测的声音特征生成符合目标属性特征的语音。
说话人编码器
说话人编码器采用XVectors架构,基于DNN结构,输入24维的声学特征,训练说话人鉴别任务。提取其中的segment7输出的隐层变量,作为说话人的声音特征。
注意力条件变分自编码器
注意力条件变分自编码器包含一个自注意力模块和一个变分自编码器。
变分自编码器可以从声音特征中抽取隐变量,并将其拟合到高斯空间。这样,利用说话人属性特征预测高斯分布的均值和方差,就可以从隐变量空间中采样出符合说话人属性特征的具有多样性的声音特征。
自注意力机制可以使得不同的属性特征信息得到不同的权重,进而融合预测得到更准确的声音特征。首先不同的属性特征通过嵌入网络对齐到相同维度的隐变量,接下来将不同的隐变量连接在一起,通过一个自注意力层,得到融合的隐变量。最后隐变量通过变分自编码器的解码器预测得到目标说话人的声音特征。
说话人属性特征
本文使用了六种不同的说话人属性特征来表征人设,分别是:1)性别;2)年龄;3)种族;4)体型,用身体质量指数BMI表示;5)脸型,我们定义脸型为脸的长宽比例;6)人格,通过大五人格测试标注,包括开放性、责任心、外倾性、宜人性和神经质性,表征为五个从0到1的连续变量。
实验验证
本文设计了不同的合成实验,以验证所提出方法的有效性,包括:1)与基线模型合成语音的音质和声音丰富性对比;2)人脸匹配实验,将合成语音与相应人脸匹配;3)属性特征匹配实验,将合成语音与相应属性特征匹配。
实验数据
与基线模型的对比实验
我们实现了3种生成式模型作为基线模型:
CGAN: 基于pix2pixHD实现的CGAN模型;
MAF:开源的MAF模型;
Face2Speech:输入为人脸,输出为相应说话人声音特征的声学模型。
为了测试本文所提的基于说话人属性特征生成语音方法的有效性,我们分别通过生成特征可视化、主观测评和客观测评对合成语音的自然度和表现力进行了比较。
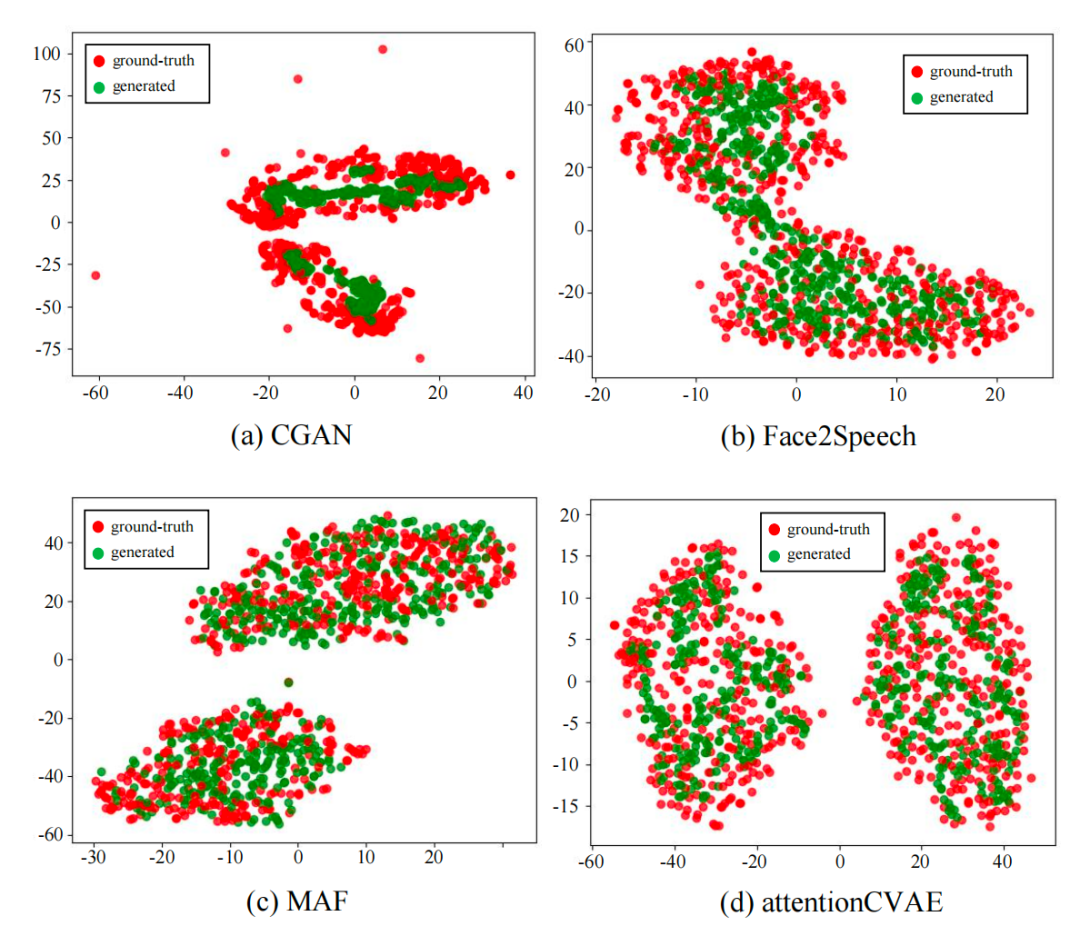
图2 不同方法在VoxCeleb2上生成的说话人声音特征tSNE降维可视化结果
attentionCVAE为本文提出方法
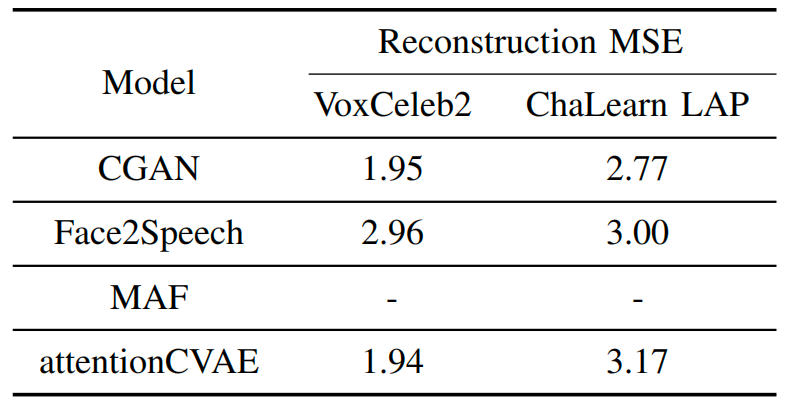
表1 在验证集上的MSE重建损失(MAF不适用)
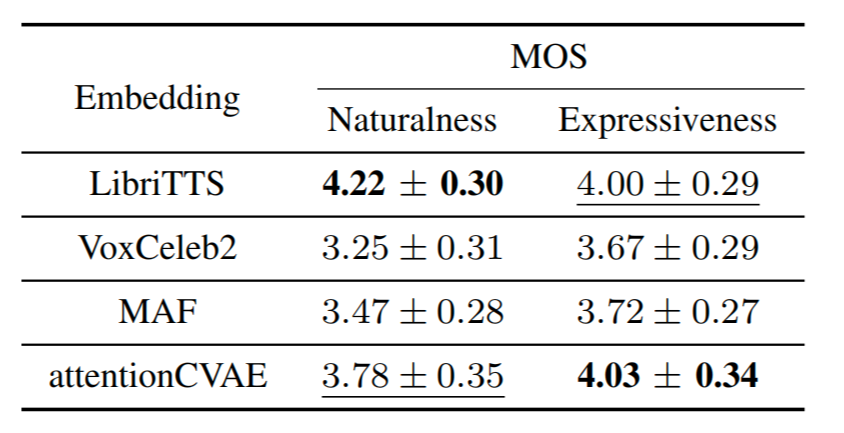
表2 自然度和表现力的主观评测实验结果
消融实验
为了验证本文所提的注意力机制和各个属性特征信息的有效性,本文进行了两项消融实验,如图3所示。首先从所提模型中去除注意力机制(-Attention),即直接连接各个属性特征变量进行预测,发现预测误差明显上升,说明了注意力机制对混合不同特征的有效性。接着分别去掉不同属性特征的输入,发现测试误差均有不同程度的上升:其中,去掉年龄、性别、体型三项,对测试误差的影响最为明显,说明这些特征与说话人声音特征的相关度较高;而种族、脸型和人格特征对预测结果影响较小。
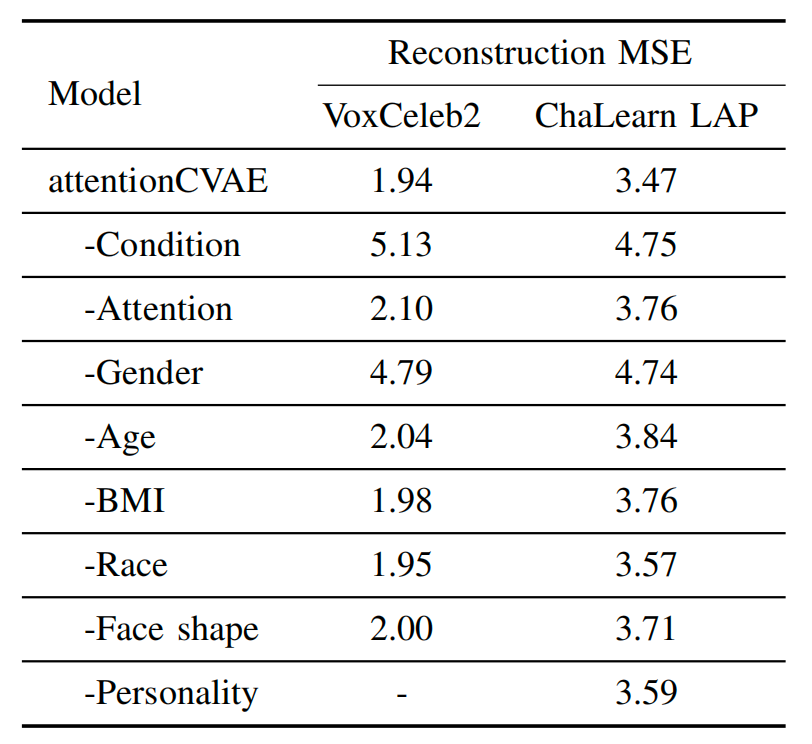
表3 消融实验测试结果
-Condition表示去掉所有属性特征输入,-Attention表示去掉注意力机制,其他表示去掉相应的属性特征输入
人脸及属性匹配实验
为了验证生成语音与说话人属性信息的匹配度,我们进行了两项主观评测实验。
(1)人脸匹配实验,给被试同时提供一张人脸图片和两条音频,分别对两条音频与人脸的对匹配度进行评分,并选择最匹配的一条音频。
(2)属性匹配实验,给被试提供一条音频和一个属性描述,如年轻、年老,被试对音频的声音特点和属性描述之间的匹配度进行打分。评分标准为1-5分,其中1表示不匹配,2表示匹配度低,3表示难以分辨,4表示匹配度高,5表示非常匹配。
实验结果如下表所示。表4表明本文所提方法生成的音频与人脸较为匹配,与真值较为接近。表5中所有分数都超过3分,表明生成语音的声音特点和说话人属性之间匹配度较高。
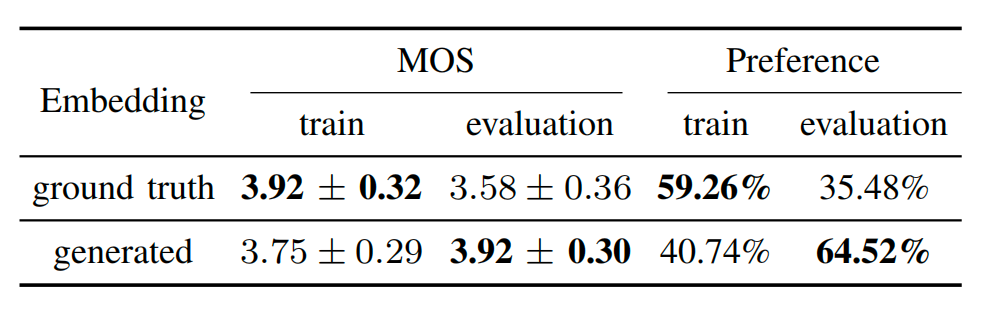
表4 人脸匹配实验评分结果
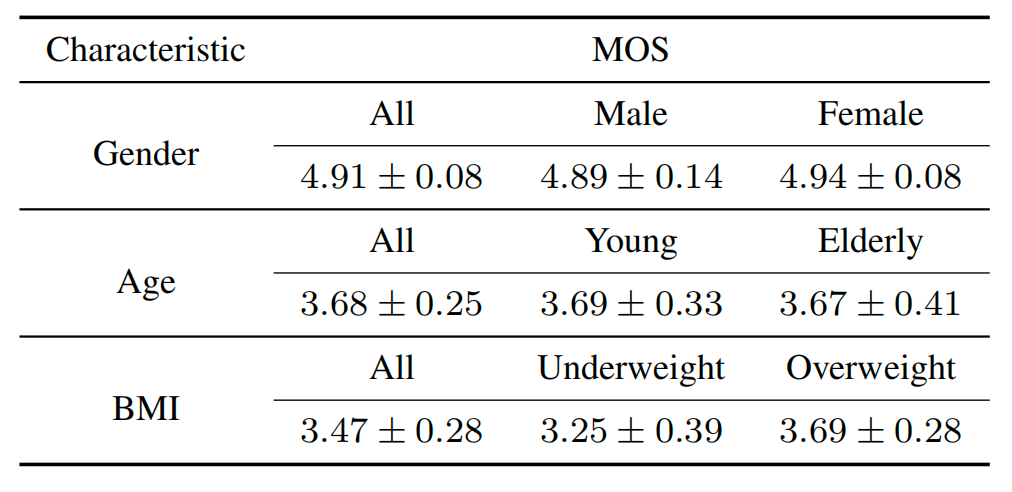
表5 属性匹配实验评分结果
样例分析
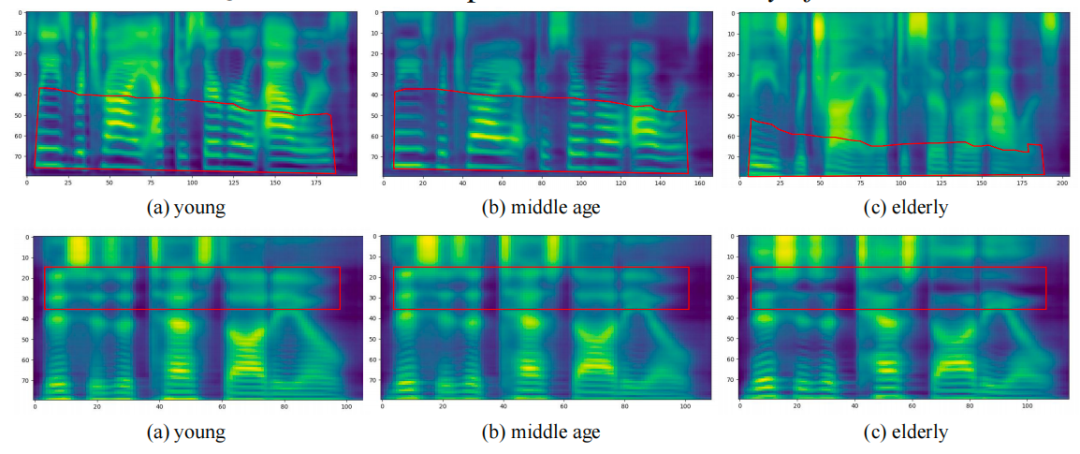
图3 不同年龄生成的同一条文本的语音频谱图(红色曲线表示基频)
第一行为女性,第二行为男性
结论
本文提出了一种新的语音合成任务,将人设映射为音色,也即基于说话人属性特征的语音合成。我们选择了6个与语音特点相关的说话人属性特征,包括性别、年龄、种族、体重指数、脸型和人格;提出了注意力条件变分自编码器模型,从不同说话人属性特征预测声音特点,然后利用其合成语音。主观评测和客观实验表明了本文方法所生成的语音具有较好的表现力和多样性。实验分析了不同的说话人属性特征与声音特点之间的相关性,如年老导致高频共鸣质量下降等。
合成样例试听请扫码 或通关下方链接
https://scgss.github.io/Speaker-Characteristics-Guided-Speech-Synthesis/