
【语音技术和应用趋势分享系列(5,6/10)】具身智能和多模态时代的交互

本系列十篇文章,旨在对之前提到的十大趋势进行详细剖析。系列中将穿插科普、技术综述、技术发展路线,以及来自我个人与其他行业专家的思考。希望不论读者此前对语音技术与应用了解多少,都能从这一系列文章中获得有价值的观点。 本篇将围绕趋势五和六——“…
62 0 0

本系列十篇文章,旨在对之前提到的十大趋势进行详细剖析。系列中将穿插科普、技术综述、技术发展路线,以及来自我个人与其他行业专家的思考。希望不论读者此前对语音技术与应用了解多少,都能从这一系列文章中获得有价值的观点。 本篇将围绕趋势五和六——“…
NVIDIA(英伟达)最近开源了最新的Nemotron Speech ASR模型。这是一款专攻低延迟、实时流式场景的语音识别模型。 做 AI 语音开发的朋友都知道,ASR(语音转文字)一直是实时交互中那块难啃的骨头。尤其是 Streamin…
标题:Index-ASR Technical Report 链接:https://arxiv.org/pdf/2601.00890 发表日期:2026年1月6号 作者单位:Artificial Intelligence Platform D…
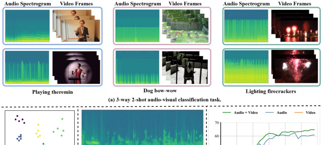
小样本视听分类(Few-Shot Audio-Visual Classification, FS-AVC)是多模态学习领域极具挑战性的任务。它要求模型在仅有极少量标注样本的情况下,通过挖掘视觉与听觉的互补信息,实现对新类别的准确识别。 然而…

来源丨新智元 2026年1月8日,智谱登陆港交所,成为全球首家以AGI基座模型为核心业务的上市公司。凭借GLM技术与MaaS商业化增长,它以「全球大模型第一股」的稀缺性吸引顶级资本加持,也标志着中国AGI企业正式走向资本市场舞台中央。 20…

来源丨新智元 文本领域的大模型满分选手,换成语音就集体挂科?大模型引以为傲的多轮对话逻辑,在真实人声面前竟然如此脆弱。Scale AI正式发布首个原生音频多轮对话基准Audio MultiChallenge,直接撕开了大模型靠合成语音评测维…

先说我的观点 如今市面上有很多类似的产品,大部分通过串联不同 API 来实现与不同形态机器的对话。这是一个已经形成多年共识的方向,也代表了人们对 AI 的终极想象——希望它能真正像人一样与我们对话。 既然如此,为什么不去开发交互能力强、能说…


来源丨机器之心、具身智能大讲堂 Gen Robot.AI团队在Hugging Face平台公开了10Kh RealOmni-Open数据集,该数据集累计包含超10000小时数据、100万+任务剪辑,存储总量达95TB,是当前行业内规模领先的…
