击败GPT、Gemini,复旦×创智孵化创业团队「模思智能」,语音模型上新了

近日,由复旦邱锡鹏担任首席科学家的模思智能发布了多说话人自动语音识别(ASR)模型 MOSS-Transcribe-Diarize,不但可以语音转文字,还可以将音频片段与对话中不同的说话者关联起来,性能超过了 GPT-4o、Gemini、豆…
53 0 0

近日,由复旦邱锡鹏担任首席科学家的模思智能发布了多说话人自动语音识别(ASR)模型 MOSS-Transcribe-Diarize,不但可以语音转文字,还可以将音频片段与对话中不同的说话者关联起来,性能超过了 GPT-4o、Gemini、豆…
标题:Unifying Speech Recognition, Synthesis And Conversion With Autoregressive Transformers 链接地址:https://arxiv.org/pdf/260…
标题:FlashLabs Chroma 1.0: A Real-Time End-to-End Spoken Dialogue Model with Personalized Voice Cloning 链接:https://arxiv.o…
来源丨新智元 最新综述首次系统探讨LLM控制机器人的安全威胁、防御机制与未来挑战,指出LLM的具身鸿沟导致其在物理空间可能执行危险动作,而现有防御体系存在逻辑与物理脱节等问题。 具身智能正在经历从实验室走向真实世界的范式转移。 大语言模型(…
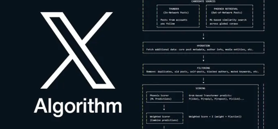
来源丨算法进阶、赛博禅心 就在刚刚,马斯克正式宣布开源 𝕏(原 Twitter)平台的推荐算法代码。 开源地址:https://github.com/xai-org/x-algorithm
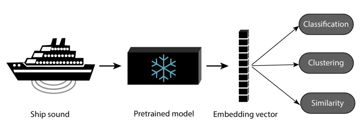
海洋越来越“吵”。货轮、集装箱船、拖网渔船的低频轰鸣叠加成持续背景声,被广泛部署的被动声学监测(PAM)系统悉数录入。全球已有数百套PAM系统全年无休地记录海底声音,但由于高质量船舶录音标注稀缺,大量数据难以有效分析。 如何在标注船舶录音稀…


标题:Speech-Hands: A Self-Reflection Voice Agentic Approach to Speech Recognition and Audio Reasoning with Omni Perception…
就在最近,一个名为NovaSR的开源项目在开源社区里炸开了锅。一款仅有 52 KB 的音频超分辨率模型。 NovaSR可以把电话音质(16kHz)瞬间变成录音室级的 Hi-Fi 音质(48kHz),而且速度快到单张 A100 能跑出 360…
