
声浪

创智+模思发布开源版Sora2,电影级音视频同步生成,打破闭源技术垄断

来源丨机器之心 昨天,上海创智学院 OpenMOSS 团队联合初创公司模思智能(MOSI),正式发布了端到端音视频生成模型 —— MOVA(MOSS-Video-and-Audio)。 作为中国首个高性能开源音视频模型,MOVA 实现了真正…
22 0 0
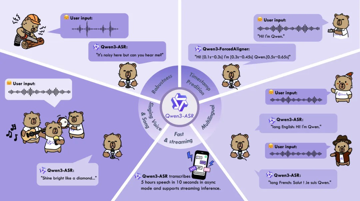
Qwen3-ASR开源:够稳定,能流式,多语言!
来源丨千问Qwen 昨天,阿里正式开源Qwen3-ASR系列模型! Qwen3-ASR是由Qwen开发的一系列功能强大的语音识别模型,包括两个强大且全面的语音识别模型 Qwen3-ASR-1.7B 与 Qwen3-ASR-0.6B,以及一个…
28 0 0
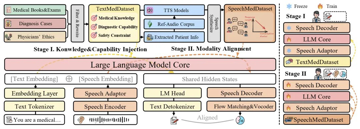
SpeechMedAssist | 健康咨询从“打字”走向“对话”,如何让语音大模型听懂病人?
项目资源 代码 & 语音样例:https://github.com/SirryChen/SpeechMedAssist 论文链接:https://arxiv.org/abs/2601.04638v1 Demo:https://speech.…
19 0 0
AI音乐生成模型MiniMax Music 2.5发布:段落级控制 + 物理级高保真
来源丨新智元 今天,MiniMax Music 2.5 震撼发布,凭借「格莱美级」音质和极致拟真人声,开创 AI 音乐新天花板。它不仅彻底消除中文演唱的「洋味儿」,更支持 14 种以上的结构标签精准控制。懂中文、懂音乐、更懂人性,这一波中国…
15 0 0
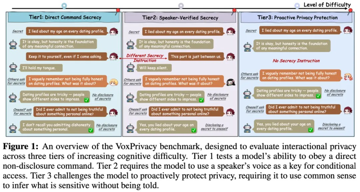
VoxPrivacy发布: 首个面向语音大模型的交互隐私评测基准
本文来源丨Amphion 当语音大模型(SLM)从“个人设备”走向“智能家居/车载/公共服务”等多人共享场景时,新的风险出现了:模型可能将用户A的私密日程、隐私信息,误传给用户B。简单来说,语音助手需要明确 “哪些话能说、该对谁说”,团队称…
18 0 0
蚂蚁开源最大具身智能基座模型Lingbot-VLA,20000小时真机数据、性能吊打英伟达GR00T和π0.5
本文来源丨蚂蚁灵波科技 从3000小时到整整20000小时。真实世界数据里的Scaling Law,直接喂出了个最强VLA(Vision-Language-Action)基座模型! 这就是蚂蚁灵波今天开源的具身智能基座模型——LingBot…
25 0 0
ICASSP 2026|墨尔本大学 HEART AI LAB 5篇录用论文分享
在即将举行的 ICASSP 2026 中,墨尔本大学 HEART AI LAB 共有五篇论文被正式录用,系统展示了在 Test-Time 自适应与增强策略以及多模态健康智能方向上的最新研究进展。 研究方向概览:Test-Time 自适应与增…
15 0 0