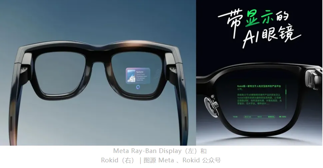
语音 AI 公司 Sesame 再获 2.5 亿美元融资,对话式AI眼镜内嵌“情商”语音助手

来源丨RTE开发者社区、首席智能官 由 Oculus 联合创始人创立的 AI 公司「Sesame」宣布完成由红杉资本 (Sequoia Capital) 和 Spark 共同领投的 2.5 亿美元 B 轮融资。 该公司正致力于构建一个极具表…
27 0 0

来源丨RTE开发者社区、首席智能官 由 Oculus 联合创始人创立的 AI 公司「Sesame」宣布完成由红杉资本 (Sequoia Capital) 和 Spark 共同领投的 2.5 亿美元 B 轮融资。 该公司正致力于构建一个极具表…
10月18日下午,NCMMSC-CNVSRC 2025 学术研讨会在江苏镇江召开的第二十届全国人机语音通讯学术会议(NCMMSC 2025)上举行。会上公布了本次视觉语音识别竞赛 CNVSRC 2025 的最终结果,并举行了颁奖仪式。 本次…
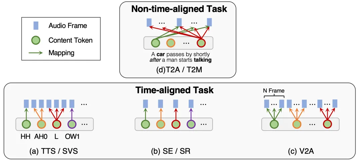
UniFlow-Audio: Unified Flow Matching for Audio Generation from Omni-Modalities 作者:徐薛楠¹,梅嘉豪²⁵,郑子豪¹²,陶也¹²,谢泽宇³,张耀匀²,刘濠赫⁴,吴…
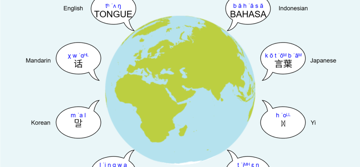
无论是中文的粤语、闽南话、吴语,还是欧洲的荷兰比尔茨语方言、法国奥克语,亦或是非洲和南美的地方语言,方言都承载着独特的音系与文化记忆,是人类语言多样性的重要组成部分。然而,许多方言正在快速消失,语音技术如果不能覆盖这些语言,势必加剧数字鸿沟…
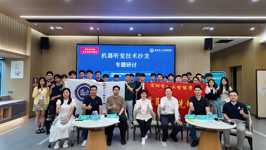
2025年10月20日下午,由深圳市科学技术协会指导,深圳市人工智能学会主办,深圳市人工智能学会机器人智能系统专业委员会和语音之家联合承办,深圳市华睿欣能投资控股集团有限公司支持的“机器听觉技术沙龙”在南山区智慧广场D栋二楼咖啡厅圆满举办。…
来源丨量子位 Qwen版深度研究加速进化,一觉起来增加了听觉和视觉输出: 可以生成网页和音频了。 AI深度研究整合的内容,变成图文并茂的网页,还可以一键部署,任何人可凭链接查看,方便对外展示。 长篇文字内容也可以变成音频播客,方便自己在碎片…
全长度歌曲生成(Lyrics-to-Song Generation)任务的目标是根据输入的歌词和风格提示生成一首完整的歌曲,包括人声和伴奏。该任务涵盖了歌声合成、歌词建模和音乐生成,挑战性极大。近年来,随着深度生成模型的发展,歌词驱动的歌曲…
