吴恩达评AI Agents现状!

来源丨InfoQ 前几天,吴恩达与 LangChain 联合创始人 Harrison Chase 展开了一场对话,而这场对话的背景,正是当前 AI 领域既充满机遇又挑战重重的一个现实。 视频链接:https://www.youtube.co…
23 0 0

来源丨InfoQ 前几天,吴恩达与 LangChain 联合创始人 Harrison Chase 展开了一场对话,而这场对话的背景,正是当前 AI 领域既充满机遇又挑战重重的一个现实。 视频链接:https://www.youtube.co…
来源丨新智元 智源研究院发布开源模型Video-XL-2,显著提升长视频理解能力。该模型在效果、处理长度与速度上全面优化,支持单卡处理万帧视频,编码2048帧仅需12秒。 长视频理解是多模态大模型关键能力之一。尽管OpenAI GPT-4o…
Interspeech 是由国际语音通讯协会组织的语音处理领域旗舰国际会议,作为全球最大的综合性语音处理领域的科技盛会,历届Interspeech会议都备受全球学术界和工业界的广泛关注。第26届Interspeech大会将于2025年8月1…
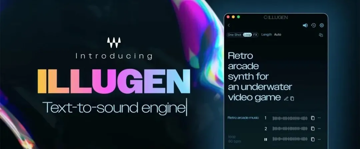
来源丨AI音频时代 Waves Audio 宣布推出AI驱动的生成式声音生成软件 IlluGen,这是一款新的桌面文本到声音生成器应用程序,可以从文本提示中创建独特的单音、音乐采样以及音效。 人工智能(AI)和订阅制模式是两个容易引发声音人…
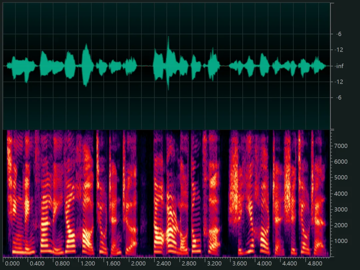
音频快速去重(音频去重检测)是一项重要任务,尤其在音频内容管理、语音数据清洗、音乐平台内容审核等场景中非常有价值。其目标是在大规模音频库中快速识别出重复或近似重复的音频段。常用的音频去重算法,大致可以分为三大类:1是我们前面介绍过的音频指纹…
阿里开源 QwenLong-L1 长文本推理模型,其 32B 参数版本在七个长上下文文档问答基准测试中表现优异,相较于 DeepSeek-R1-Distill-Qwen-32B 平均提升 7.8%,超过 OpenAI-o3-mini、Qwe…
异常声音检测(Anomalous Sound Detection,ASD)是指在仅知道机器正常工作声音的前提下,判断待测机器声音是否存在异常。近期,清华大学联合上海交通大学、华北电力大学等单位,提出了一种面向工况属性信息不完备场景的自适应原…
