第二届语音对话与听觉处理前沿进展研讨会参会者征集通知

为了更好地推动语音对话与听觉处理领域的深入交流与前沿研究,由中国计算机学会(CCF)语音对话与听觉专委会现向全社会业界同仁征集第二届语音对话与听觉处理前沿进展研讨会(RASDAP2025, Recent Advances on Speech…
15 0 0

为了更好地推动语音对话与听觉处理领域的深入交流与前沿研究,由中国计算机学会(CCF)语音对话与听觉专委会现向全社会业界同仁征集第二届语音对话与听觉处理前沿进展研讨会(RASDAP2025, Recent Advances on Speech…
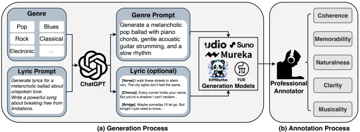
近年来,AI 作曲与歌声合成技术突飞猛进,但如何像人类一样评价一首“AI 歌曲”的美感始终是一大难题。现有客观指标往往忽视旋律记忆点、情感连贯性等主观维度,导致模型优化方向失焦。 为此,西工大音频语音与语言处理研究组(ASLP@NPU)与上…
中国西北工业大学科研团队在深海远程水声通信领域取得进展,成功研发自适应簇稀疏贝叶斯学习(ACSBL)信道估计算法及时延-多普勒域Turbo均衡器(DD-TEQ),并在南海海域试验中实现324.9公里和595.1公里的深海无差错通信。这一成果…
语音合成(TTS)技术近十年来突飞猛进,从早期的拼接式合成和统计参数模型,发展到如今的深度神经网络与扩散、GAN等先进架构,实现了接近真人的自然度与情感表达,广泛赋能智能助手、无障碍阅读、沉浸式娱乐等场景。 然而,这一繁荣几乎局限于英语、普…
北航刘偲教授团队创新性地提出了语言引导的细粒度无人机轨迹控制研究框架,将无人机根据简短指令执行短距反应式飞行的任务定义为Flying-on-a-Word(Flow)范式。 论文链接:https://arxiv.org/abs/2505.15…
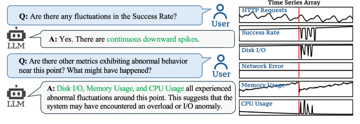
该工作由字节跳动 ByteBrain 团队 × 清华大学合作完成。第一作者为清华大学三年级博士生谢哲,主要研究方向为时序多模态 LLM、异常检测和根因定位。第二作者和第三作者分别为李则言和何晓,均来自字节跳动。通讯作者分别为字节跳动研究科学…
来源丨夕小瑶科技说 当前具身智能研发正面临“双重枷锁”:一方面,真机验证成本高、仿真偏差大,制约策略验证效率;另一方面,海量真机数据尚未构建基于轨迹扩增的高效利用机制,导致数据未被充分利用,制约了模型的持续进化。为打破这一困局,智元机器人在…
